
LLM ou modelo de decisão: qual aguenta decisão em tempo real em checkout, antifraude e fila?

Em decisão em tempo real (checkout, antifraude, roteamento de fila), o modelo de decisão ganha do LLM. Segundo a Respan, gradient-boosted trees e redes neurais respondem em milissegundos de um dígito e custam uma fração de uma chamada de LLM. O Stripe Radar decide em menos de 100 ms avaliando mais de 1.000 características. Na avaliação da Respan, os LLMs levaram cerca de 4 s por prompt (5,9 s no claude-haiku), além de baterem em limites por organização e erros 429 e 529 no pico. O LLM ainda serve fora do caminho crítico, de forma assíncrona
Fala aí, beleza? Em checkout, antifraude e fila, a decisão tem prazo de milissegundos e o LLM chega em segundos
E mesmo assim tem muita gente colocando um LLM bem no meio do caminho crítico, justo naquela decisão que precisa sair antes do usuário piscar
Dá pra entender a tentação, né? O LLM entende contexto, explica o raciocínio, parece mais esperto e tal
Só que decisão em tempo real é outro jogo: o que manda é quanto a resposta demora, quantas decisões tu consegue tomar ao mesmo tempo e o que acontece quando o tráfego explode
Então bora comparar as duas abordagens nesses três pontos: latência percebida, concorrência e comportamento sob pico de requisições 😀
LLM vs modelo de decisão: latência, concorrência e custo lado a lado
Antes de entrar no detalhe, se liga no quadro geral com os números que dá pra confirmar nas fontes:

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
| Critério | Modelo de decisão | LLM via API |
|---|---|---|
| Latência por decisão | Um dígito em milissegundos (gradient-boosted trees ou redes neurais, segundo a Respan); o Stripe Radar decide em menos de 100 ms avaliando mais de 1.000 características | Cerca de 4 s por prompt nos modelos maiores e 5,9 s no claude-haiku, nessa avaliação específica da Respan |
| Custo por decisão | Uma fração pequena de uma chamada de LLM, segundo a Respan | Uma chamada de LLM inteira a cada decisão |
| Limites de uso | Não passa por cota de API de LLM | Claude: RPM, ITPM e OTPM por organização; OpenAI: RPM, RPD, TPM, TPD e outras métricas, por organização e projeto |
| Comportamento sob pico | Sem 429 ou 529 de API de terceiro no caminho | Erro 429 ao estourar o limite; no Claude, também 529 (overloaded_error) quando a API está sobrecarregada |
Os dados de latência do modelo de decisão e do LLM vêm do estudo da Respan sobre LLMs em antifraude, e o número do Radar vem da página do próprio Stripe Radar
Repara numa coisa: os 4 s e os 5,9 s são da avaliação da Respan, não uma lei universal de todo LLM
Mas a ordem de grandeza já conta a história toda: milissegundos de um lado, segundos do outro
Latência percebida: onde cada abordagem cai na régua do Nielsen?
O Jakob Nielsen tem uma régua clássica de limites de tempo de resposta, lá do livro Usability Engineering:
- até 0,1 s: parece instantâneo
- até 1 s: o usuário percebe o atraso, mas o fluxo de pensamento não se interrompe
- até 10 s: é o limite pra manter a atenção
Agora encaixa as duas abordagens nisso
O modelo de decisão, com inferência na casa de um dígito de milissegundos, fica folgado dentro do 0,1 s: o usuário nem sabe que teve uma decisão ali
O LLM da avaliação da Respan, com 4 s ou 5,9 s, passa do 1 s e cai na faixa em que o usuário já está esperando e olhando pra tela
Ou seja: não quebra a atenção de vez, mas deixa MUITO claro que algo está travando a experiência
Onde ver a latência atual dos LLMs?
Latência de LLM muda o tempo todo, então não vale cravar um número fixo e confiar nele pra sempre
A Artificial Analysis mede latência como TTFT (tempo até o primeiro token, em segundos) e usa as medições das últimas 72 horas
Em modelos de raciocínio, ela conta o primeiro token de raciocínio, então fica de olho nisso ao comparar
E TTFT é só o começo da resposta: a decisão completa ainda precisa da resposta inteira gerada… 🙂
O que acontece com o LLM no pico de requisições (erros 429 e 529)
Latência média é uma coisa, pico é outra completamente diferente
É no pico que o LLM no caminho crítico costuma mostrar a conta
Sintoma:
Chega a Black Friday, aquela campanha que bombou, e as chamadas ao LLM começam a falhar com erro 429 ou 529
O checkout trava, a fila empilha e ninguém entende por que funcionava lindo no teste haha
Causa:
No Claude, a documentação de rate limits explica que o uso é limitado por organização, conforme o tier, em três métricas: requisições por minuto (RPM), tokens de entrada por minuto (ITPM) e tokens de saída por minuto (OTPM)

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →Passou de qualquer uma delas, a API devolve 429 com o header retry-after
E tem um detalhe que pega muita gente: o limite é aplicado com o algoritmo token bucket
Que token bucket? É um balde de capacidade que vai sendo reposto de forma contínua, em vez de zerar numa janela fixa de um minuto
Na prática, um limite de 60 RPM pode ser aplicado como 1 requisição por segundo, então uma rajada curta já pode gerar 429 mesmo sem tu ter feito 60 chamadas no minuto
Tome cuidado com a gambiarra clássica: criar mais API keys não aumenta o limite, porque ele vale por organização e não por chave
Além disso, a API da Anthropic devolve 529 (overloaded_error) quando está temporariamente sobrecarregada por tráfego alto de todos os usuários
Esse aí nem depende de você: é o pico do mundo inteiro batendo junto com o seu
Na OpenAI, a documentação de limites mede RPM, RPD, TPM, TPD e outras métricas, por organização e projeto, variando por modelo, e vale o que estourar primeiro
O exemplo da própria documentação é ótimo: com limite de 20 RPM, 20 requisições de 100 tokens já esgotam o limite, mesmo com o TPM de 150k ainda livre
Ou seja, decisão curta e em volume bate no limite de requisições muito antes do de tokens
Solução:
Tirar o LLM do caminho síncrono da decisão
Os SDKs oficiais da OpenAI repetem automaticamente as requisições que falharam por rate limit e respeitam o Retry-After quando ele vem na resposta
Isso é massa pra tarefa assíncrona, mas se liga: retry é espera somada em cima de espera
Num orçamento de 100 ms, não existe espaço pra esperar o Retry-After e tentar de novo
Como prevenir:
- dimensionar pelo pico, não pela média de tráfego
- manter a decisão crítica num modelo que roda sem cota de terceiro
- deixar pro LLM só o que pode ir pra uma fila e esperar
Checkout, antifraude e roteamento de fila: onde o tempo de resposta elimina o LLM
Agora vamos pros casos concretos, um por um
Antifraude: por que o teto é 100 ms?
Porque a checagem de fraude acontece no meio do pagamento, e o cliente está esperando ali
Segundo a Aerospike, a detecção de fraude precisa terminar em menos de 100 ms pra não criar atraso perceptível no checkout
E o Stripe Radar mostra que dá pra fazer isso avaliando mais de 1.000 características de uma transação em menos de 100 ms
Um LLM levando segundos, como na avaliação da Respan, nem chega perto desse teto
Checkout: quanto tempo o cliente espera sem perceber?
Pela régua do Nielsen, até 0,1 s
Qualquer espera acima disso deixa de parecer instantânea, e o cliente começa a notar que algo está acontecendo
Segundos de LLM no meio do botão de pagar travam a compra justo no momento mais sensível do funil
É aquele tipo de atraso que ninguém reclama no teste e todo mundo sente em produção 😛
Roteamento de fila: por que o volume derruba o LLM?
Aqui o problema é menos o tempo de uma decisão e mais a quantidade delas
Roteamento é decisão por item: cada ticket, pedido ou mensagem que entra precisa ir pro lugar certo
Se cada item vira uma chamada de LLM, cada item consome uma requisição do balde
No Claude, que aplica os limites com token bucket, um limite de 60 RPM pode valer como 1 requisição por segundo, então uma fila recebendo vários itens por segundo começa a acumular 429
Na OpenAI o mecanismo documentado é outro, mas o efeito no volume é parecido: pelo exemplo da própria documentação, requisições pequenas esgotam o RPM antes de chegar perto do limite de tokens

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Onde o LLM ainda cabe?
Fora do caminho crítico, de forma assíncrona
Alguns use cases que fazem sentido:
- revisar casos que o modelo de decisão marcou como suspeitos
- gerar uma explicação legível de por que uma decisão foi tomada
- analisar padrões depois do fato, sem ninguém esperando na tela
Nesses cenários, segundos de resposta e até um retry não atrapalham ninguém
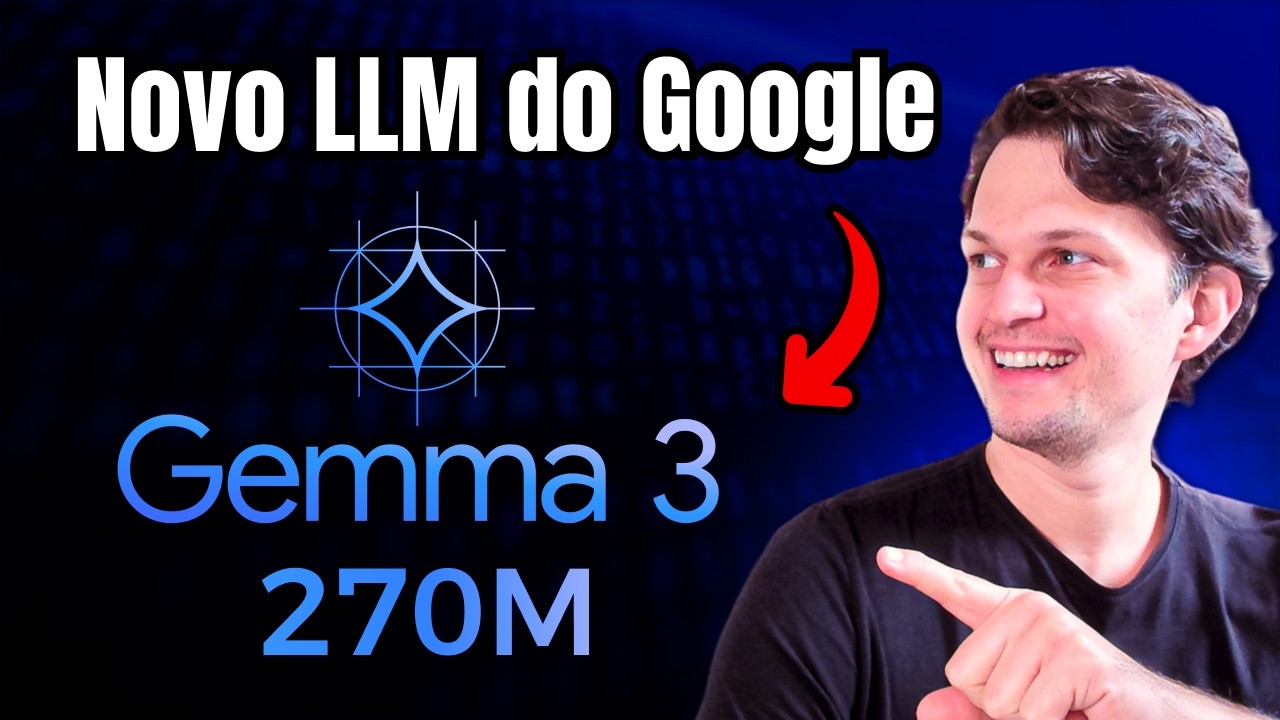
E os modelos pequenos? O que o Gemma3 270m mostra sobre esse limite
Aí tu pensa: beleza, e se eu usar um LLM bem pequeno pra tentar reduzir latência e custo?
Foi mais ou menos essa curiosidade que me levou a testar o Gemma3 270m
No vídeo eu mostro o processo todo: baixei o modelo usando o Ollama e rodei localmente, sem depender de uma interface web tipo a do ChatGPT
Dá pra encontrar o modelo tanto num site de biblioteca de modelos quanto direto na busca do Ollama, é só copiar o nome e colar na ferramenta
Comparando as opções disponíveis, a versão com muito mais parâmetros provavelmente nem rodaria numa máquina comum, aí só com PC da Nasa haha
O que aconteceu com o prompt vago?
Quando testei com um prompt vago (crie um artigo de N8N para explicar o software), o modelo criou um artigo genérico, sem nem citar o N8N
Refiz com um prompt bem mais específico, pedindo um artigo de 1000 palavras sobre N8N, explicando o que é, pra que serve e com um exemplo de agente de IA
Aí sim ele entregou o conteúdo certo sobre o tema
A lição que eu tirei: modelo pequeno exige prompt bem definido e sem ambiguidade, senão ele alucina ou foge totalmente do assunto
O que isso tem a ver com decisão em tempo real?
Modelo pequeno é uma tentativa válida de chegar mais perto de resposta rápida e barata
Porém, ele vem com a limitação que eu vi na prática: se a entrada for ambígua, ele pode fugir do assunto
Numa decisão que precisa ser confiável a cada requisição, isso é um risco a mais pra tu medir com calma
Outra opinião minha: aqueles gráficos de benchmark que aparecem na documentação costumam ser tendenciosos, então o certo é ignorar e testar na prática se o modelo resolve o SEU problema
Na minha visão, vale usar esses modelos pequenos quando a máquina é mais fraca, quando não pode ter conexão com internet, ou quando a resposta precisa ser rápida e a tarefa é repetitiva e bem definida
Pra começar do zero com modelos pequenos, este vídeo do canal mostra como baixar, rodar e testar o Gemma3 270m na prática:
Veredito: quem decide em tempo real e onde o LLM entra
Decisão síncrona abaixo de 100 ms fica com o modelo de decisão
É o que os grandes processadores de pagamento fazem, segundo a Respan: gradient-boosted trees ou redes neurais treinadas com centenas de milhões de transações
O LLM perde nas três frentes:
- latência: segundos contra milissegundos
- concorrência: limites por organização, token bucket, 429 e 529 no pico
- custo: uma chamada inteira contra uma fração dela por decisão
Mas o LLM não sai do jogo: ele ganha papel em tudo que tolera segundos e roda de forma assíncrona
E se a ideia é deixar a saída mais previsível, vale olhar a discussão sobre trocar o prompt por decisão tipada
Critério simples pra levar daqui: se a resposta precisa sair antes do usuário perceber (0,1 s), o LLM está fora
Conclusão
Decisão em tempo real em checkout, antifraude e fila pede milissegundos, e o modelo de decisão entrega isso com folga
O LLM, pelos dados da Respan e pelos limites documentados de Claude e OpenAI, fica melhor longe do caminho síncrono
O próximo passo é bem prático:
- mapear quais decisões do teu sistema estão no caminho síncrono
- medir o orçamento de latência de cada uma
- consultar o TTFT atual na Artificial Analysis antes de sequer cogitar um LLM ali
Faça o teste no seu sistema, é bem provável que apareça alguma decisão crítica pendurada num LLM sem ninguém ter percebido 😀
Até o próximo post!
Perguntas frequentes
Quanto tempo um LLM leva para responder numa decisão de checkout?
Na avaliação da Respan, os modelos maiores levaram cerca de 4 segundos por prompt e o claude-haiku levou 5,9 segundos, nessa avaliação específica. Isso já passa longe da faixa de milissegundos que um modelo de decisão tradicional entrega
Dá pra usar LLM em antifraude em tempo real durante o checkout?
Segundo a Aerospike, a detecção de fraude precisa terminar em menos de 100 ms pra não criar atraso perceptível no checkout. Um LLM que leva segundos por prompt não entra nesse orçamento, então ele acaba ficando melhor como camada de apoio fora do caminho síncrono da decisão
Por que a API do Claude retorna erro 429 mesmo sem estourar o limite por minuto?
Porque o Claude aplica os limites com o algoritmo token bucket, que repõe capacidade de forma contínua em vez de zerar numa janela fixa. Por isso um limite de 60 RPM pode funcionar na prática como 1 requisição por segundo, e uma rajada curta já gera 429
Qual a diferença entre o erro 429 e o erro 529 na API da Anthropic?
O 429 aparece quando a sua organização passa de algum limite de RPM, ITPM ou OTPM. Já o 529 (overloaded_error) acontece quando a API da Anthropic está temporariamente sobrecarregada por tráfego alto vindo de todos os usuários, não só do seu uso
Criar mais API keys resolve o problema de rate limit no Claude?
Não. No Claude, os limites valem por organização e não por chave, então multiplicar API keys não aumenta a cota disponível
Qual o tempo máximo que uma decisão pode levar sem o usuário perceber atraso?
Pela régua de Jakob Nielsen, até 0,1 s a resposta parece instantânea e até 1 s o fluxo de pensamento do usuário não se interrompe, mesmo que ele note o atraso. Um modelo de decisão com inferência em milissegundos fica dentro dessa primeira faixa, enquanto um LLM de alguns segundos já ultrapassa a segunda
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
O que é um LLM e como ele funciona por dentro (explicado para devs)
O que é LLM? Entenda como esses modelos de linguagem funcionam por dentro: tokens, contexto, treino e inferência, explicado para devs.
Como escolher o modelo LLM certo para o seu projeto: checklist de decisão
Guia pra escolher o modelo LLM certo: contexto, custo por token, latência e open source. Veja critérios e preços atualizados pra decidir sem erro.
Como calcular o custo por decisão antes de trocar o LLM por um classificador próprio
Aprenda a calcular o custo por decisão LLM antes de trocar por classificador próprio: tokens, cache, batch e ponto de equilíbrio.
