
Como escolher o modelo LLM certo para o seu projeto: checklist de decisão

Pra escolher o modelo LLM certo, passe por cinco critérios nesta ordem: contexto, custo por token, latência, suporte a ferramentas e modelo aberto ou API fechada. Contexto já não separa tanto: Claude Opus, Sonnet e Haiku 5.5 têm 1M de tokens, e o GPT-6.1 Sol tem 1.050.000. A diferença está no preço: o Haiku 5.5 sai por US$ 0,10/US$ 0,50 por milhão até 100 mil tokens, e o Opus 5.5 por US$ 4/US$ 20. Para dado sensível, modelos abertos como Gemma 4 (Apache 2.0) e DeepSeek V4 Pro (MIT) entram no jogo
Fala aí, beleza? Se tu tá montando um projeto com IA, cedo ou tarde bate a dúvida clássica: qual modelo eu uso? 🙂
Não existe o melhor modelo LLM, existe o modelo certo pro seu caso
Hoje vários modelos de ponta já trabalham com janela de 1M de tokens (Claude Opus, Sonnet e Haiku 5.5, GPT-6.1 Sol, DeepSeek V4 Pro), então tamanho de contexto deixou de ser o grande diferencial
A decisão de verdade mora em outras perguntas: quanto custa cada token, quanto tempo dá pra esperar a resposta, se o modelo chama ferramentas direito e se faz sentido rodar um modelo aberto ou usar uma API fechada
Então montei um checklist em ordem, critério por critério, depois uma tabela comparativa lado a lado, um teste na prática e, no fim, um veredito por tipo de projeto
Bora ver?
Checklist de decisão: como avaliar cada critério na ordem certa
A ordem aqui não é à toa
Um critério puxa o outro: o contexto que tu escolhe no passo 1 já mexe na conta do passo 2, e o custo do passo 2 conversa direto com a latência do passo 3
Passo 1: de quanto contexto o seu projeto precisa?
E o que é contexto? É tudo que o modelo consegue "enxergar" de uma vez: o prompt, os documentos, o histórico da conversa e a própria resposta
Pensa numa mesa de trabalho: quanto maior a mesa, mais papel cabe aberto ao mesmo tempo

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
O primeiro movimento é estimar o tamanho típico do que entra (documento, código, histórico) e do que sai, e comparar com a janela de cada candidato:
- Claude Opus 5.5, Sonnet 5.5 e Haiku 5.5: 1M de tokens de contexto e até 128 mil tokens de saída
- GPT-6.1 Sol e GPT-6 Sol: 1.050.000 tokens de contexto e até 128.000 de saída
- DeepSeek V4 Pro: 1 milhão de tokens
- Gemma 4: até 256K tokens
- Qwen3-235B-A22B: depende da variante, o modelo base tem 32.768 tokens nativos (131.072 com YaRN) e o Instruct-2507 tem 262.144 nativos, extensível a cerca de 1.010.000
Ou seja: se o seu caso é chat curto ou classificação, qualquer um deles sobra
Se é análise de contrato gigante ou base de código inteira, aí o filtro começa a pesar, principalmente no lado dos modelos abertos
Erro comum deste passo: escolher pelo maior contexto achando que ele sai de graça
Não sai! Prompt longo muda o preço em alguns modelos (no Haiku 5.5 acima de 100 mil tokens e no GPT-6.1 Sol acima de 272 mil), e é exatamente isso que o passo 2 mostra
Passo 2: quanto custa cada token de entrada e de saída?
Preço de modelo LLM é sempre cobrado por milhão de tokens e SEMPRE separado em duas partes: entrada (o que tu manda) e saída (o que o modelo gera)
E alguns modelos ainda têm faixas por tamanho de prompt, se liga:
- Claude Haiku 5.5: US$ 0,10 por milhão de entrada e US$ 0,50 de saída em prompts de até 100 mil tokens, e US$ 0,50 de entrada e US$ 2,50 de saída acima disso
- GPT-6.1 Sol: US$ 2 de entrada e US$ 10 de saída em prompts de até 272 mil tokens, e acima disso a requisição inteira passa a US$ 4 de entrada e US$ 15 de saída
No caso do Haiku, a própria Anthropic conta que cerca de 90% das requisições ao Haiku anterior ficavam abaixo de 100 mil tokens, então a maioria dos usos tende a cair na faixa mais barata
Além do preço de tabela, tem as alavancas de desconto, que fazem MUITA diferença no fim do mês:
- API do Claude: economia de até 90% com prompt caching e de 50% com batch processing
- API do Gemini: modo Flex com 50% de desconto, Batch com 50% e Caching com 90% de desconto mais o armazenamento proporcional dos tokens
Agora, como estimar a conta de verdade? Medindo uma resposta real
A conta é simples:
custo = (tokens de entrada / 1.000.000 x preço de entrada)
      + (tokens de saída / 1.000.000 x preço de saída)
Mais pra frente, na seção prática, eu conto meu teste com o Odysseus AI (uma ferramenta que roda IA no PC): configurei o GPT via chave de API, pedi uma função de validar CPF em JavaScript e a resposta gastou 368 tokens
É esse tipo de número que tu precisa: pega uma tarefa real do teu projeto, vê quantos tokens ela consome e multiplica pelo volume esperado
Erro comum deste passo: olhar só o preço de entrada
Em todos os modelos de API do comparativo mais abaixo, a saída custa bem mais caro que a entrada, então projeto que gera muito texto pesa justamente onde ninguém olhou primeiro
Passo 3: qual latência o seu projeto aceita?
Latência é quanto tempo o usuário (ou o seu sistema) espera pela resposta
Um chatbot de atendimento não pode ficar travado, já um relatório que roda de madrugada pode demorar o quanto quiser
Os provedores tratam isso de jeitos diferentes:
- Claude Haiku 5.5: a Anthropic indica ele pra tarefas de alto volume e sensíveis a latência
- GPT-6.1 Sol no modo Ultrafast: US$ 12 por milhão de entrada e US$ 60 de saída
- Gemini no modo Priority: de 75% a 100% a mais que o preço Standard
Repara que velocidade extra custa caro, o Ultrafast do GPT-6.1 Sol sai 6x mais que o preço normal de contexto curto
O caminho honesto é medir no seu caso

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →Erro comum deste passo: pagar pelo modo rápido num job que poderia rodar em batch com 50% de desconto
Se ninguém tá esperando a resposta na tela, provavelmente tu não precisa de velocidade, precisa de preço
Passo 4: o modelo tem suporte a ferramentas (tool use / function calling)?
Se o seu projeto é um agente, ou seja, a IA precisa consultar banco, chamar API, buscar na web e por aí vai, esse critério vira eliminatório
Tool use (ou function calling) é a capacidade do modelo de pedir pra executar uma função em vez de só responder texto
No Claude, o modelo pode chamar funções definidas por você ou fornecidas pela Anthropic, e existem dois tipos:
- Client tools: rodam na sua aplicação
- Server tools:
web_search,web_fetch,code_executionetool_search, que rodam na infraestrutura da Anthropic
O ciclo das client tools funciona mais ou menos assim (visão conceitual, não é código de SDK):
1. Você envia a mensagem junto com a definição das ferramentas
2. O Claude responde com stop_reason "tool_use" dizendo qual função quer chamar
3. O seu código executa a função de verdade
4. Você devolve o resultado como tool_result
5. O Claude usa esse resultado pra montar a resposta final
Repara no detalhe: quem executa é o SEU código, o modelo só pede
No lado aberto, o Gemma 4 tem function calling nativo, saída JSON estruturada e system instructions, e as ferramentas são passadas como JSON schema ou como funções Python
Erro comum deste passo: assumir que todo modelo aberto chama ferramentas do mesmo jeito
Não chama! Confere o suporte modelo a modelo antes de montar o agente em cima dele, senão tu descobre isso com o projeto já pela metade (e aí é dor de cabeça garantida haha)
Passo 5: modelo aberto ou API fechada?
Aqui a pergunta é menos técnica e mais de negócio: onde o seu dado pode ir e quanto controle tu precisa
Os modelos abertos verificados pra este post:
- DeepSeek V4 Pro: licença MIT, MoE de 1,6T de parâmetros com 49B ativos, contexto de 1 milhão de tokens, pesos no Hugging Face em deepseek-ai/DeepSeek-V4-Pro
- Gemma 4: do Google DeepMind, licença Apache 2.0, em quatro tamanhos (E2B, E4B, 26B MoE e 31B Dense), com entrada de texto e imagem
- Qwen3-235B-A22B: licença Apache 2.0, da Alibaba Cloud
Que MoE? É Mixture of Experts: o modelo é enorme no total, mas só uma parte dos parâmetros trabalha em cada token, por isso o DeepSeek tem 1,6T no total e 49B ativos
Modelo aberto faz sentido quando:
- O dado é sensível e não pode sair de casa
- Tu precisa de controle e customização
- O projeto precisa funcionar offline
API fechada faz sentido quando tu quer a conveniência de não manter infraestrutura nenhuma: chama o endpoint, paga pelo uso e pronto
Erro comum deste passo: confundir modelo "grátis" com custo zero
Os pesos podem ser abertos, mas rodar local tem custo de máquina, e dependendo do tamanho do modelo tu vai precisar de um PC da Nasa xD
Comparativo de modelos LLM: preço, contexto e licença lado a lado
Juntei tudo numa tabela só, com os preços por milhão de tokens (entrada/saída):
| Modelo | Tipo | Preço entrada/saída (por milhão) | Contexto | Observação |
|---|---|---|---|---|
| Claude Opus 5.5 | API (Anthropic) | US$ 4 / US$ 20 | 1M | Programação agêntica de longa duração e trabalho intelectual |
| Claude Sonnet 5.5 | API (Anthropic) | US$ 2 / US$ 10 | 1M | Meio-termo de custo na linha Claude |
| Claude Haiku 5.5 | API (Anthropic) | US$ 0,10 / US$ 0,50 até 100K; US$ 0,50 / US$ 2,50 acima | 1M | Alto volume e sensível a latência |
| GPT-6.1 Sol | API (OpenAI) | US$ 2 / US$ 10 até 272K; US$ 4 / US$ 15 acima | 1.050.000 | Ultrafast a US$ 12 / US$ 60 |
| GPT-6 Astra | API (OpenAI) | US$ 10 / US$ 50 | Não informado | Topo de linha da OpenAI |
| Gemini 3.8 Flash | API (Google) | US$ 0,75 / US$ 3,75 promocional até 31/12/2026; US$ 1,50 / US$ 7,50 a partir de 01/01/2027 | Não informado | Preço promocional com data pra acabar |
| Gemini 3.5 Flash | API (Google) | US$ 1,50 / US$ 9,00 (Standard) | Não informado | Flex e Batch com 50% de desconto |
| DeepSeek V4 Pro | Aberto (MIT) | Não informado | 1M | MoE de 1,6T, 49B ativos |
| Gemma 4 | Aberto (Apache 2.0) | Não informado | Até 256K | Function calling nativo, texto e imagem |
| Qwen3-235B-A22B | Aberto (Apache 2.0) | Não informado | 32.768 no base; 262.144 no Instruct-2507 | Instruct-2507 extensível a cerca de 1.010.000 |
Lendo a tabela: o contexto praticamente empatou entre os grandes de API, então o que separa um do outro é preço e propósito
E a diferença de preço é absurda, a saída do Opus 5.5 custa 40x a saída do Haiku 5.5 na faixa curta, por isso a escolha do modelo pesa tanto no custo final

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Na prática: o que muda ao rodar um modelo LLM aberto no seu PC
Teoria é massa, mas rodar modelo local na vida real tem umas surpresas
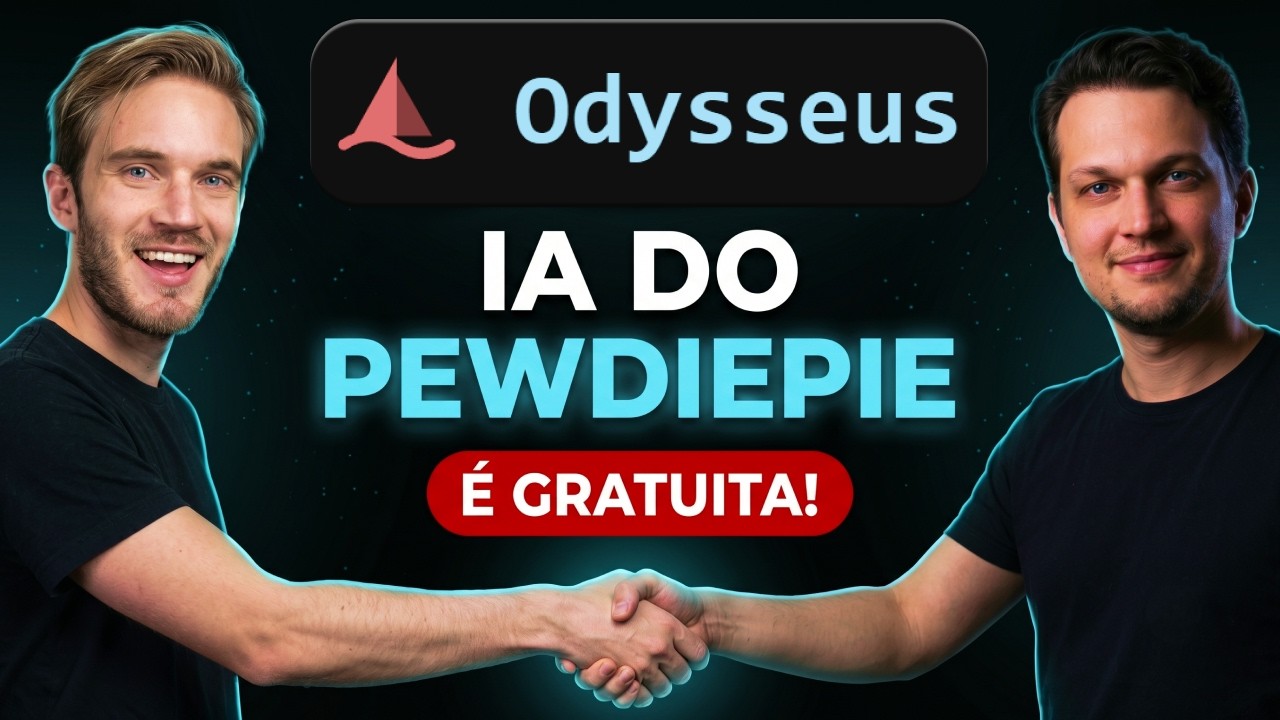
Testei isso com o Odysseus AI, uma ferramenta que roda IA no PC, e vou te contar o que funcionou e o que não funcionou, ligando com o checklist
Configuração local não foi plug and play: minha primeira tentativa foi configurar um modelo local via Ollama dentro do Odysseus, e de início não consegui fazer funcionar
Plano B foi a nuvem: como alternativa, configurei o GPT via chave de API (a ferramenta não aceitava login por assinatura, só API key)
Aí pedi pelo chat uma função de validação de CPF em JavaScript, só pra ver o comportamento básico, e a resposta gastou 368 tokens
Esse é o contraponto do passo 2: na nuvem tu paga por token, e dá pra medir cada resposta
Modo agent: também testei o modo agent pedindo uma landing page simples em HTML/CSS, comparando com um agente de código tipo Claude Code ou Codex
Cookbook ajuda a escolher o modelo local: a ferramenta tem uma função de cookbook que analisa o hardware da máquina e sugere quais modelos locais rodariam bem ou não, mostrando coisas como janela de contexto e número de parâmetros
Isso conversa direto com o passo 5: modelo aberto depende da SUA máquina
Depois o local funcionou: consegui rodar um Gemma de 12B via Ollama dentro da ferramenta, mas comparando com o que o Ollama puro já entregaria, não vi novidade nesse quesito específico
Latência foi o ponto fraco: a geração de resposta ficou bem lenta nesse teste local
Meu palpite é que pode ter a ver com o ambiente (eu estava no Windows, e acho que no Mac ou no Linux poderia rodar melhor), mas é palpite, não conclusão
Resumindo minha opinião: a ideia do sistema é boa, mas ainda tem arestas pra aparar, principalmente em performance e velocidade de resposta, e vale esperar o projeto evoluir antes de um veredito final
Pro checklist, a lição é clara: modelo local te dá privacidade e controle, mas a latência passa a ser problema TEU, não do provedor
No vídeo abaixo eu mostro todo esse teste, da tentativa com Ollama até o modelo local respondendo:
Qual modelo LLM escolher: veredito por tipo de projeto
Agora juntando tudo, o veredito por perfil de projeto, sempre justificado pelo checklist
Chatbot ou classificação em alto volume: qual modelo usar?
Vai de Claude Haiku 5.5
A Anthropic indica ele pra alto volume e tarefas sensíveis a latência, e prompt curto cai na faixa mais barata (US$ 0,10 / US$ 0,50 por milhão até 100 mil tokens)
Outra opção é o Gemini 3.8 Flash no preço promocional de US$ 0,75 / US$ 3,75, mas tome cuidado: a partir de 01/01/2027 ele passa a US$ 1,50 / US$ 7,50, então faz a conta já pensando no preço novo
Agente de código e tarefas longas: qual modelo usar?
Claude Opus 5.5, que é indicado oficialmente pra programação agêntica de longa duração
Se o custo apertar, o Sonnet 5.5 é o meio-termo: metade do preço do Opus (US$ 2 / US$ 10) com a mesma janela de 1M
Análise de documentos longos: qual modelo usar?
Aqui entram os modelos de 1M de contexto (linha Claude 5.5, GPT-6.1 Sol, DeepSeek V4 Pro)
O cuidado é com o salto de preço: no Haiku 5.5 acima de 100 mil tokens e no GPT-6.1 Sol acima de 272 mil, onde a requisição inteira fica mais cara
Se tu manda o mesmo documento várias vezes, caching é obrigatório: até 90% de economia no Claude e 90% de desconto (mais armazenamento) no Gemini
Processamento em lote sem pressa: qual modelo usar?
Qualquer modelo que tenha batch, o critério aqui é o modo, não o modelo
Batch dá 50% de desconto tanto no Claude quanto no Gemini, e no Gemini ainda tem o Flex com os mesmos 50%
Dado sensível, uso offline ou customização: qual modelo usar?
Modelo aberto
Gemma 4 pros tamanhos menores, com function calling nativo e licença Apache 2.0
DeepSeek V4 Pro (MIT, 1 milhão de contexto) ou Qwen3-235B-A22B (Apache 2.0) quando tu precisa de escala e contexto maior
Só lembra do passo 5 e do meu teste: a máquina e a latência ficam por tua conta
Quando precisa do máximo e o custo importa menos: qual modelo usar?
GPT-6 Astra (US$ 10 / US$ 50, o topo de linha da OpenAI) ou Claude Opus 5.5 (US$ 4 / US$ 20)
E se tá em dúvida entre os dois, o melhor jeito é colocar os dois pra resolver a mesma tarefa num teste lado a lado entre modelos dentro do seu próprio projeto
Conclusão: comece barato, meça e só depois suba de modelo
Escolher modelo LLM se resume a cinco perguntas: quanto contexto eu preciso, quanto pago por token, quanto posso esperar, se preciso de ferramentas e se meu dado pode sair de casa
O próximo passo é bem prático: pega uma tarefa real do projeto, roda no modelo mais barato que passa no checklist, mede os tokens de entrada e saída de uma resposta e faz a conta mensal com os preços da tabela
Só sobe de modelo se o barato não der conta, beleza?
E fica esperto: preço e modelo mudam o tempo todo (o próprio Gemini 3.8 Flash já tem data pra mudar de preço), então vale revisar essa escolha de tempos em tempos
Até o próximo post! 😀
Perguntas frequentes
Qual modelo LLM é mais barato pra projeto de alto volume?
O Claude Haiku 5.5 é o mais barato da lista, custando US$ 0,10 por milhão de tokens de entrada e US$ 0,50 de saída em prompts de até 100 mil tokens
A própria Anthropic indica ele pra tarefas de alto volume e sensíveis a latência, e cerca de 90% das requisições ao Haiku anterior ficavam dentro dessa faixa mais barata
Modelo LLM aberto como DeepSeek V4 Pro vale a pena no lugar de API fechada?
Depende do que tu precisa: o DeepSeek V4 Pro é um MoE de 1,6T de parâmetros (49B ativos), licença MIT, contexto de 1 milhão de tokens e pesos disponíveis no Hugging Face
Já o Qwen3-235B-A22B é Apache 2.0, com a variante Instruct-2507 chegando a 262.144 tokens nativos, extensível a cerca de 1.010.000
Abertos dão controle total sobre onde rodar, mas tu assume a infraestrutura, enquanto a API fechada já vem com o serviço pronto
Contexto longo deixa o modelo LLM mais caro?
Sim, em alguns modelos existe uma faixa de preço separada pra prompt longo
No Claude Haiku 5.5 isso acontece acima de 100 mil tokens, e no GPT-6.1 Sol acima de 272 mil tokens de entrada a requisição inteira passa a US$ 4 de entrada e US$ 15 de saída por milhão
Qual modelo LLM a Anthropic indica pra programação agêntica de longa duração?
A Anthropic indica o Claude Opus 5.5 pra programação agêntica de longa duração e trabalho intelectual
Ele custa US$ 4 por milhão de tokens de entrada e US$ 20 de saída, com a mesma janela de 1M de tokens e até 128 mil de saída que o Sonnet 5.5 e o Haiku 5.5 também têm
O modelo LLM Gemma 4 do Google suporta function calling?
Suporta, o Gemma 4 tem function calling nativo, saída JSON estruturada e system instructions
As ferramentas são passadas como JSON schema ou como funções Python, e o modelo vem em quatro tamanhos (E2B, E4B, 26B MoE e 31B Dense) sob licença Apache 2.0, com contexto de até 256K tokens e entrada de texto e imagem
Como funciona o desconto de batch processing entre os modelos LLM?
Na API do Claude, o batch processing dá até 50% de economia, e o prompt caching chega a 90%
Na API do Gemini existe o mesmo tipo de alavanca: o modo Batch também dá 50% de desconto e o modo Caching chega a 90% mais o armazenamento proporcional dos tokens
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
O que é um LLM e como ele funciona por dentro (explicado para devs)
O que é LLM? Entenda como esses modelos de linguagem funcionam por dentro: tokens, contexto, treino e inferência, explicado para devs.
O que significa LLM? Os dois sentidos da sigla e como saber qual é qual
O que significa LLM? Entenda os dois sentidos da sigla: Large Language Model (IA) e Master of Laws (Direito), e como diferenciar pelo contexto.
LLM: significado de cada palavra da sigla e o que isso revela sobre os limites da IA
LLM significado: entenda Large Language Model e o que 'large', 'language' e 'model' revelam sobre os limites reais da IA.
