
LLM: significado de cada palavra da sigla e o que isso revela sobre os limites da IA

O significado de LLM é Large Language Model (modelo de linguagem grande): um sistema de IA treinado em enormes volumes de texto para prever o próximo token, geralmente com arquitetura Transformer. Cada palavra da sigla explica um limite. ‘Large’ indica que escala (parâmetros, dados e computação) melhora a qualidade, mas o equilíbrio entre modelo e dados pesa tanto quanto o tamanho. ‘Language’ indica que ele aprende padrões de texto, não fatos, e por isso pode inventar com fluência. ‘Model’ indica que ele só enxerga o que está no contexto, e a informação no meio de um contexto longo é pior aproveitada
Fala aí, beleza? Se tu já pegou o ChatGPT inventando uma data com toda a confiança do mundo, ou o Claude ‘esquecendo’ algo que você falou lá no começo da conversa, esse post é pra você 🙂
Entender o que cada palavra de LLM significa explica MUITO do porquê a ferramenta inventa, esquece e varia de qualidade
A sigla não é só um nome bonito: é praticamente um manual de limites
E isso vale pra tudo que você usa no dia a dia: ChatGPT, Claude, Microsoft Copilot, Gemini, Meta AI… todos são produtos baseados em LLM
Bora destrinchar palavra por palavra?
De onde vem o LLM: Transformer e previsão do próximo token
LLM é a sigla de Large Language Model, ou modelo de linguagem grande, em bom português

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
Na prática, é um sistema de IA treinado em quantidades enormes de texto pra fazer basicamente uma coisa: estimar a probabilidade do próximo token, dado tudo que veio antes
Pensa no autocompletar do teclado do celular, só que turbinado ao extremo
Mas que token?
Token é o pedacinho de texto que o modelo processa, que pode ser uma palavra, parte de uma palavra ou um sinal de pontuação
A regra prática, em inglês, é de cerca de 4 caracteres por token (mais ou menos 3/4 de uma palavra)
Em português não existe uma proporção oficial, então não vou chutar número aqui haha
E o Transformer, onde entra?
A arquitetura que está por baixo da maioria dos LLMs é o Transformer, apresentada em 2017 no artigo Attention Is All You Need, de Ashish Vaswani e outros 7 pesquisadores do Google (publicado na NeurIPS 2017)
A grande sacada do artigo: um modelo baseado só em mecanismos de atenção, sem recorrência e sem convoluções
Atenção, de forma bem simplificada, é o jeito do modelo olhar pro texto anterior e pesar quais partes importam mais na hora de prever o próximo pedaço
Guarda essa ideia, porque ela é a chave do post inteiro: tudo que vem depois (as alucinações, a dependência de contexto, a diferença de qualidade entre modelos) deriva dessa previsão do próximo token
O que significa ‘Large’ em LLM e por que escala muda a qualidade
O ‘Large’ se refere ao número muito alto de parâmetros, que vai de bilhões a centenas de bilhões, combinado com grandes volumes de dados de treino
E o que é parâmetro?
São valores internos do modelo que vão sendo ajustados durante o treinamento
Se você já mexeu numa mesa de som, imagina bilhões de botõezinhos sendo calibrados até o som sair certo… é mais ou menos isso 😀
Leis de escala: maior costuma ser melhor
Em janeiro de 2020, Kaplan e colegas (OpenAI e Johns Hopkins) publicaram as leis de escala dos modelos de linguagem
O achado: a perda do modelo (o quanto ele erra na previsão) cai seguindo uma lei de potência conforme aumentam o tamanho do modelo, o volume de dados e a computação de treino
E essa tendência se manteve ao longo de mais de sete ordens de grandeza, o que é absurdo
Traduzindo: escala muda qualidade, e muda de forma previsível
Chinchilla: maior não é automaticamente melhor
Só que em 2022 a DeepMind jogou um balde de água fria no ‘é só aumentar’ com o Chinchilla
Eles treinaram um modelo de 70 bilhões de parâmetros com 1,4 trilhão de tokens, usando o mesmo orçamento de computação do Gopher, que tinha 280 bilhões
Resultado? O menor ganhou
| Modelo | Parâmetros | Orçamento de computação | MMLU (média) |
|---|---|---|---|
| Chinchilla | 70B | Mesmo do Gopher | 67,5% |
| Gopher | 280B | Referência | Mais de 7 pontos abaixo do Chinchilla |
O Chinchilla ficou mais de 7 pontos acima no MMLU com 4 vezes menos parâmetros
A conclusão do estudo: tamanho do modelo e quantidade de dados devem crescer na mesma proporção
Ou seja, o ‘Large’ importa, mas dado e equilíbrio importam tanto quanto
Modelo pequeno na prática: o que o Gemma3 270m mostra sobre o ‘large’

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →Agora bora pro lado oposto da escala: o que acontece quando o modelo é bem pequeno?
Eu testei o Gemma3 270m rodando localmente pelo Ollama, sem depender de uma interface web tipo o ChatGPT
O processo foi simples: copiei o nome do modelo na página de busca e colei no Ollama pra baixar
Na hora de olhar as opções disponíveis, optei por não baixar a versão maior, porque ela não ia rodar numa máquina normal (ali já é coisa de PC da Nasa haha)
Prompt vago: o modelo foge do tema
O primeiro teste foi com um prompt bem genérico: ‘crie um artigo de N8N para explicar o software’
E o modelo simplesmente saiu do tema, chegando a nem mencionar o N8N na resposta xD
Prompt específico: aí ele entrega
Refiz o teste com um prompt muiiito mais detalhado: um artigo com tamanho definido, explicando o que é N8N, para que serve e com um exemplo de agente de IA
Dessa vez ele executou a tarefa certinho
Outra coisa que percebi: às vezes o modelo muda de idioma no meio da resposta, um comportamento que eu associo a modelos com menos parâmetros
O que isso ensina sobre escala
Lembra das leis de escala da seção anterior? Aqui dá pra sentir na pele o que menos parâmetros significam
Modelo pequeno exige prompt bem coordenado e com escopo bem definido, senão a resposta foge do que foi pedido e ele mais atrapalha do que ajuda
Mas tem cenário onde ele brilha: empresas que não permitem software conectado à internet, por exemplo, onde um modelo menor viabiliza o uso de IA sem comprometer o hardware
Tome cuidado com um detalhe: dependendo da máquina, até um modelo pequeno pode não rodar bem ou demorar demais pra responder, e aí o uso fica inviável (vale entender tokens por segundo e latência antes de botar algo assim pra rodar)
E os gráficos comparativos que saem junto com o modelo? Na minha opinião tendem a ser tendenciosos, o ideal é ignorar e testar na prática
Isso vale pra qualquer lançamento: quando a página oficial de um modelo não responde o que você precisa, o teste no seu caso de uso é o que decide
Minha recomendação: teste bem esses modelos pequenos antes de colocar em produção
No vídeo abaixo eu mostro o teste completo, do download no Ollama aos prompts vago e específico:
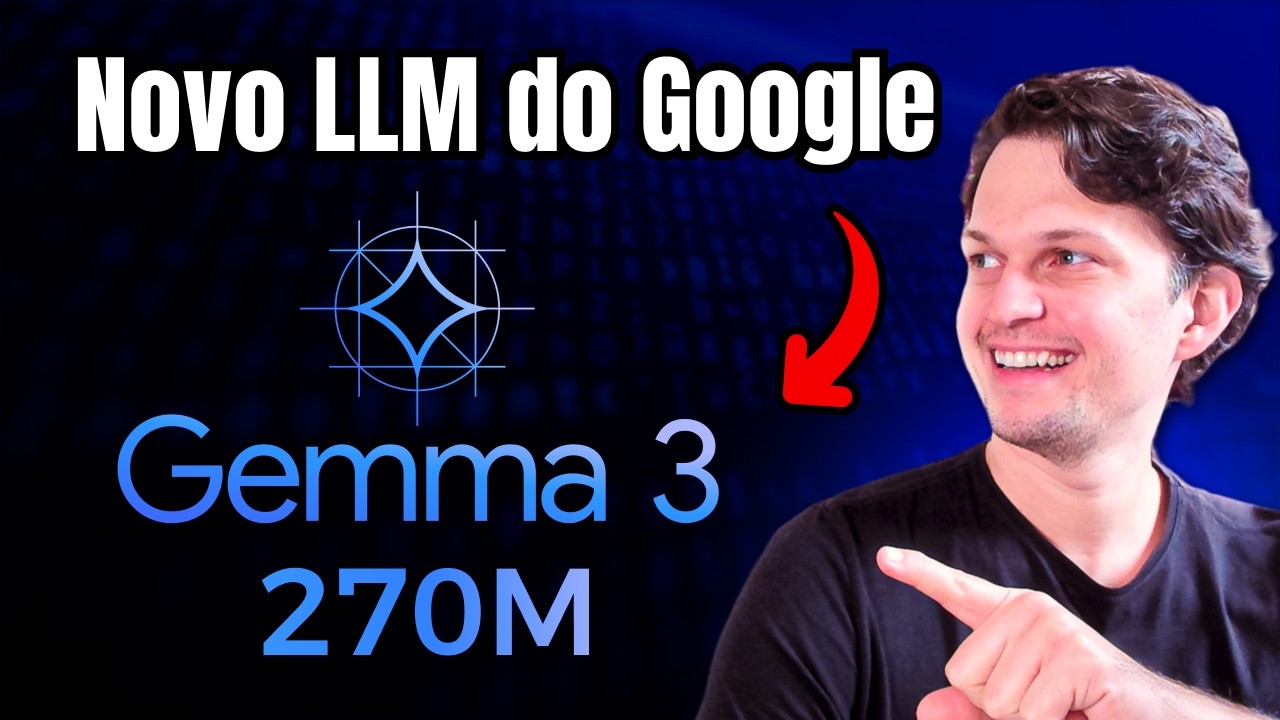
Não estou dizendo que o Gemma3 270m é simplesmente melhor ou pior que outros modelos
O valor dele depende do prompt ser bem definido e do caso de uso ter escopo limitado: aí você foge do hardware pesado dos modelos maiores, mas aceita que ele erra fácil quando o pedido é vago
O que significa ‘Language’: por que o LLM inventa respostas
O ‘Language’ é onde mora a pegadinha mais perigosa
O modelo aprende padrões de linguagem, não uma base de fatos
Ele gera texto plausível, que soa certo, e plausível não é sinônimo de verdadeiro
Por que ele chuta em vez de dizer ‘não sei’?
Um artigo da OpenAI de 2025, o Why Language Models Hallucinate (Kalai, Nachum, Vempala e Zhang), dá uma explicação bem interessante
O argumento: os procedimentos de treino e avaliação recompensam chutar em vez de admitir incerteza
O exemplo deles é ótimo, se liga:
- Se o modelo não sabe o aniversário de alguém e chuta uma data, tem 1 chance em 365 de acertar
- Se ele responde ‘não sei’, garante zero ponto
- Em milhares de perguntas, o modelo que chuta parece melhor nos placares
É tipo aquele aluno que nunca deixa questão em branco na prova de múltipla escolha haha
Mesmo em condições ideais ele alucina
Pra reforçar, o artigo Calibrated Language Models Must Hallucinate, de Kalai e Vempala, mostra que modelos com bom desempenho preditivo tendem a alucinar mesmo em condições ideais
Ou seja, não é só bug a ser corrigido, tem a ver com a própria natureza de prever texto bem

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.A consequência prática é uma frase pra colar no monitor: fluência não é prova de verdade
O que significa ‘Model’: por que o LLM depende tanto do contexto
O ‘Model’ lembra que isso é uma representação estatística, e numa conversa ela só enxerga o que está no contexto
Que contexto?
É tudo que vai junto na entrada do modelo: suas mensagens, as respostas anteriores, os arquivos que você colou e por aí vai
Como o contexto cresce a cada mensagem
No Claude, segundo a documentação oficial de janela de contexto, cada nova entrada inclui todo o histórico anterior mais a mensagem atual
E a resposta do modelo passa a fazer parte da próxima entrada
Resultado: o uso de contexto cresce linearmente a cada turno
E as janelas estão enormes: o Claude Opus 5.5, lançado em 22 de setembro de 2026, tem 1M de tokens de contexto e saída máxima de 128K tokens
Então é só jogar tudo lá dentro, né? Será?
Janela grande não é atenção uniforme
O estudo Lost in the Middle (Liu et al., Stanford, UC Berkeley e Samaya AI, publicado no TACL) mostrou que o desempenho cai quando a informação relevante está no meio de um contexto longo
O formato é uma curva em U: o modelo aproveita melhor o que está no início e no fim
Ou seja, caber na janela não significa ser bem lido
Já me ferrei com isso jogando um monte de material num prompt só e esperando que o detalhe importante, enterrado no meio, fosse respeitado… 😛
Como usar o significado de LLM como critério no dia a dia
Beleza, teoria entendida, agora vira regra de uso
Cada palavra da sigla vira um critério:
Large: escolha o modelo pela tarefa
- Tarefa aberta, vaga ou criativa: prefira um modelo maior, porque modelo pequeno foge do tema quando o pedido não é bem definido
- Tarefa repetitiva, com escopo fechado e sem internet: um modelo pequeno local pode resolver, desde que o prompt seja bem coordenado
- Qualquer caso indo pra produção: teste no seu cenário real e ignore o gráfico de marketing, já que o Chinchilla mostrou que tamanho sozinho não decide
Language: saiba quando desconfiar
- Resposta com números, datas, nomes ou citações: confira na fonte, porque é exatamente aí que o chute plausível aparece
- Pergunta onde ‘não sei’ é aceitável: diga isso no prompt, peça pro modelo admitir incerteza em vez de completar a lacuna
- Texto bonito e confiante: lembre que fluência não é prova de verdade
Model: controle o contexto
- Informação crítica: coloque no início ou no fim do prompt, nunca enterrada no meio
- Conversa muito longa: abra uma conversa nova com um resumo do que importa, já que o histórico inteiro vai junto a cada turno
- Assunto que o modelo pode não conhecer: forneça o material (documento, trecho, dados) em vez de esperar que ele saiba
LLM não é oráculo: é um previsor de texto muito bom
No fim das contas, a sigla é um mapa de limites:
- Large: escala melhora a qualidade, mas não resolve tudo, e o equilíbrio entre modelo e dados pesa
- Language: linguagem fluente não é verdade, o modelo aprende padrões e é recompensado por chutar
- Model: o contexto define o que o modelo sabe, e nem tudo que cabe na janela recebe a mesma atenção
O próximo passo é simples: aplica esses critérios na sua próxima tarefa com IA e repara como a qualidade das respostas muda
E se quiser ver a diferença de escala na prática, assiste ao teste do Gemma3 270m ali em cima, é mto massa ver o modelo se perder no prompt vago e acertar no específico 🙂
Até o próximo post!
Perguntas frequentes
LLM significa a mesma coisa em ChatGPT, Claude, Gemini e outros produtos de IA?
Sim! LLM é a sigla de Large Language Model (modelo de linguagem grande), e é essa mesma base que sustenta ChatGPT, Claude, Microsoft Copilot, Gemini e Meta AI. A diferença entre eles está em como cada empresa treina, ajusta e empacota esse modelo, não no significado da sigla.
Por que um LLM inventa informação com tanta confiança, mesmo treinado em tanto texto?
Um artigo da OpenAI de 2025 (Kalai, Nachum, Vempala e Zhang) mostra que o problema está em como o modelo é treinado e avaliado: esses processos recompensam chutar em vez de admitir incerteza. O exemplo usado no artigo é direto: se o modelo não sabe o aniversário de alguém, chutar uma data dá 1 chance em 365 de acertar, enquanto responder ‘não sei’ garante zero ponto, então em milhares de perguntas quem chuta parece melhor nos placares.
O que é a janela de contexto de um LLM e por que ela afeta a qualidade da resposta?
É o espaço de texto que o modelo consegue ‘enxergar’ ao mesmo tempo pra gerar a próxima resposta. No Claude, esse uso cresce a cada turno da conversa, porque cada nova entrada carrega todo o histórico anterior mais a mensagem atual. O Claude Opus 5.5, por exemplo, tem janela de 1M de tokens de contexto e saída máxima de 128K tokens.
Quanto mais parâmetros um modelo de linguagem tem, melhor ele é?
Não necessariamente! O estudo Chinchilla, da DeepMind, treinou um modelo de 70 bilhões de parâmetros com 1,4 trilhão de tokens e superou o Gopher, que tinha 280 bilhões de parâmetros, usando o mesmo orçamento de computação. O Chinchilla ficou mais de 7 pontos acima no MMLU (67,5% de média) com 4 vezes menos parâmetros, o que mostra que dado e proporção importam tanto quanto tamanho.
Por que um LLM parece ‘esquecer’ informação que está no meio de um texto longo?
Isso tem nome: é o fenômeno descrito no estudo ‘Lost in the Middle’, de pesquisadores de Stanford, UC Berkeley e Samaya AI, publicado no TACL. O desempenho segue uma curva em U, melhor quando a informação relevante está no início ou no fim do contexto, e cai quando ela está espremida no meio.
Um token em um LLM é a mesma coisa que uma palavra?
Não exatamente. Token é o pedacinho de texto que o modelo processa, podendo ser uma palavra inteira, parte de uma palavra ou até um sinal de pontuação. Em inglês, a regra prática é de cerca de 4 caracteres por token, o que dá mais ou menos 3/4 de uma palavra.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
O que é um LLM e como ele funciona por dentro (explicado para devs)
O que é LLM? Entenda como esses modelos de linguagem funcionam por dentro: tokens, contexto, treino e inferência, explicado para devs.
O que significa LLM? Os dois sentidos da sigla e como saber qual é qual
O que significa LLM? Entenda os dois sentidos da sigla: Large Language Model (IA) e Master of Laws (Direito), e como diferenciar pelo contexto.
Como escolher o modelo LLM certo para o seu projeto: checklist de decisão
Guia pra escolher o modelo LLM certo: contexto, custo por token, latência e open source. Veja critérios e preços atualizados pra decidir sem erro.
