
Haiku Claude: onde usar o modelo (app, API ou dentro de um agente)?
O Haiku Claude tem três portas de entrada: o chat no app, a API e o uso dentro de um agente. No app (Claude.ai, na web, no iOS e no Android) você só conversa, sem configuração. Na API o modelo atende pelo identificador claude-haiku-4-5, custa US$ 1 por milhão de tokens de entrada e US$ 5 por milhão de saída, e roda na Claude Platform, Amazon Bedrock, Vertex AI e Microsoft Foundry. Dentro de um agente, tipo o Claude Code, você troca com /model haiku e fixa o modelo do subagente no frontmatter. A versão vigente é a Claude Haiku 4.5
Tu ouviu falar do Haiku, foi procurar, e caiu num monte de página falando de preço por token, de SDK, de plataforma de nuvem, e no fim das contas nem sabe onde abrir a coisa
Calma, é mais simples do que parece 🙂
O Haiku tem basicamente três portas de entrada: o chat no app, a API e o uso dentro de um agente
E cada porta muda duas coisas: o quanto tu controla (parâmetro, custo, qual modelo exatamente roda) e o tipo de trabalho que faz sentido jogar ali
Bora abrir as três?
Que modelo é esse hoje: Claude Haiku 4.5
Antes de escolher a porta, vale saber qual Haiku tá em pé
A versão atual da linha é a Claude Haiku 4.5
E não, não existe "Haiku 5" anunciado pela Anthropic: se tu viu alguém falando disso por aí, é especulação sem confirmação oficial
A linha de modelos Claude vigente em agosto de 2026 é essa: Haiku 4.5, Sonnet 5, Opus 5 e Fable 5
Na API, o Haiku atende pelo identificador claude-haiku-4-5
Por que ele existe:
O Haiku 4.5 foi anunciado em 15 de outubro de 2025, e o posicionamento do próprio anúncio já entrega a ideia: mais de 2x mais rápido que o Sonnet 4, com nível parecido de desempenho em código, a um terço do custo do Sonnet 4

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 45min
Ele entrou como substituto direto (drop-in) do Haiku 3.5 e do Sonnet 4
Ou seja: a proposta não é ser o mais inteligente da família, é ser o rápido e barato que ainda dá conta do recado
A janela de contexto dele é de 200 mil tokens
E se tu tem código velho apontando pra versão antiga, se liga nisso: o Claude Haiku 3 foi retirado da Claude API em 19 de fevereiro de 2026
Se a tua dúvida real é qual dos irmãos usar em cada tipo de tarefa, eu já destrinchei isso em qual modelo da Claude API usar
App, API ou agente: o que muda em cada caminho
Aqui tá o resumo das portas, lado a lado
| Caminho | Onde vive | Como se define o modelo | Nível de controle | Pra que serve |
|---|---|---|---|---|
| Chat no app | Claude.ai, na web, no iOS e no Android | Direto na conversa, sem configuração nenhuma | Baixo: tu não mexe em parâmetro nem vê custo por token | Sentir a resposta e a velocidade do modelo |
| API e plataformas | Claude Platform (API da Anthropic), Amazon Bedrock, Google Cloud Vertex AI e Microsoft Foundry | Pelo identificador claude-haiku-4-5 na chamada |
Alto: parâmetros na mão e custo por token (US$ 1 por milhão de entrada, US$ 5 por milhão de saída) | Integrar em produto, processar volume, usar cache e batch |
| Agente no Claude Code | Terminal, na sessão do Claude Code | Pelo comando /model, por alias ou ID completo (ex.: /model haiku) |
Médio a alto: tu escolhe o modelo por papel dentro do fluxo | Deixar o modelo rápido nas tarefas mecânicas do agente |
| Agente no Agent SDK | Agente que tu monta por código | No código, pelo campo model de AgentDefinition |
Médio a alto: tu escolhe o modelo por papel dentro do fluxo | Deixar o modelo rápido nas tarefas mecânicas do agente |
Duas observações honestas sobre a tabela
A primeira: nas três nuvens (Amazon Bedrock, Google Cloud e Microsoft Foundry) o Haiku 4.5 está generally available desde 09/06/2026, então não é experimento, é caminho de produção
A segunda: aquele preço da coluna é o da plataforma da Anthropic
Os valores dentro de Bedrock, Vertex AI e Foundry podem ser outros, e eu não vou chutar número que não conferi
Como colocar o Haiku para rodar dentro de um agente
Essa é a porta mais operacional das três, então vamos com calma, passo a passo
O exemplo aqui é o Claude Code, que é onde a coisa é mais direta
- Rode
/modelpra ver o que tem disponível
O comando lista os modelos e deixa tu escolher outro pra sessão
/modelO erro comum deste passo: sair procurando arquivo de configuração escondido antes de simplesmente rodar o comando
- Selecione o Haiku pelo alias
/model haikuO Claude Code trabalha com aliases de modelo (fable, opus, sonnet e haiku) que apontam pra um ID padrão
O erro comum deste passo: achar que o alias é um snapshot congelado
Não é
Os aliases migram pro snapshot mais recente do modelo, normalmente em até uma semana depois de um lançamento
Se o teu fluxo depende de comportamento estável, alias sozinho não te dá isso
- Fixe o alias num modelo específico com variável de ambiente
A ANTHROPIC_DEFAULT_HAIKU_MODEL redireciona o alias haiku pra um modelo específico
export ANTHROPIC_DEFAULT_HAIKU_MODEL=claude-haiku-4-5O erro comum deste passo: confundir essa variável com a ANTHROPIC_MODEL
São coisas diferentes: a ANTHROPIC_MODEL sobrescreve o modelo padrão da sessão, enquanto a de cima só mexe pra onde o apelido haiku aponta
- Prenda o subagente no Haiku pelo frontmatter
Subagente no Claude Code é arquivo Markdown, e o modelo dele mora no frontmatter YAML, lá em cima
---
model: haiku
---
O campo model aceita alias (sonnet, opus, haiku, fable), aceita ID completo e aceita inherit
E aqui mora o erro comum: quando tu omite o campo, o padrão é inherit
Traduzindo: o subagente vai rodar no modelo da conversa principal, e não no rapidinho que tu imaginou
- Entenda quem ganha de quem
A ordem de resolução do modelo do subagente é essa, nessa sequência: a variável CLAUDE_CODE_SUBAGENT_MODEL, depois o parâmetro model da invocação, depois o campo model do frontmatter, e por último o modelo da conversa principal
O erro comum deste passo: setar a variável de ambiente, esquecer dela, e depois ficar quebrando a cabeça achando que o frontmatter tá sendo ignorado por bug
Não é bug, é precedência
- No Agent SDK, a lógica é a mesma
Se tu tá montando o agente por código, o campo model de AgentDefinition aceita 'sonnet', 'opus', 'haiku' ou 'inherit'
Mesma pegadinha do inherit vale aqui: omitiu, herdou
Quando cada caminho faz sentido
Tu só quer sentir o modelo: chat no app
O Haiku 4.5 dá pra usar por chat no aplicativo do Claude: Claude.ai na web, no iOS e no Android
É a porta de zero configuração
Tu joga umas perguntas, sente a velocidade da resposta, e pronto, já tem opinião formada
Essa lógica de "app pra sentir, API pra construir" não é exclusividade da Anthropic: escrevi a mesma escada em por onde começar no Gemini, e a cabeça é a mesma
Tu vai processar volume: API
Aqui é onde o Haiku brilha de verdade, porque volume é conta de padaria
O preço base na plataforma da Anthropic é US$ 1 por milhão de tokens de entrada e US$ 5 por milhão de tokens de saída
E tem duas alavancas que mudam o jogo
Com prompt caching, a economia possível chega a até 90%: leitura de cache sai a US$ 0,10 por milhão, escrita de cache a US$ 1,25 por milhão, e escrita de cache com TTL de 1h a US$ 2,00 por milhão
Com batch processing (processamento em lote), a economia é de 50%: US$ 0,50 por milhão de entrada e US$ 2,50 por milhão de saída
Se teu caso é classificar, extrair, resumir ou etiquetar coisa em massa, é essa combinação que tu quer olhar antes de sair otimizando prompt
Ah, e um detalhe que pega gente desprevenida: o Haiku 4.5 suporta extended thinking (raciocínio estendido) na API, mas ele vem desativado por padrão
Interleaved thinking, esse não rola no Haiku 4.5
Tu tá montando agente: modelo por papel
A cabeça aqui é outra
Tu não escolhe "o modelo do projeto", tu escolhe o modelo de cada papel
O Haiku pega as tarefas mecânicas (varrer, listar, formatar, repetir), e o modelo caro fica reservado pro raciocínio que realmente exige
É o mesmo raciocínio de time: não é o senior que carrega a caixa
O que muda na prática quando o modelo barato vira peça do agente
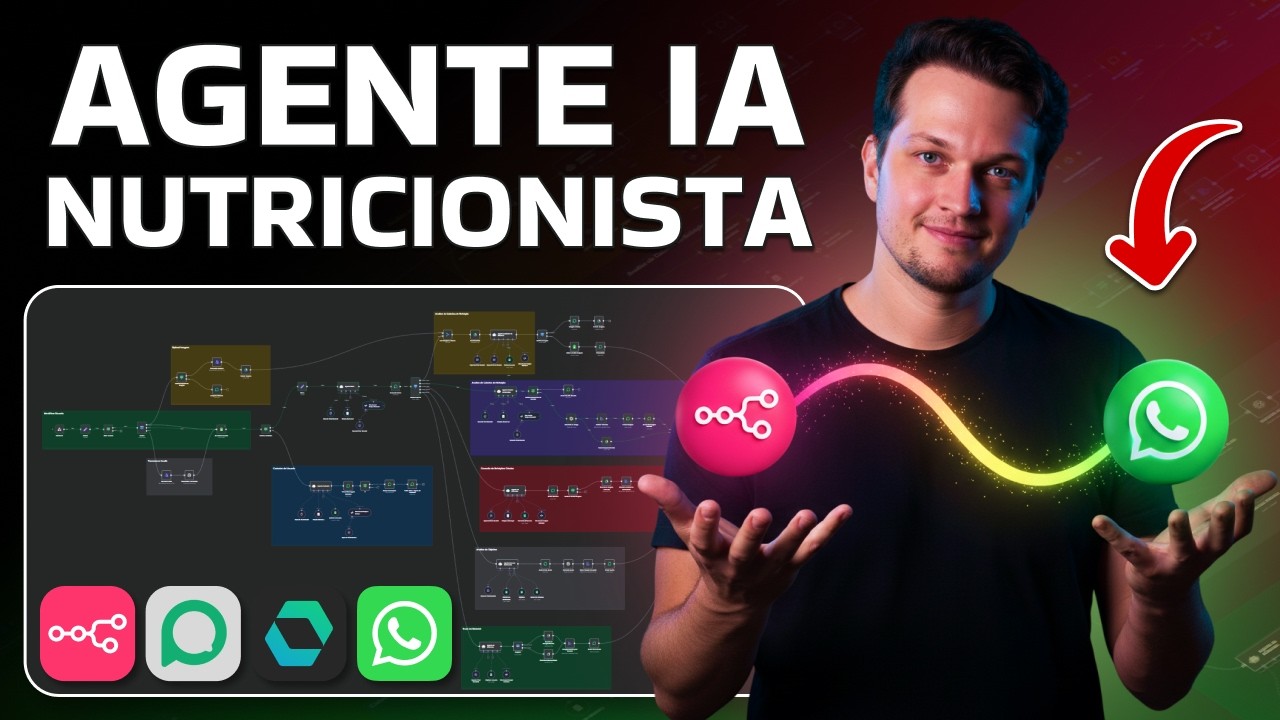
No vídeo abaixo eu monto um sistema multi agentes no WhatsApp usando n8n e Evolution API, e ali essa decisão de modelo aparece de um jeito bem cru
Uma coisa que eu mostro logo no começo: no nó de agente, a única peça obrigatória é o modelo de chat, a LLM
Memória e ferramentas são opcionais, entram conforme a necessidade do fluxo
Ou seja, a escolha de modelo não é detalhe de configuração, é a peça que sustenta o agente inteiro
Outra diferença que fica escancarada na montagem: dentro do agente, o acesso ao modelo é por chave de API criada no painel do provedor, não pelo app de chat
Eu crio a credencial, colo a chave no n8n e confirmo que a conexão foi testada com sucesso
App de chat e agente são mundos separados nesse ponto, e é justamente aí que muita gente trava
Na hora de escolher o modelo pro curso, eu optei por modelos menores em vez do modelo padrão, com uma justificativa bem prática: gastar poucos tokens durante o desenvolvimento e os testes
E a minha avaliação naquele cenário foi essa: os modelos menores entregaram resultado muito parecido com o do modelo maior no contexto do projeto
Dá pra trocar por um modelo mais forte depois, quando o sistema todo já estiver validado
Testar o sistema inteiro no modelo barato primeiro e só depois considerar subir de nível: pra mim isso é decisão de custo dentro de fluxo automatizado, não preguiça
Aviso justo: aquele vídeo é todo feito na plataforma da OpenAI, não toca em Claude nem em Haiku em momento nenhum
O que vale ali é o raciocínio da escolha, que é idêntico quando o modelo da vez é o Haiku 4.5
E é exatamente por isso que fixar o modelo do subagente importa tanto
Se tu deixa no inherit, o teu "agente barato" pode estar rodando no modelo caro sem tu perceber, e a surpresa só chega na fatura
Por onde começar, afinal
Depende do teu perfil, e eu vou ser direto
Curioso, só quer entender o hype: abre o app e conversa
Custo de aprendizado zero, controle zero também
Tu não vai conseguir medir custo por token nem ajustar nada, e tudo bem, não é esse o objetivo
Dev integrando num produto: vai de API
É onde tu tem claude-haiku-4-5, parâmetros na mão, prompt caching, batch e a escolha de plataforma (Claude Platform, Bedrock, Vertex AI ou Microsoft Foundry)
O preço da porta é responsabilidade: agora a conta é tua e o comportamento também
Dev montando agente: vai pelo agente mesmo, com o modelo fixado por papel
O controle aqui é bom, mas ele tem uma pegadinha própria: alias que migra de snapshot e herança de modelo
Se tu não olhar a ordem de resolução, tu acha que configurou e não configurou
O que ainda depende do teu caso: o quanto de qualidade tu tá disposto a trocar por velocidade
Isso nenhuma tabela responde, só o teu teste com a tua tarefa real
Conclusão
Fechando as portas em uma frase cada
App: conversa direta no Claude.ai (web, iOS e Android), zero configuração, serve pra sentir o modelo
API: claude-haiku-4-5 na Claude Platform, Bedrock, Vertex AI ou Microsoft Foundry, com controle total e custo por token na mesa
Agente: o Haiku vira motor das tarefas mecânicas, escolhido pelo /model no Claude Code ou pelo campo model no Agent SDK, com o modelo caro guardado pro que exige raciocínio
Próximo passo concreto? Escolhe um dos dois
Abre o app e joga uma pergunta pra sentir a velocidade
Ou roda /model haiku no Claude Code e compara com o modelo que tu usa hoje, na tua tarefa de sempre
A comparação no teu próprio contexto vale mais que qualquer benchmark de anúncio 😀
até o próximo post!
Perguntas frequentes
Quanto custa usar o Claude Haiku 4.5 pela API?
Na plataforma da Anthropic, o preço é US$ 1 por milhão de tokens de entrada e US$ 5 por milhão de tokens de saída. Com prompt caching dá pra economizar até 90%, e com processamento em batch a economia é de 50%. Os valores de cache ficam em US$ 0,10/M na leitura, US$ 1,25/M na escrita normal e US$ 2,00/M na escrita com TTL de 1h, e o batch fica em US$ 0,50/M de entrada e US$ 2,50/M de saída.
O Claude Haiku 4.5 tem raciocínio estendido (extended thinking)?
Tem sim, o extended thinking é suportado na API, mas vem desativado por padrão. Uma ressalva importante: o Haiku 4.5 não suporta interleaved thinking, então se o teu fluxo depende disso, é bom conferir antes de montar a integração.
Qual a diferença entre o alias haiku e o ID claude-haiku-4-5 no Claude Code?
O alias haiku é um apelido que aponta pra um modelo padrão e migra pro snapshot mais recente, normalmente em até uma semana depois de um lançamento. Já o ID completo claude-haiku-4-5, usado direto na API, não some da posição, ele é fixo. Se o teu fluxo precisa de comportamento estável, vale travar com a variável ANTHROPIC_DEFAULT_HAIKU_MODEL em vez de confiar só no alias.
Ainda dá pra usar o Claude Haiku 3 na API?
Não. O Claude Haiku 3 foi retirado da Claude API em 19 de fevereiro de 2026. Quem ainda tem código apontando pra ele precisa migrar, e o substituto natural na linha é o Claude Haiku 4.5.
O Haiku 4.5 está disponível em outras nuvens além da Anthropic?
Está. Além da Claude Platform (API da própria Anthropic), o Haiku 4.5 roda em Amazon Bedrock, Google Cloud Vertex AI e Microsoft Foundry. Nas três nuvens ele está generally available desde 09/06/2026, ou seja, já é caminho de produção e não experimento.
Como economizar tokens usando o Haiku 4.5 em grande volume?
As duas alavancas oficiais são prompt caching e processamento em batch. O prompt caching pode chegar a até 90% de economia, e o batch processing dá 50%, então combinar os dois em cargas grandes e repetitivas é o caminho mais direto pra baixar custo sem trocar de modelo.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 27min




Blog | Mais populares
Como instalar Claude Code: guia completo para iniciantes
Aprenda como instalar Claude Code, autenticar sua conta e usar o /init para configurar seu projeto. Veja requisitos e métodos nativo, Homebrew e WinGet. Pra […]
Claude Code Preço: quanto custa, planos Pro vs Max e API
Conheça detalhadamente o Claude Code preço, incluindo os planos Pro e Max, opções gratuitas, e os valores da API para diferentes níveis de uso e […]
Como gerenciar contexto no Claude Code: tokens, /compact e /clear
Descubra como gerenciar contexto no Claude Code utilizando tokens de modo eficiente, conheça os comandos /compact e /clear e mantenha a alta qualidade das suas […]
