
Hugging Face roda MoE de 180B em Mac de 32 GB com experts lidos do SSD
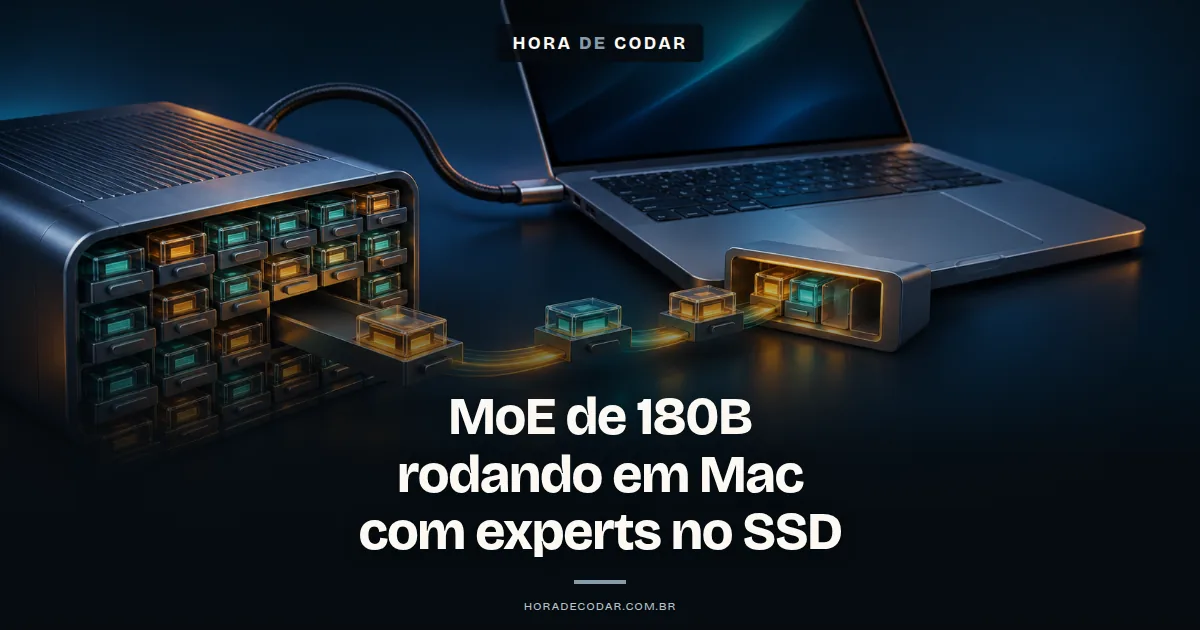
Em 18 de novembro de 2026, Tarek Ziadé publicou no blog da Hugging Face o post "180B Parameters, 32GB of RAM: Pushing MoE Inference to the Limit with Transformers". O texto descreve o experts_offload, uma opção proposta para o Transformers, aplicada ao Qwen3.8-Flash-Next em um MacBook M5 com 32 GB de memória unificada. O modelo tem 180B em disco e 121 GB de experts em FP8, que são lidos direto do SSD. Segundo o autor, a geração de tokens fica a até 6% do Strata.
Tem dois detalhes importantes logo de cara. A opção experts_offload foi proposta em um PR no Transformers (#50717), sem confirmação de versão estável. E o Qwen3.8-Flash-Next ainda depende de um pacote específico do modelo.
Por que MoE grande não cabe na memória e o que o Strata faz

Black Week do Nexus
A formação de IA mais completa do Brasil
- 7 formações · 112 cursos · 26 mil alunos
Em um modelo MoE (Mixture of Experts), os experts são mais de 90% dos pesos, segundo o post da Hugging Face. É aí que mora o problema: o modelo usa poucos experts por token, mas todos precisam estar acessíveis em algum lugar.
O Qwen3.8-Flash-Next mostra bem essa conta. Segundo a Unite.AI, ele soma 125B do modelo principal, 51B de parâmetros de embedding N-gram e um módulo MTP de 4B, o que dá 180B em disco. Só 6B ficam ativos por token. Cada camada MoE tem 512 experts, com 10 roteados mais 1 compartilhado ativos.
E o Strata? É um motor de inferência para MoE que deixa só os experts mais usados na VRAM e manda o resto para a RAM ou até para o disco. Pense em um cache de navegador: o que você abre toda hora fica perto, o resto vai para longe.
O autor cita um post de terceiros com o Qwen3.8-Flash-Next em um Mac M4 de 32 GB a 13,5 tok/s, mais rápido que o llama.cpp. Mesmo assim, ele considera isso lento demais para o jeito como usa agentes de código.
Como llama.cpp, vLLM e Transformers fazem offload de experts
O autor comparou as engines por três perguntas: onde os experts ficam, onde roda o cálculo e o que trafega a cada token. A diferença entre elas está toda nessas respostas.
- llama.cpp: mapeia o GGUF com mmap e pode manter os experts na CPU com
--cpu-moe,--n-cpu-moe N,-ot "exps=CPU"ou--fit on. O cálculo dos experts também roda na CPU, então só as ativações passam pelo PCIe. Funciona muito bem se os experts cabem na RAM. Se não cabem, o page cache entra em thrashing. O novo cache de experts na GPU (--moe-cache-mib) fragmenta o grafo (2 splits por token viram 50) e perde cerca de 10% mesmo quando tudo cabe. - vLLM:
--cpu-offload-gb Ncoloca N GB de pesos em RAM pinned, e os kernels leem pelo PCIe. Não existe cache, então um expert quente cruza o PCIe a cada token, e também não tem camada de disco. Por padrão entram camadas densas, e--cpu-offload-params expertslimita o offload aos experts. Isso combina com batches grandes, menos com um usuário em uma GPU. - Transformers (via Accelerate): usa
device_map="auto"eoffload_folder, um módulo por vez, com hooks que copiam os pesos para a GPU antes do forward. Em MoE, isso copia o banco inteiro de experts da camada a cada token para usar 8 ou 10, sem cache nem noção de roteamento. No Mac é pior ainda: CPU e GPU dividem a memória, então o offload para a CPU não libera nada.

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →Benchmark de decode: Strata, llama.cpp, vLLM e Transformers
Os números abaixo são do Qwen3.6-35B-A3B em uma A10G de 24 GB, com bastante RAM. Harry Mellor rodou o vLLM de novo com flags melhores.
| Engine e configuração | Decode (tok/s) |
|---|---|
| Strata, Q8_0 | 82 a 88 |
llama.cpp, Q8_0, --fit on | 63 a 64 |
llama.cpp, BF16, --fit on | 35 a 36 |
vLLM, FP8, --cpu-offload-gb 16 --cpu-offload-params experts | 20,1 |
vLLM, FP8, mesmas flags, --enforce-eager | 14,7 |
vLLM, FP8, --cpu-offload-gb 16 | 9,7 |
vLLM, BF16, --cpu-offload-gb 50 --cpu-offload-params experts | 7,3 |
vLLM, BF16, --cpu-offload-gb 50 | 3,3 |
| Transformers + Accelerate | 0,16 |
Se liga no fim da tabela: o caminho antigo do Transformers fica muito atrás.
A conclusão do autor é direta. Se os experts cabem na RAM, é difícil bater o llama.cpp. Se não cabem, é preciso transmitir só o que o router escolhe, com um cache limitado, rápido o bastante para o gargalo ser o SSD e não o Python. O Transformers não fazia isso de fábrica.

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Como funciona o experts_offload no Transformers
Segundo o repositório tarekziade/moe-expert-streaming, os experts mapeados para "disk" no device_map vão para um caminho de streaming, e não para o offload do Accelerate. O loader pula esses tensores, e as camadas MoE passam a usar uma implementação com offload.
Os experts ficam em um cache limitado no dispositivo, com um pool por layout de expert. Quando falta um expert, ele é lido por 8 threads de I/O, com uma leitura contígua por expert.
E como ele sabe o que vai precisar? Os routers das duas camadas seguintes rodam antes, sobre o hidden state atual, para adivinhar quais experts pré-carregar (prefetch_depth). No prefill, os experts da próxima camada são lidos com antecedência.
No Mac, o repositório relata cerca de 18 GiB de memória do dispositivo usada depois do carregamento, com um cache de experts de 12 GiB. Tudo isso para um modelo com 121 GB de experts, distribuídos em 48 camadas de 512 experts cada.
Status e quem pode usar: PR #50717 e pacote do Qwen3.8-Flash-Next
O recurso é uma opção do from_pretrained proposta no PR #50717 do Transformers. Não há confirmação de merge nem de versão estável, então não conte com ele em uma instalação comum do Transformers por enquanto.
Pela proposta descrita no post, o uso seria um device_map que manda os experts para "disk" e o parâmetro experts_offload com o tamanho do cache. Opcionalmente, a proposta prevê caminhos de experts quantizados offline, que deixam as leituras menores. Segundo o post, isso vale para MoEs com o layout padrão de experts.
Segundo o repositório, modelos como OLMoE e Qwen3-MoE não precisariam de pacote extra e usariam o experts_offload do Transformers direto, dentro dessa proposta. Já o Qwen3.8-Flash-Next depende do pacote do repositório tarekziade/moe-expert-streaming.
Duas ressalvas do próprio autor merecem atenção. Todo o código foi feito com IA, incluindo o PR e o pacote do modelo. E ele mesmo diz que o resultado provavelmente continua lento demais para o jeito como trabalha.
Próximo passo para quem roda MoE localmente
Comece medindo o tamanho dos experts do seu modelo contra a RAM que você tem. Se cabem, o llama.cpp continua sendo o caminho que o autor aponta como difícil de bater.
Se não cabem, acompanhe o PR #50717 e espere o merge antes de planejar algo em cima dele. Antes de testar, leia o post original da Hugging Face para conferir as condições de cada número e as limitações que o autor registra.
Fontes consultadas
Consulta em .
Acompanhe os tutoriais do Hora de Codar no YouTube. Se quiser aprofundar o contexto, veja Essa IA Mostra Tudo Que Você Fez Nos Últimos 30 Dias.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
Model Integration Contracts: a proposta da Hugging Face para pegar bugs do Transformers antes do merge
Entenda os Model Integration Contracts, proposta da Hugging Face para testar o Transformers com modelos reduzidos após bug do UMT5.

Hugging Face passa a usar o roteador da OpenRouter no Inference Providers
Hugging Face troca o roteador do Inference Providers pelo da OpenRouter para escolher provedor por preço, velocidade e confiabilidade a cada chamada.
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação A popularidade da automação de processos com o n8n está em alta, principalmente […]
