
Hugging Face passa a usar o roteador da OpenRouter no Inference Providers
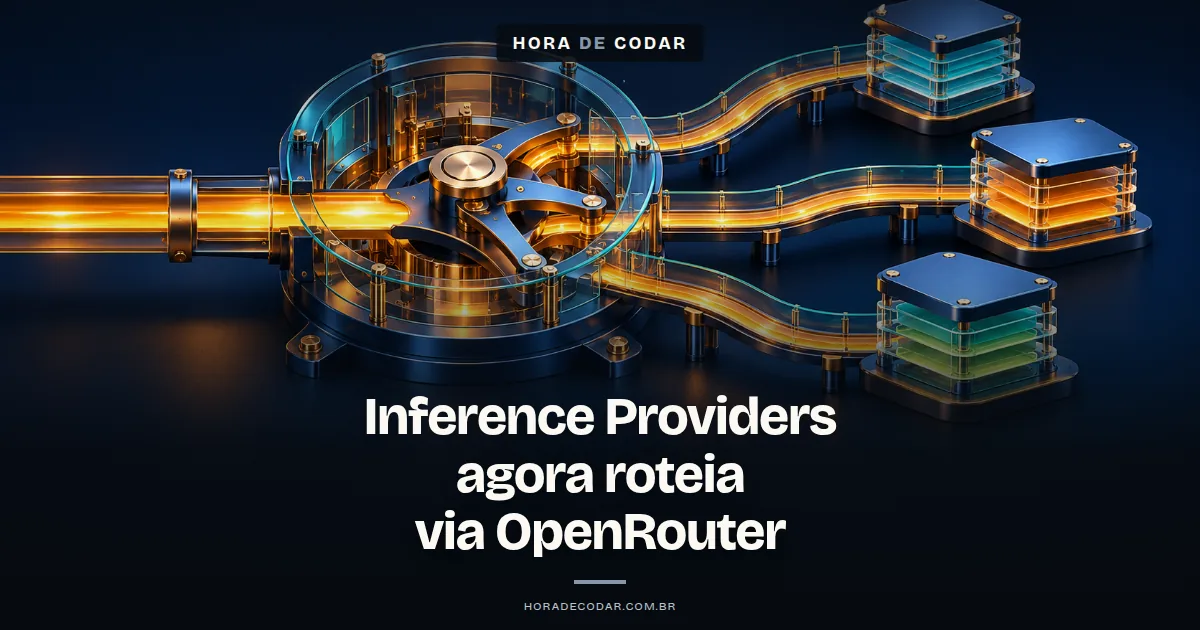
Em 16 de novembro de 2026, a Hugging Face anunciou que o Inference Providers deixou o roteador próprio e passou a usar o da OpenRouter para modelos de linguagem. Cada chamada agora vai para o provedor com a melhor combinação de preço, velocidade e confiabilidade, medida ao vivo. Se o primeiro provedor falhar, a mesma chamada é repetida em outro.
Seu código continua igual e o token da Hugging Face segue valendo. Existe, porém, uma mudança incompatível: com modelos de linguagem, chaves próprias de provedor deixam de funcionar.
O que mudou no roteamento do Inference Providers
Até agora, o Inference Providers escolhia um provedor para a sua requisição. Se esse provedor falhasse, você recebia o erro dele e o retry ficava por sua conta.
Com a parceria entre Hugging Face e OpenRouter, segundo o anúncio da Hugging Face, as requisições passam pelo roteador da OpenRouter, que distribui o tráfego entre mais de 80 provedores. Quando uma tentativa falha, a chamada é repetida no próximo provedor dentro da mesma requisição. Na prática, o failover que muita gente montava na mão agora vem embutido.
Esse roteador também é recente. A OpenRouter reconstruiu o roteamento padrão em 28 de outubro de 2026, e ele deixou de considerar só o menor preço de tabela. A própria OpenRouter também anunciou a integração no mesmo dia.
E o ganho? O post da Hugging Face cita medições da OpenRouter: 46% menos erros de capacidade, tempo até o primeiro token 16,9% melhor e vazão 16,3% maior. São números da OpenRouter reproduzidos pela HF, sem medição independente.

Black Week do Nexus
A formação de IA mais completa do Brasil
- 7 formações · 112 cursos · 26 mil alunos
O que muda para quem chama modelos open-weight via API
Para a maioria dos projetos, não há nada a configurar. Segundo a OpenRouter, o código e o token da HF continuam os mesmos.
O roteador aceita a Chat Completions e a Responses API da OpenAI e a Messages API da Anthropic para todo modelo de chat, independentemente do provedor por trás. Assim, se o seu cliente já fala um desses formatos, ele segue funcionando.

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →A Hugging Face também publicou guias de configuração para Claude Code, Codex, OpenCode, Pi e Hermes Agent. Vale abrir o guia da ferramenta que você usa, porque os passos mudam de uma para outra.
A tabela de preços do provedor não muda e a HF não aplica markup. Mas no mesmo experimento que mediu os ganhos de roteamento, a OpenRouter apontou custo por requisição 6,0% maior com o novo roteador padrão. Usuários PRO recebem US$ 2 de créditos por mês, e organizações Team e Enterprise recebem US$ 2 por assento.
Como escolher ou fixar o provedor de cada chamada
Roteamento automático é ótimo, mas às vezes você quer saber exatamente quem está respondendo, né? Para isso existe o sufixo no id do modelo:
zai-org/GLM-5.3            # padrão: melhor mix de preço, velocidade e confiabilidade
zai-org/GLM-5.3:fastest    # maior vazão
zai-org/GLM-5.3:cheapest   # menor preço
zai-org/GLM-5.3:novita     # somente Novita
O formato geral é model:provider. Fixar um provedor é a saída para quem precisa de comportamento previsível, como em testes de regressão.
Se liga no cache também. O roteamento leva o cache em conta, então a conversa fica no provedor que guarda o cache do prompt. Para deixar isso explícito, envie um UUID estável por conversa no header X-HF-Session-Id.

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Outra forma de controle é por exclusão. Nas configurações da Hugging Face, na parte do Inference Providers, você pode desligar qualquer provedor, e o roteador deixa de mandar requisições para ele. Organizações têm a mesma opção, que vale para toda requisição cobrada da organização.
Para auditar, a página de cada modelo ganhou as abas Providers e Metrics. A Providers mostra, por provedor, o preço de entrada e saída, a velocidade e o uptime das últimas 24 horas. Já a visão geral de uso separa o gasto por provedor.
Mudança incompatível: chaves próprias de provedor
Com modelos de linguagem, você não pode mais usar a sua própria API key de um provedor. A cobrança passa a cair na conta ou organização da Hugging Face.
Tome cuidado se o seu projeto dependia disso para usar crédito ou contrato direto com um provedor. Essas chamadas precisam ser revistas.
Imagem, vídeo e áudio ficam de fora da mudança. Essas gerações continuam direto pelo Inference Providers, sem passar pela OpenRouter, e chaves próprias de provedores de imagem e vídeo seguem funcionando.
Quem só queria controlar o provedor tem duas alternativas: o sufixo model:provider ou desligar os provedores indesejados nas configurações.
Próximo passo
Procure no seu código chamadas de LLM que usam chave própria de provedor, porque elas são as que podem quebrar. Depois, decida caso a caso se vale fixar o provedor com sufixo ou deixar o padrão escolher.
Com o tráfego rodando, abra a visão geral de uso e confira para quais provedores as chamadas estão indo. Se algum não fizer sentido para você, basta desligá-lo nas configurações.
A Hugging Face também adiantou os próximos passos: conectar a conta da OpenRouter à Hugging Face e rotear mais tipos de tarefa pela OpenRouter. O anúncio não informa data para nenhum dos dois.
Fontes consultadas
Consulta em .
Veja mais exemplos práticos no canal Hora de Codar. Se quiser aprofundar o contexto, veja Como usar o Claude Code de graça e sem limite (passo a passo atualizado).
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
Model Integration Contracts: a proposta da Hugging Face para pegar bugs do Transformers antes do merge
Entenda os Model Integration Contracts, proposta da Hugging Face para testar o Transformers com modelos reduzidos após bug do UMT5.
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação A popularidade da automação de processos com o n8n está em alta, principalmente […]
O que significa “ChatGPT network error” e como resolver
Network error indica falha de comunicação, mas não identifica sozinho a causa. Confira o status do ChatGPT, teste uma nova conversa e uma janela sem […]
