
IBM lança LLMON: Granite 4.1 3B e 8B treinados contra prompt injection
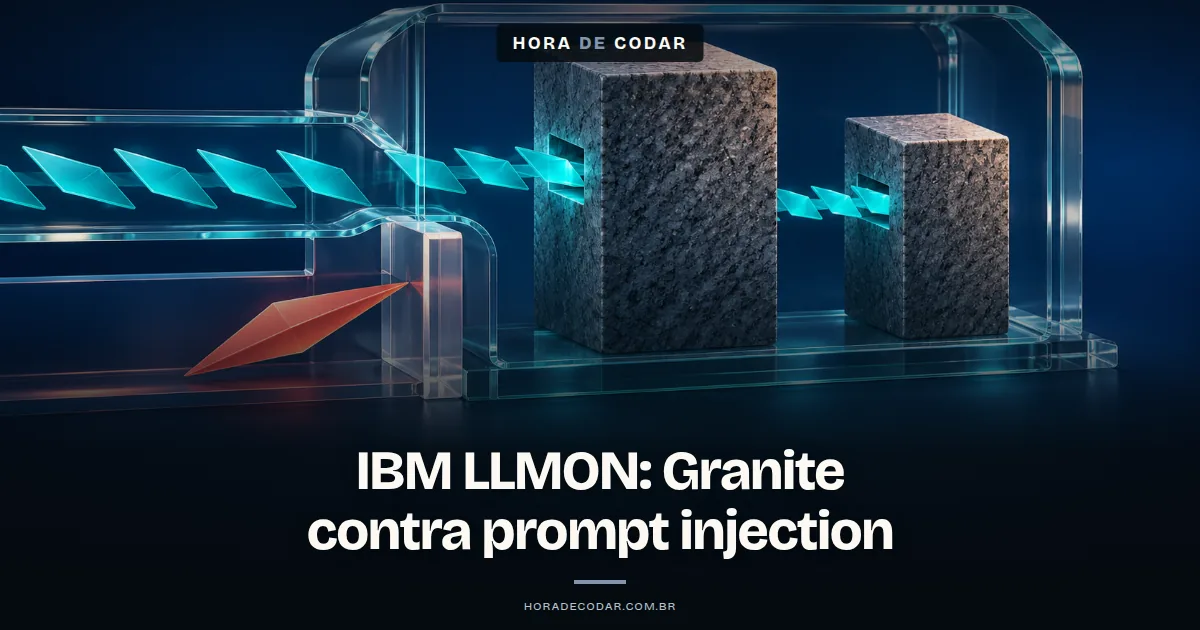
A IBM lançou o LLMON (LLM Object Notation), uma linguagem de marcação feita para LLMs que separa de forma explícita o que é instrução e o que é dado. Junto com ela vieram dois modelos experimentais em preview treinados nesse formato: granite-4.1-3b-LLMON-preview e granite-4.1-8b-LLMON-preview. O anúncio saiu em 12 de novembro de 2026 no blog da IBM Granite na Hugging Face.
O público principal é quem constrói agentes e pipelines de RAG. Antes de empolgar, vale saber duas coisas: os modelos são previews experimentais, e os resultados contra prompt injection indireto são alegação da própria IBM, sem verificação independente citada no anúncio.
O que é o LLMON e por que a IBM não usou JSON
O LLMON (pronuncia-se como "lemon") é uma marcação parecida com XML, pensada para passar estrutura e significado ao modelo de forma explícita. Cada componente recebe uma tag com sentido, e essa tag fica envolvida por delimitadores que são tokens especiais reservados, não caracteres comuns.

Black Week do Nexus
A formação de IA mais completa do Brasil
- 7 formações · 112 cursos · 26 mil alunos
Por que isso importa? Porque assim estrutura e conteúdo usam partes separadas do vocabulário do modelo.
O argumento da IBM contra o JSON é bem direto. No JSON, a estrutura depende de tokens como {, " e :, que também aparecem em texto comum. Para o modelo, a aspa dentro de um documento e a aspa que fecha um campo são o mesmo token.
Tem ainda o aninhamento. No JSON, saber em que nível você está depende de contar colchetes, e a IBM lembra que transformers são fracos nisso. No LLMON, o aninhamento é declarado localmente, sem obrigar o modelo a fazer essa contagem.
Como o LLMON separa instrução de dado
A peça central é um ID único que liga cada instrução ao dado sobre o qual ela deve agir. A instrução pode estar em qualquer parte do contexto, e o ID aponta para ela. A IBM compara isso a chamar uma função passando argumentos, analogia que qualquer dev entende na hora.
Na prática, você não precisa escrever os tokens na mão. O LLMON não substitui o chat template, ele complementa. Os modelos preview vêm com template próprio, então você monta a mesma lista de messages de qualquer modelo de chat e chama apply_chat_template normalmente.
VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →A diferença é que cada turno pode nomear suas partes (instruction, data, requirement) e marcar cada uma com exec True ou False. Este é o exemplo publicado pela IBM:
messages = [
    {
        "role": "user",
        "instruction": [{"value": "Write a short paragraph about", "exec": True}],
        "data": [{"value": "IBM Company", "exec": True}],
        "requirement": [
            {"value": "Use less than 10 words", "exec": True},
            {"value": "Do not use commas", "exec": True},
        ],
    }
]
Segundo a IBM, o template renderiza isso com tokens especiais de abertura e fechamento (como open, close e open_end, cada um entre os delimitadores reservados do modelo), fechando com um bloco exec no final.
E o que é esse bloco exec? É ele que diz qual instrução executar e sobre o quê. Uma parte marcada como True entra nesse bloco. Uma parte marcada como False continua no contexto, mas nada faz referência a ela, então o modelo não deve agir sobre ela.
Quanto o LLMON reduz o prompt injection, segundo a IBM
De acordo com o paper da IBM no arXiv, o pós-treinamento dos modelos base Granite 4.1 de 3B e 8B (fine-tuning supervisionado seguido de reinforcement learning) com supervisão estruturada em LLMON reduziu a taxa de sucesso de ataque em benchmarks de prompt injection indireto de 53% a 100% para 0,02% a 5,6%. Não houve mudança de arquitetura.
No anúncio, a IBM afirma que injeções escondidas em dados do usuário passam a ser, em geral, ignoradas, enquanto modelos instruct comuns são sequestrados com alta probabilidade. Tudo isso mantendo a capacidade geral em relação ao Granite 4.1 Instruct.

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Há outro benefício declarado: trechos sem relação, turnos antigos do chat e saídas de ferramentas não são puxados para a resposta, porque cada instrução fica presa ao dado ao qual se aplica.
Agora, se liga no contexto desses números. Eles vêm da própria IBM, valem para alguns benchmarks e não aparecem acompanhados de uma avaliação independente. É um sinal promissor, não uma garantia.
O que muda para quem constrói agentes e RAG
O ponto mais útil é que a IBM não entregou só o paper. Segundo o anúncio, saiu também um repositório no GitHub com um toolkit para trabalhar com LLMON, além de exemplos de workflows e templates.
Para quem já tem tudo em JSON, existem conversores e notebooks de exemplo que traduzem JSON para LLMON e de volta, sem perda. Isso permite testar sem reescrever o pipeline inteiro.
O Mellea já tem suporte nativo: ele "LLMONiza" automaticamente as chamadas que faz ao LLM. A IBM também diz que você pode definir estrutura e tags próprias e treinar um LoRA sobre os modelos LLMON para que eles entendam esse formato.
Agora os limites. São previews experimentais, disponíveis só em 3B e 8B. Para dar contexto, o Granite 4.1 regular é uma família de modelos densos em 3B, 8B e 30B sob licença Apache 2.0. A licença específica das versões LLMON, porém, não está confirmada, então vale checar antes de qualquer uso comercial.
Vale testar o LLMON agora?
Vale, desde que como experimento controlado. O passo mais útil é pegar a sua própria suíte de ataques de prompt injection indireto (documentos envenenados, saídas de ferramenta maliciosas e por aí vai) e rodar contra um dos modelos preview.
Se os seus casos já estão em JSON, os conversores ajudam a reaproveitar esses dados sem retrabalho. Compare o resultado com o modelo que você usa hoje, nos mesmos cenários.
Lembre que o LLMON é uma camada complementar e ainda experimental. Ele não dispensa permissões restritas para ferramentas, validação de saída e os demais guardrails do seu agente.
Fontes consultadas
Consulta em .
Acompanhe os tutoriais do Hora de Codar no YouTube. Se quiser aprofundar o contexto, veja SAKANA FUGU: A IA QUE USA VÁRIOS MODELOS AO MESMO TEMPO.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares

IBM lança o Granite Switch 4.1.1: ASR multilíngue em 7 idiomas (com português) e novo adapter de decisão sem mexer no modelo base
IBM libera o Granite Switch 4.1.1, patch que atualiza o ASR multilíngue (7 idiomas, incluindo português) e traz adapter de decisão sem retreinar o modelo base.
IBM lança o Granite Timeseries Ensemble r1: quatro modelos abertos de previsão de séries temporais em uma só interface
IBM lança Granite Timeseries Ensemble r1, combinando quatro modelos abertos de previsão de séries temporais em zero-shot, sem retreino.
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação A popularidade da automação de processos com o n8n está em alta, principalmente […]
