
IBM lança o Granite Timeseries Ensemble r1: quatro modelos abertos de previsão de séries temporais em uma só interface
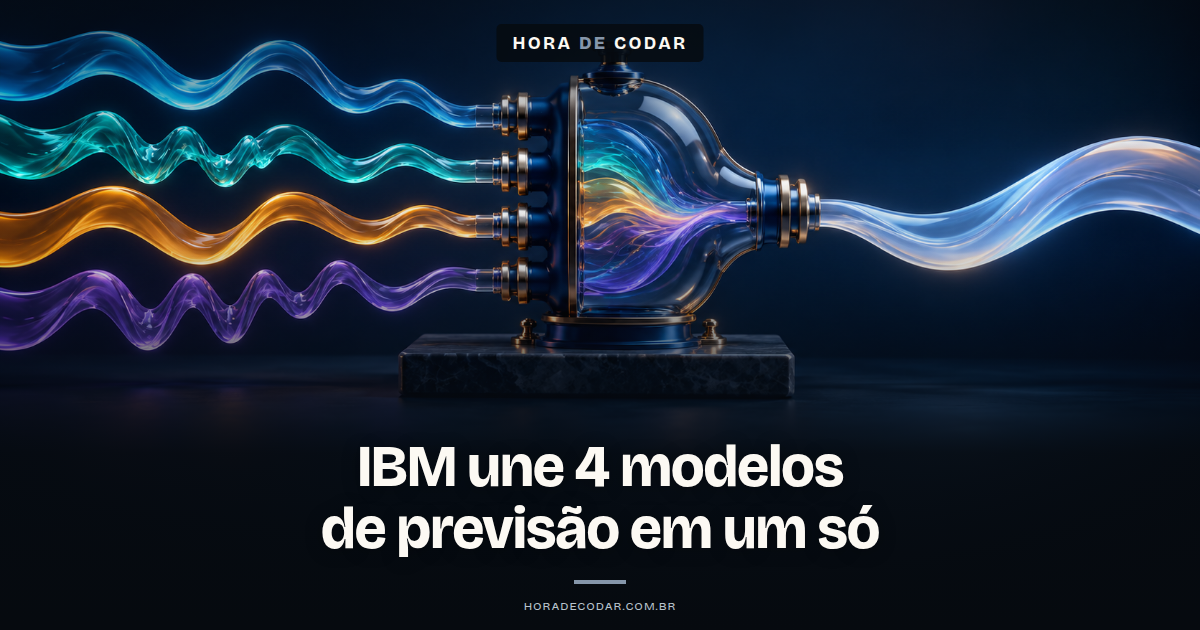
Fala aí, beleza? A IBM Research publicou em 22 de outubro de 2026, no blog do Hugging Face, o Granite Timeseries Ensemble r1: uma receita que junta quatro modelos Granite pré-treinados de previsão de séries temporais em uma só interface
Ele devolve previsão mediana e quantis sem retreino no seu dataset e sem pesos ajustados a partir de erros históricos, e foi pensado pra quem precisa de previsão zero-shot sem ter que escolher um modelo pra cada série 🙂
O que é o Granite Timeseries Ensemble r1 e quais modelos ele combina?
É um ensemble: em vez de apostar tudo em um modelo só, ele combina as previsões de quatro membros com arquiteturas diferentes
- Granite PatchTST-FM-r1: Patched Transformer
- Granite PatchTST-FM-r2: Patched Conformer
- Granite FlowState-r1.1: modelo state-space
- Granite TTM-r3: Tiny Time Mixers (MLP mixer)
E por que juntar quatro modelos?
A IBM explica que modelos pré-treinados até fazem previsão sem treino no seu dataset, mas você ainda precisa escolher um deles
Um modelo que vai bem em sinal industrial suave pode ir mal em demanda de varejo ruidosa ou em horizonte sazonal longo, e o melhor depende da série e da tarefa

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
O ensemble existe pra reduzir essa escolha a um padrão sensato
Se liga num detalhe: a receita guarda a configuração do ensemble, não pesos mesclados dos modelos
Se você conhece um package.json, a ideia é parecida: o arquivo descreve o que montar, e as peças são baixadas depois
O anúncio, Ensemble forecasting with IBM Granite time-series models, é assinado por Fearghal O’Donncha, Chandramouli Kamanchi, Guruprasad Ranjini, Wesley M. Gifford, Natalia Martinez Gil, Bradley Eck, Pankaj Dayama, Roman Vaculin e Ayhan Sebin, todos da IBM Research
Probabilistic Ensemble ou IQR Ensemble: como as previsões são combinadas?
O padrão recomendado pela IBM é o Probabilistic Ensemble, e a alternativa adaptativa é o IQR Ensemble
Cada membro devolve quantis, e as duas receitas usam regras diferentes pra transformar isso em uma distribuição só, com sua mediana
Probabilistic Ensemble: o padrão
Aqui cada membro tem influência igual
Os quantis são agregados em espaço de probabilidade (pooling uniforme) e os quantis pedidos são extraídos do resultado combinado
Como os pesos são fixos, não tem etapa de ajuste nem hiperparâmetro de peso pra tunar quando chega uma série nova
É a receita carregada por padrão, beleza?
IQR Ensemble: a alternativa adaptativa
Esse pondera os membros pela dispersão da previsão: quem tem intervalo mais estreito ganha MAIS influência
O que é esse IQR? É o intervalo interquartil, a distância entre os quantis 25 e 75, e a receita aproxima esse valor a partir dos quantis disponíveis mais próximos deles (com a grade padrão de 0.1 a 0.9, o spread usado é entre os quantis 0.2 e 0.8)
Os pesos variam por amostra, por alvo e por passo do horizonte, e mesmo assim nada é ajustado a partir de erros históricos
Uma regressão isotônica garante que os quantis combinados não se cruzem
Pra quem quer brincar, a receita expõe um parâmetro de temperature (valores mais altos aproximam os pesos do uniforme) e um max_weight opcional pra limitar o peso de um único membro; nas receitas IQR já publicadas, o padrão é temperature=1.0 e max_weight=null (sem limite)

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →Tome cuidado! A própria IBM avisa que intervalo mais estreito não significa previsão mais precisa nem mais bem calibrada
O peso por IQR pode acabar favorecendo um membro confiante demais, por isso a orientação é avaliar o IQR em dados representativos antes de adotar
Como testar o ensemble com o pacote granite-tsfm?
O uso é pelo pacote granite-tsfm (versão 0.3.11 ou superior, segundo o anúncio) com o QuantileEnsembleForecaster
O exemplo abaixo é o oficial da IBM, publicado no anúncio, usando o dataset ETTh1:
pip install "granite-tsfm>=0.3.11"import pandas as pd
from tsfm_public.models.ensemble.modeling_ensemble import QuantileEnsembleForecaster
df = pd.read_csv(
"https://raw.githubusercontent.com/zhouhaoyi/ETDataset/main/ETT-small/ETTh1.csv",
parse_dates=["date"],
)
ensemble = QuantileEnsembleForecaster.from_pretrained(
"ibm-granite/granite-timeseries-ensemble-r1",
)
result = ensemble(
df.tail(1024),
timestamp_column="date",
target_columns=["OT"],
context_length=1024,
prediction_length=24,
)
print(result.prediction_outputs) # previsão pontual
print(result.quantile_outputs) # quantisE o que volta dessa chamada?
prediction_outputs: a previsão pontual, que serve como valor centralquantile_outputs: os quantis, por padrão de 0.1 a 0.9 (nove quantis no total, com o 0.5 usado como previsão pontual no model card)
Os quantis 0.1 e 0.9 formam um intervalo central com cobertura nominal de 80%, então dá pra mostrar uma faixa de previsão e não só um número seco
Pra trocar pra receita IQR avaliada, muda só o subfolder:
ensemble = QuantileEnsembleForecaster.from_pretrained(
    "ibm-granite/granite-timeseries-ensemble-r1",
    subfolder="recipes/granite-iqr",
)
Antecipando o susto: a primeira execução demora mais
Como a receita guarda só a configuração, os quatro checkpoints dos membros são baixados dos próprios repositórios no Hugging Face em tempo de execução, e a IBM orienta reservar tempo (e espaço de armazenamento) extra pra essa primeira rodada
O que muda para devs e times de dados?
Quem mais ganha é quem roda previsão em muitas séries diferentes e não quer escolher, testar e manter um modelo por série
Em vez de montar uma regra tipo "série de varejo vai no modelo X, sensor vai no Y", tu chama uma interface só e recebe mediana + quantis

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.E o ensemble é melhor que o melhor modelo sozinho? A IBM fez essa comparação usando scores e ranks publicados no leaderboard GIFT-Eval, num snapshot capturado em 20 de outubro de 2026: em 97 configurações, o Probabilistic Ensemble teve o menor MASE entre as seis previsões comparadas, 0.683, logo à frente do melhor membro isolado, o PatchTST-FM-r2, com 0.685 (o IQR Ensemble ficou no meio, com 0.684). Esses números estão no anúncio e no model card da IBM (fonte)
Vale notar que no CRPS/MWQL (métrica de calibração probabilística) quem manteve o melhor resultado isolado foi o PatchTST-FM-r2, com 0.467
Repara que a diferença de MASE entre ensemble e melhor membro é pequena
O ganho aqui está MUITO mais em não precisar acertar a escolha do modelo do que em um salto de precisão
Outro ponto massa: a mesma interface pode ser estendida com outros previsores compatíveis, então o ensemble não fica preso só aos quatro Granite
Agora, as pendências:
- Licença: o model card do ensemble exibe
License: apache-2.0no repositório. Já as receitas expandidas (recipes/expanded-linearerecipes/expanded-iqr) usam checkpoints da IBM Research com termos separados, incluindo restrições não comerciais ou de uso em pesquisa: vale conferir se for usar essas variantes - Avaliação e limitações: a configuração completa, os checkpoints dos membros, os detalhes de avaliação e as limitações ficam no model card, e vale ler antes de colocar em produção. A IBM cita, por exemplo, que canais multivariados são previstos de forma independente (sem informação entre canais) e que limites de contexto, horizonte, pré-processamento e tratamento de valores ausentes variam entre os quatro membros
- Custo: são quatro modelos pra baixar e rodar em vez de um, e isso pesa no primeiro uso, na memória e na infraestrutura
Escolher o modelo certo também é tema no mundo dos LLMs
Decidir qual modelo usar pra cada tarefa não é problema exclusivo de séries temporais
No canal tem um vídeo sobre o DeepClaude, mostrando como usar os modelos DeepSeek dentro do Claude Code no lugar dos modelos da Anthropic, configurando isso pelo settings.json e uma chave de API 😀
Próximo passo: rodar o padrão na sua série antes de mexer no IQR
Começa abrindo o model card e confirmando a licença (o repositório exibe apache-2.0, mas as receitas expandidas têm termos próprios) e as limitações, porque isso decide se dá pra usar no seu projeto
Depois roda a receita padrão em uma série tua e compara com o modelo que tu já usa hoje, no mesmo horizonte e com a mesma janela de contexto
Só então testa o IQR, e em dados representativos, como a própria IBM orienta: intervalo bonito e estreito não é sinônimo de previsão certa…
Até o próximo post!
Perguntas frequentes
Dá pra usar o Granite Timeseries Ensemble r1 com dados próprios, além do exemplo ETTh1 do anúncio?
O ETTh1 é só o dataset usado no exemplo oficial da IBM pra ilustrar a chamada, passando a série como dataframe e informando a coluna de timestamp e a coluna alvo nos parâmetros timestamp_column e target_columns. Isso foi confirmado nesse exemplo específico; a própria IBM lista limitações que variam entre os quatro membros do ensemble, como limites de contexto e de horizonte, tratamento de valores ausentes e previsão independente por canal em séries multivariadas (sem informação entre canais). Então, antes de assumir que vai funcionar igual com qualquer série sua, vale testar com os seus dados e consultar o model card.
Quer aprender mais sobre inteligência artificial e programação na prática? Conheça o canal Hora de Codar no YouTube e acompanhe os próximos vídeos.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares

Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação A popularidade da automação de processos com o n8n está em alta, principalmente […]
O que significa “ChatGPT network error” e como resolver
Network error indica falha de comunicação, mas não identifica sozinho a causa. Confira o status do ChatGPT, teste uma nova conversa e uma janela sem […]

Como usar o Antigravity do Google: guia completo do zero ao primeiro app
Aprenda neste guia prático como usar o Antigravity do Google: descubra a instalação, configuração, criação de projetos com o Agent Manager e o primeiro deploy, […]
