
Como classificar texto com embeddings em vez de LLM dentro do agente (e quando o LLM ainda é necessário)
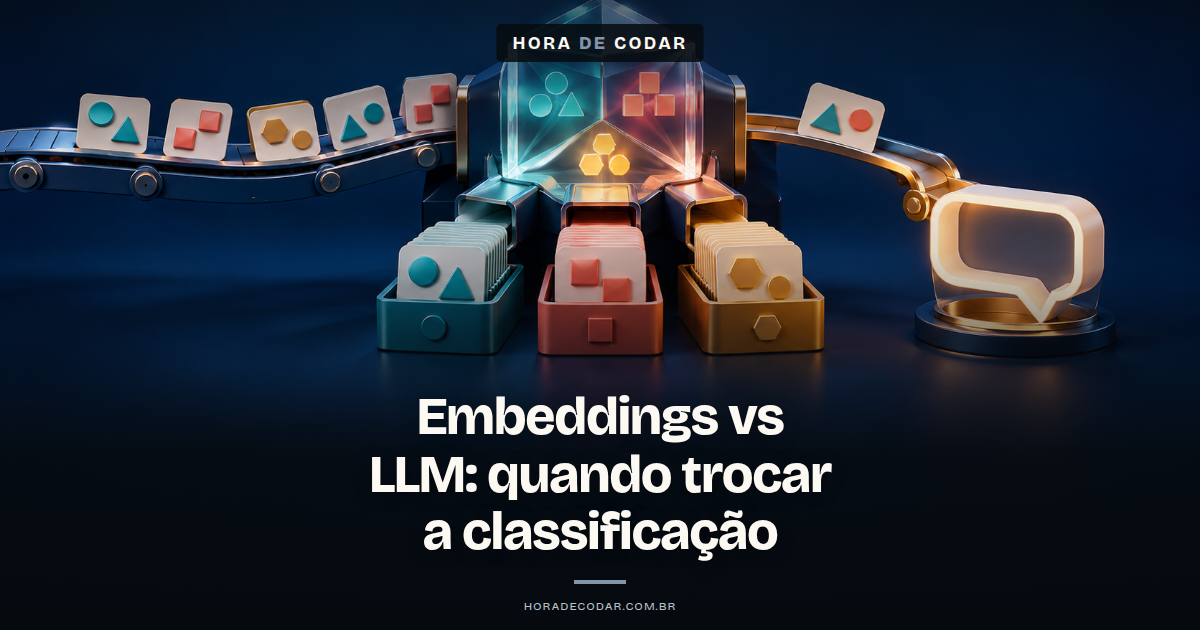
Quando o agente só precisa escolher entre rótulos que já existem (fila do ticket, intenção, duplicata), tu pode gerar embeddings de exemplos rotulados e comparar a mensagem nova por similaridade de cosseno, sem pedir a decisão a um LLM generalista. O LLM continua redigindo a resposta e resolvendo os casos que ficam abaixo do limiar. O limiar não tem valor universal: ele precisa ser calibrado no seu próprio conjunto rotulado, e a troca só vale depois de um teste comparativo com os seus dados
Fala aí, beleza? Se o teu agente faz uma chamada inteira de LLM só pra decidir se a mensagem é do financeiro ou do suporte, esse post é pra você 🙂
A ideia aqui é a mesma do padrão quem decide não é quem redige: no Jev a decisão vai para um modelo de decisão tipada, e aqui ela vai para uma busca vetorial. São alternativas diferentes para o mesmo problema
E não é gambiarra: a documentação de embeddings da OpenAI lista a classificação, em que o texto recebe o rótulo mais parecido, como um dos usos comuns
O recorte é este: rótulos conhecidos, exemplos reais já rotulados e um LLM que continua no fluxo só onde ele faz falta
Em que pontos do agente o embedding entra no lugar do LLM
O embedding entra em toda etapa que responde à pergunta: com qual dos rótulos que eu já tenho este texto mais se parece?
Na prática, isso aparece em três lugares do fluxo
Triagem de tickets: qual fila recebe?
Entra o texto do ticket, sai o nome da fila
O ticket vira um vetor, é comparado com os vetores dos tickets antigos já rotulados, e os vizinhos mais próximos (k-NN, os k exemplos mais parecidos) votam na fila
Quem redige depois é o LLM, ou o humano da fila, já sabendo o contexto

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
Roteamento de intenção: qual ferramenta ou subagente?
Entra a mensagem do usuário, sai a intenção, e a intenção aponta para uma ferramenta ou subagente
É o mesmo mecanismo da triagem, só que o rótulo é um destino dentro do agente (buscar pedido, cancelar assinatura, falar com humano e por aí vai)
Quem redige é o subagente escolhido, que recebe só a mensagem que é da conta dele
Detecção de duplicata: isso já apareceu antes?
Entra o item novo, sai sim ou não (e, se sim, qual item parecido já existe)
Aqui não tem rótulo: o item novo é comparado com os itens existentes, e se o cosseno passar do limiar ele é marcado como repetido
Quem redige é o LLM, se for preciso avisar o usuário ou juntar os dois itens
O que você precisa antes de começar
São três coisas, e nenhuma delas é PC da Nasa haha
- Uma chave de API de um fornecedor de embeddings: OpenAI, Gemini API ou Voyage AI
- Um conjunto de textos reais já rotulados pela equipe (tickets antigos, mensagens com a intenção marcada, pares de duplicatas confirmadas)
- Um lote separado, também rotulado, que fica de fora dos exemplos e serve só para teste e calibração
Se liga num detalhe: a Anthropic não tem modelo de embedding próprio
A documentação do Claude sobre embeddings aponta a Voyage AI como opção e recomenda avaliar vários fornecedores
Então, se o teu agente roda com Claude, a parte vetorial vem de outro lugar, e tudo bem
Modelos de embedding para classificação: dimensões, preço e parâmetro de tarefa
A tabela abaixo junta só o que está confirmado na documentação de cada fornecedor (preços de entrada de texto, em dólar, por 1 milhão de tokens)
| Modelo | Fornecedor | Dimensões | Preço por 1M tokens | Parâmetro de tarefa e observações |
|---|---|---|---|---|
| text-embedding-3-small | OpenAI | 1536 (padrão) | US$ 0,02 | dimensions reduz o vetor |
| text-embedding-3-large | OpenAI | 3072 (padrão) | US$ 0,13 | dimensions reduz o vetor |
| gemini-embedding-001 | Google (Gemini API) | 3072 (padrão), recomendadas 3072, 1536 ou 768 | US$ 0,15 online, US$ 0,075 via Batch API, com camada gratuita | task_type=CLASSIFICATION, output_dimensionality reduz o vetor |
| gemini-embedding-2 | Google (Gemini API e Vertex AI) | consulte a documentação | US$ 0,20 online, US$ 0,10 em batch | GA, multimodal, prefixo de tarefa no próprio texto |
| voyage-4-large | Voyage AI | 2048, 1024 (padrão), 512 ou 256 | US$ 0,12 | 200 milhões de tokens grátis por conta, input_type |
| voyage-4 | Voyage AI | 2048, 1024 (padrão), 512 ou 256 | US$ 0,06 | 200 milhões de tokens grátis por conta, input_type |
| voyage-4-lite | Voyage AI | 2048, 1024 (padrão), 512 ou 256 | US$ 0,02 | 200 milhões de tokens grátis por conta, input_type |
Algumas observações que a tabela não mostra:
- O
dimensionsda OpenAI só funciona na família text-embedding-3 e em modelos posteriores - O
task_type=CLASSIFICATIONdo gemini-embedding-001 gera embeddings otimizados para classificar texto em rótulos predefinidos, e a própria Google cita análise de sentimento e detecção de spam como exemplos - O gemini-embedding-2 é multimodal: texto, imagem, vídeo, áudio e documentos ficam no mesmo espaço vetorial
- A Voyage indica o voyage-4-large para a melhor qualidade, o voyage-4-lite para a menor latência e o menor custo, e o voyage-4 como meio-termo
- A família Voyage 4 foi lançada em 15/01/2026 com espaço de embedding compartilhado entre os modelos

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →O que muda em custo, latência e manutenção?
No custo, a conta muda de lugar: os exemplos rotulados viram vetores uma vez e ficam guardados, e cada mensagem nova custa só os tokens dela no preço da tabela
O preço do LLM que tu usaria no lugar depende do modelo e do teu contrato, então a comparação certa é com a tua fatura real, não com número de internet
Na latência, uma chamada de embedding devolve um vetor, sem gerar texto, e a comparação com os exemplos é uma conta local
Isso tende a ser mais leve que gerar uma resposta, mas meça no teu ambiente antes de prometer qualquer coisa pro time
Na manutenção, o trabalho deixa de ser ajustar prompt e passa a ser cuidar dos exemplos: rótulo novo ganha exemplos novos, exemplo errado sai da base
Passo a passo: classificar texto com embeddings e limiar de cosseno
Bora ver na prática? O código abaixo é um exemplo didático, independente de fornecedor: a função embed() é um ponto de troca onde entra a chamada do SDK que você escolheu
- Monte os exemplos rotulados
Pegue poucos exemplos por rótulo, mas reais e variados: mensagem curta, mensagem longa, com erro de digitação, com gíria, tudo que o teu usuário escreve de verdade
Separe desde já o lote de validação, que não entra na base de exemplos
Erro comum deste passo: escrever só frases inventadas e bonitas (tipo ‘Gostaria de solicitar o reembolso do meu pedido’). O usuário real escreve ‘cade meu dinheiro???’ e a base não reconhece kkk
- Gere os embeddings com o parâmetro de tarefa certo
Cada fornecedor tem o seu jeito de dizer qual é a tarefa:
- gemini-embedding-001:
task_type=CLASSIFICATION - gemini-embedding-2: a Google recomenda colocar a tarefa no próprio texto, com o prefixo
task: classification | query: {conteúdo} - Voyage:
input_typeaceitanull(padrão),queryoudocument. Comqueryoudocument, a Voyage acrescenta um prompt voltado para busca, e os vetores gerados com e seminput_typesão compatíveis entre si - OpenAI: não tem parâmetro de tarefa, o texto vai como está
No gemini-embedding-2, o prefixo vai em TODOS os textos, exemplos e consulta:
def com_prefixo(texto):
    return f'task: classification | query: {texto}'

exemplos_prefixados = [com_prefixo(t) for t in textos_exemplo]
consulta_prefixada = com_prefixo(mensagem_nova)
Erro comum deste passo: aplicar o prefixo só na consulta e esquecer dos exemplos. A documentação pede o mesmo formato nos dois lados, de forma consistente. Tome cuidado!
- Calcule a similaridade e escolha entre k-NN e rótulo mais parecido
E o que é similaridade de cosseno? É o quanto dois vetores apontam pra mesma direção: quanto mais perto de 1, mais parecidos os textos
Os embeddings da OpenAI já vêm com norma 1 (inclusive quando você usa dimensions), então o cosseno é só o produto escalar. Para os outros fornecedores, normalizar antes não custa nada e deixa a conta igual pra todo mundo
Aí você escolhe a regra: pegar o rótulo do exemplo mais parecido, ou deixar os k vizinhos mais próximos votarem (k-NN), que segura melhor um exemplo esquisito na base
import numpy as np

# Exemplo didático: troque embed() pela chamada do SDK do seu fornecedor
def embed(textos):
    raise NotImplementedError('chame a API de embeddings aqui')

def normalizar(m):
    m = np.asarray(m, dtype=float)
    return m / np.linalg.norm(m, axis=1, keepdims=True)

# textos reais do seu histórico, já rotulados pela equipe
exemplos = [
    ('fui cobrado duas vezes no cartao', 'financeiro'),
    ('nao consigo entrar na minha conta', 'acesso'),
    # ...
]
textos_exemplo, rotulos = zip(*exemplos)
E = normalizar(embed(list(textos_exemplo)))  # gera uma vez e guarda

def classificar(mensagem, k=5, limiar=None):
    q = normalizar(embed([str(mensagem)]))[0]
    sims = E @ q                      # cosseno, porque tudo tem norma 1
    top = np.argsort(sims)[::-1][:k]
    votos = {}
    for i in top:
        r, s = rotulos[int(i)], float(sims[int(i)])
        votos.update({r: votos.get(r, 0) + s})
    rotulo = max(votos, key=votos.get)
    melhor = sims[top[0]]
    if limiar is not None and melhor < limiar:
        return None, melhor           # None = manda pro LLM
    return rotulo, melhor
Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Com k=1 você tem o rótulo mais parecido puro. Para duplicata, a lógica é a mesma sem votação: compara o item novo com os existentes e olha se o maior cosseno passa do limiar
- Escolha o limiar no lote de validação
O limiar é a nota mínima para o embedding decidir sozinho. Abaixo dele, a mensagem vai pro LLM
Varra vários valores dentro das similaridades que aparecem no teu próprio lote e veja, para cada um, quanto acerta e quanto manda pro fallback:
def avaliar(validacao, limiar):
    aceitos, acertos, fallback = 0, 0, 0
    for texto, esperado in validacao:
        rotulo, _ = classificar(texto, limiar=limiar)
        if rotulo is None:
            fallback += 1
        else:
            aceitos += 1
            acertos += int(rotulo == esperado)
    return acertos / max(aceitos, 1), fallback / len(validacao)

melhores = [classificar(t)[1] for t, _ in validacao]
for limiar in np.quantile(melhores, np.linspace(0, 1, 11)):
    print(round(float(limiar), 3), avaliar(validacao, limiar))
O resultado esperado é uma tabelinha: limiar, taxa de acerto dos casos aceitos e fração enviada ao LLM. Você escolhe o ponto em que o acerto te deixa tranquilo e o fallback cabe no orçamento
Erro comum deste passo: copiar o limiar de outro projeto ou de um tutorial. Nenhum fornecedor publica um limiar universal, e o valor muda com o modelo, a dimensão e os teus dados
- Faça o teste comparativo mínimo
Passa o MESMO lote rotulado pelos dois caminhos: o classificador por embedding (com o limiar escolhido) e a chamada de LLM que você usa hoje
Compare três coisas:
- acertos de cada caminho
- quantos casos o embedding mandou pro fallback
- custo: tokens do lote vezes o preço da tabela, contra o que o LLM custou no mesmo lote
Checagem final: monte a matriz de acertos por rótulo (esperado na linha, previsto na coluna) no teu próprio conjunto
from collections import Counter

matriz = Counter()
for texto, esperado in validacao:
    previsto, _ = classificar(texto, limiar=limiar_escolhido)
    matriz[(esperado, previsto or 'LLM')] += 1

for (esperado, previsto), n in sorted(matriz.items()):
    print(esperado, '->', previsto, n)
Se um rótulo específico vive caindo no fallback ou sendo confundido com outro, é ali que faltam exemplos. Simples assim 😀
Onde a classificação por embedding falha
O embedding não é bala de prata, e esses são os três lugares onde ele costuma escorregar
Caso ambíguo: dois rótulos quase empatados
Sintoma: a mensagem fica entre dois rótulos e a resposta muda com qualquer detalhe (‘quero cancelar porque cobraram errado’ é cancelamento ou financeiro?)
Causa: falta margem entre o primeiro e o segundo rótulo mais parecidos
Solução: limiar mais fallback: o que não passa da nota mínima vai pro LLM decidir
Como prevenir: além do limiar, olhe a diferença entre o primeiro e o segundo colocado no lote de validação, e trate empate apertado como caso de fallback
Rótulo novo ou redefinido
Sintoma: depois que o time criou uma fila nova ou mudou o que cabe em cada fila, os erros aumentam
Causa: os exemplos ficaram desatualizados e ainda descrevem o mundo antigo
Solução: atualizar os exemplos e reembedar a base
Ao trocar de modelo ou de dimensão, refaça TODOS os vetores. Misturar vetores de origens diferentes só é seguro onde a documentação garante compatibilidade, como no espaço compartilhado da família Voyage 4 e nos vetores Voyage gerados com e sem input_type
Como prevenir: guarde junto de cada vetor o modelo e a dimensão que o geraram, e trate mudança de rótulo como mudança de código: com revisão e novo teste no lote de validação
Necessidade de justificativa
Sintoma: alguém pergunta ‘por que esse ticket foi pra essa fila?’ e tudo que você tem é um número
Causa: o cosseno mede parecença, não explica a decisão
Solução: quando a justificativa faz parte do requisito, a decisão volta para o LLM ou para um modelo de decisão tipada, e a comparação de Jev contra LLM de chat ajuda a escolher entre os dois
Como prevenir: mapeie antes quais etapas precisam de explicação (auditoria, cliente contestando, compliance) e não coloque embedding puro nelas
Quando o LLM continua necessário (e quando um modelo menor basta)
O LLM não sai do agente, ele só para de fazer o trabalho de triagem
Ele continua redigindo a resposta, justificando decisões quando alguém pede e resolvendo os casos que ficaram abaixo do limiar
E nem toda tarefa que sobra pede o modelo mais caro: vale testar modelos menores nas etapas mais simples, sempre com o mesmo lote de validação como régua
Se tu quer conhecer mais do canal, tem um vídeo do Hora de Codar sobre o FreeLLMAPI, que fala de acesso a APIs de LLM:
Próximo passo: rodar o teste no seu próprio dataset
Escolhe UMA etapa do agente, a triagem por exemplo, e separa um lote rotulado só dela
Roda a comparação do passo 5, olha a matriz de acertos e só troca a chamada se os números do teu conjunto justificarem
Se no meio do caminho tu perceber que aquela etapa precisa de decisão tipada com justificativa, o caminho é o Jev, e o catálogo de decisões do Jev mostra como documentar cada chamada quando o time cresce
Até o próximo post! 🙂
Perguntas frequentes
Preciso de um banco de dados vetorial para classificar texto com embeddings?
Não necessariamente. Enquanto a base de exemplos rotulados for pequena, dá pra guardar os vetores numa estrutura simples na memória, como no exemplo em numpy do passo a passo. Um banco vetorial dedicado entra em cena quando essa base cresce demais pra caber e ser comparada rápido em memória.
Quantos exemplos por rótulo são necessários para começar a classificar com embeddings?
Não existe um número fixo publicado pelos fornecedores. O jeito certo é começar com poucos exemplos reais e variados por rótulo, como no passo 1, e usar o lote de validação pra ver se o acerto já está bom o suficiente.
Quer aprender mais sobre inteligência artificial e programação na prática? Conheça o canal Hora de Codar no YouTube e acompanhe os próximos vídeos.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares

Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação A popularidade da automação de processos com o n8n está em alta, principalmente […]
O que significa “ChatGPT network error” e como resolver
Network error indica falha de comunicação, mas não identifica sozinho a causa. Confira o status do ChatGPT, teste uma nova conversa e uma janela sem […]

Como usar o Antigravity do Google: guia completo do zero ao primeiro app
Aprenda neste guia prático como usar o Antigravity do Google: descubra a instalação, configuração, criação de projetos com o Agent Manager e o primeiro deploy, […]
