
Embeddings locais com Ollama para RAG: quando vale a pena gerar na sua
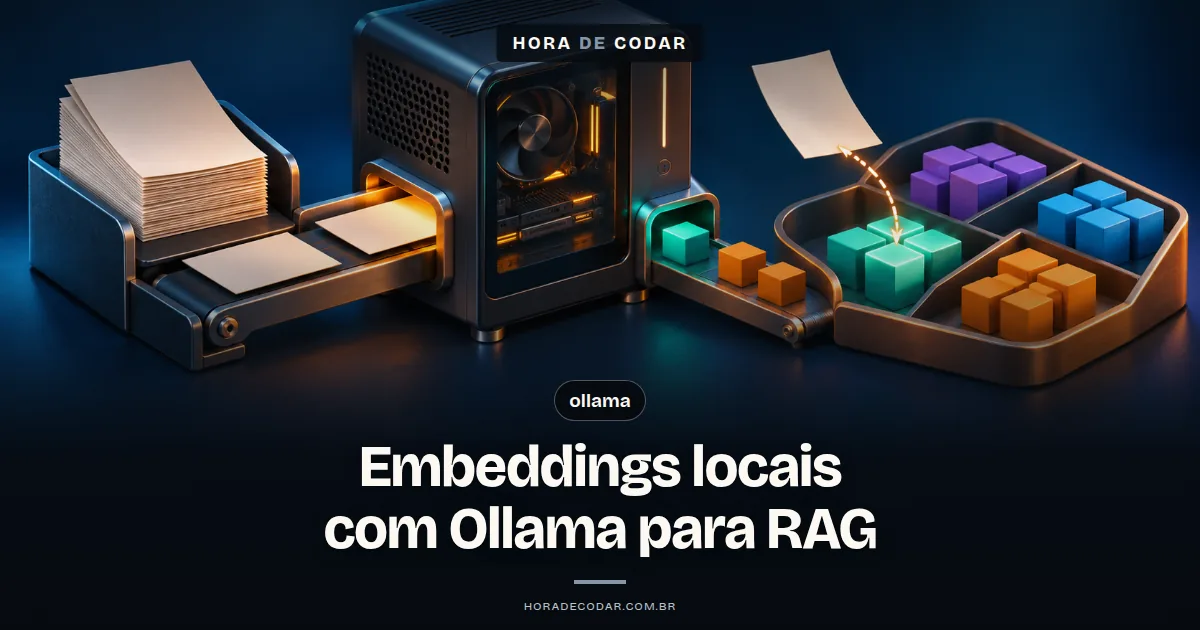
Gerar embeddings locais com Ollama compensa em três situações: quando os documentos são sensíveis e não podem sair da sua máquina, quando o acervo é reindexado com frequência e quando o volume de tokens torna o custo recorrente da API relevante. Fora desses cenários, uma API paga costuma resolver com menos manutenção.
Se liga no recorte: este post trata só da etapa de embeddings do RAG. Decidir se o modelo de chat que escreve a resposta roda local é outra conversa, já discutida em rodar IA local com Ollama. A decisão sai de critérios concretos: privacidade, custo, reindexação, contexto e dimensões.
O que são embeddings locais e onde entram no pipeline de RAG
Embeddings são vetores numéricos que representam o significado de um texto. Segundo a documentação de embeddings do Ollama, esses vetores podem ser guardados em um banco vetorial, buscados por similaridade ou usados em pipelines de RAG, tudo com o modelo rodando na sua máquina.
E como a busca acontece? Você transforma a pergunta do usuário em vetor e compara com os vetores dos documentos. A documentação recomenda a similaridade de cosseno para a maioria dos casos de busca semântica.
Pensa no RAG como uma biblioteca com bibliotecário. O modelo de embedding organiza o catálogo e encontra os trechos certos. O modelo de chat lê esses trechos e escreve a resposta.
São duas peças independentes. Você pode gerar os vetores localmente e mandar a resposta final para um modelo na nuvem, ou o contrário.

Black Week do Nexus
A formação de IA mais completa do Brasil
- 7 formações · 112 cursos · 26 mil alunos
Quais modelos de embedding o Ollama oferece e como eles se diferenciam
A documentação oficial recomenda três modelos de embedding: embeddinggemma, qwen3-embedding e all-minilm. O blog do Ollama sobre modelos de embedding também apresenta mxbai-embed-large e nomic-embed-text como exemplos, junto com um exemplo de RAG.
A tabela reúne só o que está publicado nas fontes oficiais. Onde a célula diz "não consta nas fontes consultadas", o dado simplesmente não foi confirmado.
| Modelo | Tamanho | Contexto por entrada | Dimensões do vetor | Idiomas | Versão mínima do Ollama | Onde aparece |
|---|---|---|---|---|---|---|
| embeddinggemma (Google) | 300M parâmetros | 2K tokens | 768, ou 512/256/128 via MRL | Treino com mais de 100 idiomas | v0.11.10+ | Recomendado na documentação |
| qwen3-embedding | 0.6B, 4B e 8B | 32k | Até 4096, configurável de 32 a 4096 | Multilíngue, herdado do modelo base | Não consta nas fontes consultadas | Recomendado na documentação |
| all-minilm | 23M | Não consta nas fontes consultadas | Não consta nas fontes consultadas | Não consta nas fontes consultadas | Não consta nas fontes consultadas | Recomendado na documentação |
| nomic-embed-text | 137M | Não consta nas fontes consultadas | Não consta nas fontes consultadas | Não consta nas fontes consultadas | 0.1.26+ | Exemplo no blog do Ollama |
| mxbai-embed-large | 334M | Não consta nas fontes consultadas | Não consta nas fontes consultadas | Não consta nas fontes consultadas | Não consta nas fontes consultadas | Exemplo no blog do Ollama |
As fontes de cada linha: a página do embeddinggemma na biblioteca (tamanho e versão mínima), o model card do EmbeddingGemma no Google AI for Developers (contexto, dimensões e idiomas), a página do qwen3-embedding e a página do nomic-embed-text.
Para instalar qualquer um deles, você usa ollama pull seguido do nome do modelo, como indica a biblioteca oficial do Ollama:
ollama pull embeddinggemmaTome cuidado com a versão. Se o seu Ollama for anterior à v0.11.10, o EmbeddingGemma não vai rodar. Atualize antes de culpar o modelo.
Como funciona o endpoint /api/embed em localhost:11434
O endpoint nativo de embeddings do Ollama recebe um POST em http://localhost:11434/api/embed com dois campos: model e input.
Este é o exemplo da documentação do /api/embed:
curl http://localhost:11434/api/embed -d '{"model": "embeddinggemma", "input": "Why is the sky blue?"}'O campo input aceita uma string ou uma lista de strings. Isso permite mandar vários trechos em uma única requisição, o que ajuda muuuito na indexação. Um exemplo didático de lote, com trechos inventados:

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →curl http://localhost:11434/api/embed -d '{"model": "embeddinggemma", "input": ["Política de férias da empresa", "Procedimento de reembolso de despesas"]}'Os vetores voltam normalizados em L2, ou seja, com comprimento unitário. Na prática, isso conversa bem com a similaridade de cosseno recomendada pela documentação.
Os parâmetros que mais importam no RAG:
truncate: o padrão étruee corta entradas maiores que a janela de contexto do modelo. Comfalse, a API retorna erro em vez de cortar.dimensions: define quantas dimensões gerar, mas só funciona em modelos que suportam redução de dimensão.keep_alive: controla quanto tempo o modelo fica carregado na memória depois da requisição. O padrão é5m.
observe no truncate. Com o padrão ligado, um trecho grande demais é cortado sem aviso e o fim dele nunca entra no vetor. Durante a validação, rodar com false mostra exatamente quais trechos passam do limite.
Dois avisos de compatibilidade. O endpoint antigo /api/embeddings foi descontinuado em favor do /api/embed, então código e tutorial antigos podem estar apontando para a rota errada.
E existe uma camada compatível com a OpenAI em http://localhost:11434/v1/embeddings, útil para reaproveitar código escrito para a API da OpenAI. A documentação de compatibilidade descreve esse recurso como experimental e sujeito a mudanças.
Embeddings locais ou API paga: o que comparar antes de decidir
A escolha depende de cinco critérios: privacidade do documento, custo por token, volume de reindexação, janela de contexto por entrada e dimensões do vetor. A tabela usa a OpenAI como referência de API, com os preços publicados nas páginas do text-embedding-3-small e do text-embedding-3-large.
| Critério | Local com Ollama | API da OpenAI |
|---|---|---|
| Privacidade | O texto é processado na sua máquina | O texto é enviado a um terceiro |
| Custo | Hardware e tempo de máquina, sem cobrança por token | text-embedding-3-small: US$ 0,02 por 1 milhão de tokens. text-embedding-3-large: US$ 0,13 por 1 milhão (US$ 0,065 via Batch API) |
| Reindexação | Cada rodada consome tempo de máquina | Cada rodada volta a ser cobrada por token |
| Contexto por entrada | 2K tokens (embeddinggemma) ou 32k (qwen3-embedding) | 8.192 tokens (text-embedding-3-small) |
| Dimensões | 768 ou menos (embeddinggemma), de 32 a 4096 (qwen3-embedding) | 1.536 (text-embedding-3-small) |
O custo local não aparece em dólar, e isso é proposital. Ele depende do seu hardware, da energia e do tempo que a máquina fica ocupada.
O preço da API também é baixo por token. A conta só fica relevante quando o volume é grande ou quando a mesma base é reprocessada várias vezes.
A janela de contexto pesa no chunking. Com 2K tokens no EmbeddingGemma, seus trechos precisam ser menores do que no qwen3-embedding, que aceita 32k.
Quando gerar vetores na sua máquina compensa (e quando não)
Gerar vetores localmente compensa quando o dado não pode sair de casa, quando a reindexação é frequente ou quando você está prototipando. A API faz mais sentido em acervos pequenos e estáveis, ou quando falta máquina.

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Cenários em que o local compensa
- Documentos sensíveis ou internos: contratos, dados de clientes, documentação interna. Se a política da empresa não permite mandar esse texto para terceiros, o local resolve a etapa de indexação sem esse envio.
- Acervos reindexados com frequência: base de conhecimento que muda toda semana, mudanças no chunking, testes de estratégia. Na API, cada rodada volta a custar por token.
- Protótipos e testes de RAG: dá para montar o pipeline inteiro sem chave de API e sem se preocupar com a fatura enquanto ajusta os trechos.
Cenários em que a API pode fazer mais sentido
- Acervo pequeno e estável: indexa uma vez e consulta. O gasto por token tende a ser pequeno diante do esforço de manter infraestrutura local.
- Sem máquina para os modelos maiores: o qwen3-embedding de 8B é bem maior que o EmbeddingGemma de 300M. Se o seu hardware não aguenta, a API evita a dor de cabeça.
- Equipe que não quer manter servidor: rodar local significa cuidar de versão do Ollama, de modelo baixado e de máquina ligada.
Trocar de modelo de embedding exige reindexar tudo
A documentação do Ollama orienta usar o mesmo modelo de embedding para indexar e para consultar. Na prática, trocar de modelo obriga a regerar os vetores de todo o acervo, seja de um modelo local para outro ou da API para o local.
Por quê? Cada modelo organiza o significado de um jeito próprio. Comparar a pergunta vetorizada pelo modelo A com documentos vetorizados pelo modelo B é como buscar um endereço com o mapa de outra cidade.
Isso muda o jeito de escolher. Vale pensar no modelo para o longo prazo, porque cada troca significa refazer a indexação inteira.
Na API, essa reindexação é cobrada de novo a cada troca. No local, ela custa tempo de máquina.
O mesmo raciocínio vale para o parâmetro dimensions. Isso não aparece como regra na documentação, mas é consequência lógica: um vetor de 256 dimensões e outro de 768 não têm o mesmo formato. Se você mudar a dimensão no meio do caminho, a base antiga e as consultas novas deixam de se comparar.
Veredito: embeddings locais com Ollama valem a pena para quem?
Embeddings locais com Ollama valem a pena para quem lida com dados sensíveis, reindexa com frequência ou quer prototipar RAG sem custo por token. A API serve melhor a acervos pequenos e estáveis ou a quem não quer manter máquina local.
O ponto de partida depende do perfil, sempre com base no que está documentado e não em desempenho medido:
- Trechos curtos e máquina modesta: o EmbeddingGemma tem 300M parâmetros e contexto de 2K. É um começo leve, desde que seu chunking caiba nessa janela.
- Documentos longos ou necessidade de ajustar dimensões: o qwen3-embedding aceita 32k de contexto e de 32 a 4096 dimensões, com tamanhos de 0.6B a 8B.
- Teste rápido de pipeline: o all-minilm, com 23M, é o menor da lista recomendada.
Qual deles busca melhor no seu conteúdo? Não dá para responder sem testar no seu acervo, e é isso que a próxima seção resolve.
Próximo passo: valide com uma amostra do seu acervo
Antes de indexar tudo, pegue algumas dezenas de trechos reais do seu acervo e faça uma rodada de validação. Bora ver o roteiro:
- Baixe o modelo escolhido com
ollama pull embeddinggemma(ou o nome do modelo que você escolheu). O erro comum deste passo é ter um Ollama antigo: o EmbeddingGemma exige v0.11.10 ou superior. - Envie os trechos em lote para
http://localhost:11434/api/embed, passando uma lista no campoinput. O erro comum aqui é usar a rota descontinuada/api/embeddingsde algum tutorial antigo. - Repita a chamada com
"truncate": false. Se algum trecho passar da janela de contexto, a API retorna erro, e você descobre que precisa de chunks menores ou de um modelo com contexto maior. - Faça algumas consultas reais e confira se os trechos devolvidos pela similaridade de cosseno fazem sentido para a pergunta.
Se a amostra passar, você indexa o resto com confiança. Se não passar, trocar de modelo agora custa umas dezenas de trechos em vez do acervo inteiro.
E se você também está avaliando rodar o modelo de chat na sua máquina, o post sobre rodar IA local com Ollama discute essa outra metade do pipeline.
Perguntas frequentes
Preciso estar conectado à internet para usar o endpoint /api/embed depois de instalado?
A chamada ao /api/embed é feita contra http://localhost:11434, ou seja, roda inteiramente na sua máquina depois que o modelo já foi baixado com ollama pull. A internet só entra no momento do download inicial do modelo.
Fontes consultadas
Consulta em .
Encontre outros guias no YouTube da Hora de Codar. Se quiser aprofundar o contexto, veja Codex Grátis E Ilimitado: Rodando 100% Local Com Ollama (APENAS 1 Comando).
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares

Como escolher o modelo de embeddings do seu RAG testando com as perguntas reais do seu produto
Entenda como escolher o modelo de embeddings do seu RAG testando perguntas reais do produto e comparando acerto e custo entre modelos.
Como classificar texto com embeddings em vez de LLM dentro do agente (e quando o LLM ainda é necessário)
Entenda quando classificar texto com embeddings substitui o LLM no agente, como calibrar o limiar de similaridade e por que testar com seus dados antes de trocar.
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação A popularidade da automação de processos com o n8n está em alta, principalmente […]
