
Google LLM: quais modelos de linguagem o Google oferece e onde usar cada um em 2026

Google LLM não é um modelo só: são três famílias. O Gemini (fechado) é acessado pelo app de chat, pela API no Google AI Studio e pelo Gemini Enterprise Agent Platform. O Gemma 4 é aberto, sob Apache 2.0, e roda na sua máquina. O Gemini Nano roda offline dentro do Android. Para API, o Gemini 3.8 Flash é o modelo de uso geral mais recente e tem preço introdutório até 31/12/2026. O Gemini 3.1 Pro cuida do raciocínio pesado e segue em preview. Para programar, o Antigravity substituiu o Gemini CLI
Fala aí, beleza? Quando alguém pesquisa "Google LLM", espera achar UM modelo, mas o Google tem três famílias bem diferentes 😀
Tem o Gemini (fechado, via chat e API), o Gemma (aberto, roda na sua máquina) e o Gemini Nano (roda dentro do próprio Android)
Cada um entra por um caminho diferente: interface de chat, API, ferramenta de código, modelo local e app mobile
Neste post eu mapeio qual modelo existe hoje, por onde tu acessa cada um e pra que tipo de tarefa cada caminho faz sentido, beleza?
Bora!
Quais modelos de linguagem o Google oferece em 2026
Antes de escolher, vale ver o cardápio inteiro numa tabela só
| Modelo | Tipo | Onde acessa | Uso típico |
|---|---|---|---|
| Gemini 3.8 Flash | Fechado | API Gemini (Google AI Studio e Agent Platform) | Modelo de uso geral mais recente, lançado em 2/9/2026, com foco em engenharia de software de longo horizonte, agentes autônomos e fluxos corporativos complexos |
| Gemini 3.1 Pro | Fechado (preview) | API Gemini, ID gemini-3.1-pro-preview |
Raciocínio de ponta, com 1.048.576 tokens de entrada (1M) e até 65.536 tokens de saída |
| Gemini 3.5 Flash-Lite | Fechado | API Gemini | Versão Lite que faz parte da linha atual |
| Gemini 3.8 Live e Gemini 3.8 Flash TTS | Fechado | API Gemini | Também fazem parte da linha atual da família Gemini 3 |
| Gemma 4 | Aberto (Apache 2.0) | Hugging Face, Kaggle e ferramentas locais | Rodar na sua máquina: E2B, E4B, 12B Unified, 26B MoE e 31B Dense, com contexto de até 256K tokens |
| Gemini Nano | No aparelho | Android, via AICore | IA dentro do app, sem internet |
A linha atual da família Gemini 3 na API ainda tem o Gemini 3.7 Flash, o 3.6 Flash e o 3.5 Flash, ou seja, tem bastante opção de Flash na mesa

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
O que significam stable, preview, latest e experimental?
Os modelos Gemini são publicados em quatro tipos de versão: stable, preview, latest e experimental
Isso importa mais do que parece: modelos preview e experimentais têm limites de uso mais apertados no nível gratuito
E o Gemini 3.1 Pro, que é o topo de raciocínio do Google, continua em preview desde o lançamento em 19/02/2026
Então se tu vai colocar algo em produção, olha o tipo de versão antes de olhar só o nome do modelo 🙂
Os Gemini 2.5 estão sendo aposentados:
Tome cuidado aqui!
Desde 18/09/2026, só projetos que já usavam os modelos 2.5 têm acesso a eles
Projeto novo recebe a mensagem "no longer available to new users"
No Gemini Enterprise Agent Platform (o antigo Vertex AI), a aposentadoria do gemini-2.5-pro, do gemini-2.5-flash e do gemini-2.5-flash-lite está marcada para 20/10/2026
Na Gemini Developer API, quem já usava pode continuar até novo aviso, mas eu não começaria nada novo em cima deles
Gemini no chat: planos no Brasil e quando vale pagar
O caminho mais simples é o app Gemini, aquele chat que tu abre e conversa, sem API e sem código
No Brasil, os planos são estes:
| Plano | Preço | Limites |
|---|---|---|
| Gratuito | R$ 0 (com Conta Google) | Base de comparação |
| Google AI Plus | R$ 24,99/mês | 2x maiores que o gratuito |
| Google AI Pro | R$ 96,99/mês | 4x maiores que o gratuito |
| Google AI Ultra | R$ 779,90/mês | Até 5x a capacidade do Pro |
| Google AI Ultra (opção maior) | R$ 999,90/mês | Até 20x a capacidade do Pro |
O Ultra, aliás, caiu de R$ 1.209,90 para R$ 779,90/mês, e aí surgiu a opção de R$ 999,90 pra quem quer mais capacidade
Qual plano do Gemini faz sentido pra você?
- Gratuito: pra quem usa o chat de vez em quando, tira dúvida, revisa um texto e tal
- AI Plus: pra quem bate no limite do gratuito com frequência e quer o dobro sem gastar muito
- AI Pro: pra quem usa todo dia como ferramenta de trabalho. Tem um bônus pro dev: é um dos planos que aumenta a cota do Antigravity, a plataforma de agentes de código do Google (explico ela na seção sobre o fim do Gemini CLI, mais abaixo)
- AI Ultra: só pra uso MUITO pesado, o tipo de gente que passa o dia inteiro em cima da IA. Pra maioria é exagero
Minha regra prática: começa no gratuito e só sobe quando o limite realmente atrapalhar teu dia
Pagar plano "porque sim" é dinheiro jogado fora haha
API Gemini: como o dev acessa os modelos do Google
Agora sim, o caminho que interessa pra quem programa
A porta de entrada é o Google AI Studio, o ambiente no navegador pra testar prompts com os modelos Gemini
E o melhor: ele gera chave de API gratuita sem pedir cartão 😀
O nível gratuito da API Gemini:
A maioria dos modelos Flash e Flash-Lite atuais e o Gemini Embedding aparecem como "free of charge"
Ficam de fora do nível gratuito: Veo 3.1, Lyria, os modelos Pro Image e o Computer Use Preview
Dois detalhes que muita gente ignora:
- Seus dados: o uso no nível gratuito pode ser usado pra melhorar produtos do Google. Se o projeto tem dado sensível, pensa duas vezes
- Limites: o Google não publica mais limites fixos por modelo. Os limites ativos aparecem por projeto no console de rate limit do AI Studio, e são mais apertados em modelos preview e experimentais
Ou seja, se alguém te passar "o limite é X requisições por minuto", desconfia e confere no teu console
Dá pra usar a biblioteca da OpenAI com o Gemini?
Dá, e isso é muito massa!
A API Gemini é compatível com as bibliotecas da OpenAI (Python e JS/TS) e com REST
Você troca a api_key pela chave do Gemini e o base_url por https://generativelanguage.googleapis.com/v1beta/openai/, e a própria doc fala em mudar 3 linhas

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →Se você já tem código usando o SDK da OpenAI, fica mais ou menos assim:
from openai import OpenAI

client = OpenAI(
    api_key="SUA_CHAVE_GEMINI",
    base_url="https://generativelanguage.googleapis.com/v1beta/openai/"
)

response = client.chat.completions.create(
    model="gemini-3.1-pro-preview",
    messages=[{"role": "user", "content": "Explique o que é um LLM em duas frases"}]
)

print(response.choices[0].message.content)
A lógica é a mesma de quando você usa um proxy pra conectar vários modelos de IA no mesmo fluxo: o formato de chamada não muda, só o destino
Porém, se você precisa de algum recurso exclusivo do Gemini, a recomendação do Google é usar o SDK nativo
E o Vertex AI?
O Vertex AI virou o Gemini Enterprise Agent Platform
Foi anunciado em 22/04/2026 no Google Cloud Next ’26 como evolução do Vertex AI, e todos os serviços do Vertex AI agora rodam dentro dele
Na prática: AI Studio pra testar e prototipar, Agent Platform quando o projeto é corporativo e vive dentro do Google Cloud
Quanto custa usar os modelos Gemini na API
Preços por 1M de tokens:
| Modelo | Entrada | Saída | Observação |
|---|---|---|---|
| Gemini 3.8 Flash (introdutório) | US$ 0,75 | US$ 3,75 | Até 31/12/2026 |
| Gemini 3.8 Flash (padrão) | US$ 1,50 | US$ 7,50 | A partir de 1/1/2027 |
| Gemini 3.1 Pro (prompt até 200 mil tokens) | US$ 2,00 | US$ 12,00 | Preview |
| Gemini 3.1 Pro (prompt acima de 200 mil tokens) | US$ 4,00 | US$ 18,00 | Cobrado sobre a requisição inteira |
| Gemini 2.5 Flash-Lite | US$ 0,10 | US$ 0,40 | Mais barato da tabela, mas só projetos antigos têm acesso |
Se liga em dois detalhes
O preço introdutório também vale pro Gemini 3.7 Flash e pro 3.6 Flash, no Google AI Studio e no Gemini Enterprise Agent Platform, até 31/12/2026
E no 3.1 Pro, passou de 200 mil tokens de prompt, o preço maior vale pra requisição INTEIRA, não só pro excedente
Quando o Pro compensa e quando o Flash resolve?
O Flash resolve a maior parte do dia a dia: agente, automação, código, fluxo corporativo, e o próprio Google posiciona o 3.8 Flash pra engenharia de software de longo horizonte
O Pro compensa quando a tarefa pede raciocínio pesado ou um contexto gigante de verdade (lembra do 1M de entrada?)
Mas pensa no custo: mandar um repositório inteiro no Pro acima de 200 mil tokens cai na faixa mais cara
Eu começaria no Flash e só subiria pro Pro quando o Flash claramente não der conta
Gemini CLI saiu de cena: como programar com os modelos do Google agora
Aqui tem uma mudança que pegou muita gente de surpresa
Em 18/06/2026, o Gemini CLI e as extensões de IDE do Gemini Code Assist deixaram de atender o nível gratuito, o AI Pro e o AI Ultra
Hoje o CLI só funciona com:
- chave da API Gemini
- credenciais Vertex/Agent Platform
- licença Gemini Code Assist Standard ou Enterprise
Ou seja, aquele uso "loga com a conta pessoal e sai codando" acabou
O que é o Google Antigravity?
O Google Antigravity 2.0 é a plataforma de agentes de código do Google, lançada em 19/05/2026
Ela vem em várias peças:
- IDE desktop pra macOS, Linux e Windows
- CLI chamada
agy - SDK
- nível Managed Agents dentro da API Gemini
E o Antigravity CLI (agy), lançado em 18/06/2026, substituiu o Gemini CLI, com o mesmo harness de agente da IDE
Um detalhe mto massa: ele aceita modelos Gemini e também de terceiros, como Claude Sonnet e GPT-OSS
Quanto custa o Antigravity?
Tem plano Individual grátis (US$ 0), com limites semanais de agente e completions Tab ilimitadas
Não existe assinatura só do Antigravity: a cota maior vem do Google AI Pro ou do Ultra
Então aquele plano de chat que você paga acaba servindo também pro código, o que é bem conveniente 🙂
Gemma 4: o LLM aberto do Google para rodar na sua máquina
Se o Gemini é o "serviço na nuvem", o Gemma é o modelo que você baixa e roda onde quiser
O Gemma 4 foi lançado em 02/04/2026 pelo Google DeepMind, com pesos abertos sob licença Apache 2.0
Isso é uma mudança importante: as versões anteriores usavam uma licença própria, a Gemma License
Apache 2.0 é licença open source conhecida, então fica muiiito mais tranquilo usar em projeto comercial
Tamanhos e recursos do Gemma 4:
- Saiu em E2B, E4B, 26B MoE e 31B Dense
- O 12B Unified chegou em junho de 2026
- Aceita texto e imagem em todos os tamanhos
- Áudio nos modelos edge
- Contexto de até 256K tokens
Onde baixar e como rodar o Gemma 4?
Os pesos estão no Hugging Face e no Kaggle
E ele roda com as ferramentas que você provavelmente já conhece: llama.cpp, MLX, LM Studio, vLLM, Ollama, Unsloth e SGLang
Se você conhece Docker, pensa no Ollama como algo parecido: tu puxa o modelo e roda local, sem dor de cabeça
O Google tem um guia oficial de Gemma com Ollama, e eu seguiria ele pra pegar o nome certo do modelo (não confia em nome de repositório chutado por aí)
Quando o Gemma 4 faz sentido?
- Privacidade: o dado não sai da sua máquina
- Uso offline: ambiente sem internet ou com rede restrita
- Custo zero por token: você paga o hardware, não a chamada
- Fine-tuning: pesos abertos permitem ajustar o modelo pro seu caso

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Só lembra que modelo grande local pede máquina parruda, não precisa ser PC da Nasa, mas também não é qualquer notebook haha
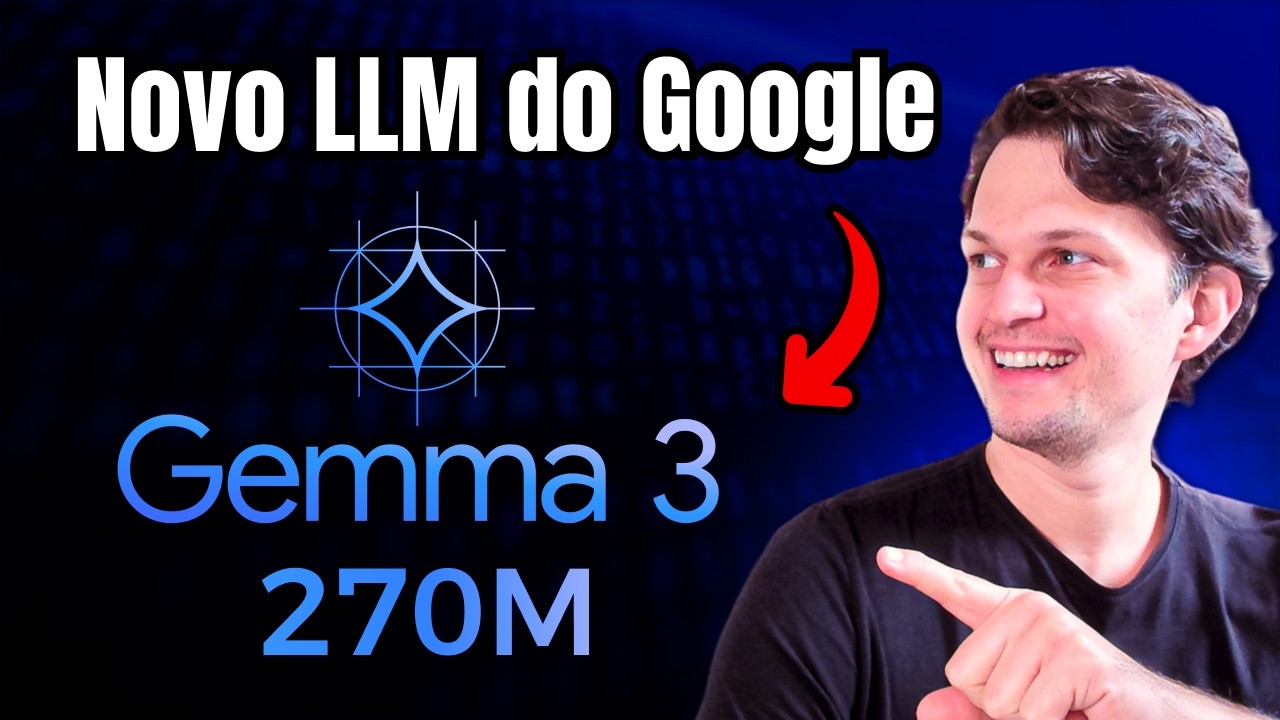
Modelos pequenos do Google na prática: o que eu vi com o Gemma 3 270m
Antes do Gemma 4 existir, eu testei um modelo minúsculo da geração anterior, o Gemma 3 270m
Vale deixar claro: é OUTRA geração, então nada do que eu vi vale como resultado do Gemma 4
Mas a lição sobre escolher o tamanho certo de modelo continua valendo, e muito
Como eu rodei e o que funcionou:
No vídeo abaixo eu mostro o processo: baixei e rodei o modelo localmente com o Ollama, copiando o nome do modelo e colando na busca do Ollama pra instalar
Quando testei com um prompt bem definido, o modelo respondeu corretamente a maior parte do tempo
Porém, em alguns momentos ele "mudava de linguagem" e dava respostas estranhas, fora do esperado
Onde o modelo pequeno falha?
Aí veio o teste que mais me ensinou
Pedi algo vago: "crie um artigo de N8N para explicar o software"
Resultado? Um artigo genérico que nem citava N8N kkk
Então refiz com um prompt detalhado: pedi 1000 palavras, explicação do que é N8N, pra que serve e um exemplo de agente de IA
E aí ele cumpriu a tarefa corretamente 😀
O que eu tirei disso:
Modelo pequeno exige prompt bem coordenado e tarefa de escopo bem definido
Se não for assim, o resultado sai totalmente fora do pedido e atrapalha mais que ajuda
Outra opinião minha: os gráficos comparativos que o Google mostra na documentação tendem a ser tendenciosos, então eu ignoraria eles e testaria na prática
E antes de ir pra produção, testa MUITO, beleza?
Tem também um caso de uso que eu levantei: empresa que não permite software conectado à internet pode precisar de modelos ainda mais leves, dependendo do hardware que tem disponível
Resumindo: não é tão potente quanto LLM maior, mas cumpre bem tarefa pequena, roda em hardware mais fraco e funciona offline
Gemini Nano: IA no próprio Android, sem internet
O terceiro caminho é o mais diferente de todos
O Gemini Nano roda no próprio aparelho Android, sem rede, dentro do AICore (um serviço de sistema do Android)
Que serviço de sistema? Pensa numa peça do próprio Android que hospeda o modelo, e o seu app conversa com ela em vez de mandar dados pra um servidor
Como o dev acessa o Gemini Nano?
São dois caminhos:
- ML Kit GenAI APIs: prontas pra tarefas comuns, como resumo, revisão de texto, reescrita, descrição de imagem e reconhecimento de fala
- Prompt API: de nível mais baixo, pra quando você quer mais controle
Se sua tarefa é uma dessas prontas, eu começaria pelo ML Kit, que é menos trabalho
Quando escolher o Nano em vez de chamar a API?
- Offline: o app precisa funcionar sem internet
- Privacidade: o texto do usuário não sai do aparelho
- Latência: sem ida e volta pra nuvem
Agora, se a tarefa é pesada demais pra um modelo no celular, aí é API Gemini mesmo
Modelos do Google vs as alternativas que o dev já usa
Aqui eu não vou comparar benchmark, até porque número de benchmark de anúncio é exatamente o tipo de gráfico que eu falei pra ignorar
A comparação que importa é de CAMINHO: como os modelos do Google entram no fluxo que tu já tem
| Caminho | Acesso | Aberto ou fechado | Uso em código |
|---|---|---|---|
| API Gemini via biblioteca da OpenAI | Troca api_key e base_url no código que você já tem |
Fechado | Migração rápida de quem já usa o SDK da OpenAI |
| API Gemini via SDK nativo | SDK do Google | Fechado | Recursos exclusivos do Gemini |
| Antigravity | IDE desktop, CLI agy e SDK |
Aceita Gemini e terceiros (Claude Sonnet, GPT-OSS) | Agentes de código com mais de um provedor no mesmo lugar |
| Gemma 4 | Pesos no Hugging Face e Kaggle, roda com Ollama, LM Studio e cia | Aberto (Apache 2.0) | Alternativa local aos modelos que você já roda na máquina |
| Gemini Nano | ML Kit GenAI e Prompt API | No aparelho | IA dentro de app Android |
O ponto mais interessante, pra mim, é o Antigravity aceitar modelo de terceiro
Se você já conhece a família de modelos do Claude, dá pra usar o Claude Sonnet ali dentro sem largar o ecossistema do Google
E a compatibilidade com a OpenAI deixa testar o Gemini muito barato em esforço: troca duas configs e compara com o que você já usa
Qual modelo do Google escolher para cada tarefa
Veredito direto, por perfil:
- Uso geral e agentes na API: Gemini 3.8 Flash. É o mais recente, foi feito pra agentes e engenharia de software, e o preço introdutório (US$ 0,75 / US$ 3,75 por 1M tokens) vale até 31/12/2026
- Raciocínio pesado e contexto longo: Gemini 3.1 Pro, com 1M de entrada. Só lembra que segue em preview e que acima de 200 mil tokens de prompt o preço sobe pra requisição inteira
- Menor custo: o Gemini 2.5 Flash-Lite é o mais barato da tabela, mas só se teu projeto já tinha acesso. Projeto novo, olha os Flash-Lite da linha atual no nível gratuito e na página de preços
- Local e aberto: Gemma 4, sob Apache 2.0
- App mobile offline: Gemini Nano
- Chat do dia a dia: app Gemini, começando no gratuito e subindo de plano conforme o volume
- Programar com agente: Antigravity, que substituiu o Gemini CLI
Ainda usa Gemini 2.5?
Planeja a migração AGORA
No Agent Platform, a aposentadoria do 2.5 Pro, Flash e Flash-Lite está marcada pra 20/10/2026
Na Developer API ainda dá pra continuar até novo aviso, mas "até novo aviso" é o tipo de prazo que aparece do nada… Já vi muito projeto quebrar por deixar migração pra depois
Conclusão: por onde começar com os modelos do Google
O Google LLM, na real, são três famílias: Gemini pra nuvem (chat, API e código), Gemma 4 pra rodar aberto na sua máquina e Gemini Nano pra IA dentro do Android
A escolha depende menos do "melhor modelo" e mais de onde a tarefa precisa rodar e quanto ela pode custar
Meu próximo passo pra você:
- Se a ideia é API, gera a chave gratuita no Google AI Studio e testa o Gemini 3.8 Flash enquanto o preço introdutório vale
- Se a prioridade é rodar local, baixa o Gemma 4 seguindo o guia oficial de Ollama
E independente do caminho: testa na prática com a SUA tarefa, não confia só em gráfico de anúncio 😉
Até o próximo post!
Perguntas frequentes
Qual a diferença entre Gemini, Gemma e Gemini Nano?
São três famílias separadas do Google. O Gemini é fechado e roda via chat ou API, o Gemma é aberto sob licença Apache 2.0 e roda na sua própria máquina, e o Gemini Nano fica dentro do Android, funcionando sem internet através do AICore.
O Gemini 3.1 Pro já saiu do preview?
Não, ele continua em preview desde o lançamento em 19/02/2026, com o ID gemini-3.1-pro-preview. Isso importa porque modelos em preview costumam ter limites de uso mais apertados no nível gratuito da API.
Quanto vai custar o Gemini 3.8 Flash depois do preço introdutório?
A partir de 1/1/2027 o preço padrão sobe para US$ 1,50 por 1M tokens de entrada e US$ 7,50 por 1M tokens de saída. Até 31/12/2026 vale o preço introdutório de US$ 0,75 entrada e US$ 3,75 saída.
O Vertex AI ainda existe ou virou outra coisa?
O Vertex AI foi substituído pelo Gemini Enterprise Agent Platform, anunciado em 22/04/2026 no Google Cloud Next ’26. Todos os serviços que antes rodavam no Vertex AI agora rodam dentro do Agent Platform.
Dá pra usar o Gemini CLI de graça com a conta do Google AI Pro?
Não mais. Como explicado na seção sobre o Gemini CLI, desde 18/06/2026 ele e as extensões de IDE do Gemini Code Assist deixaram de atender o nível gratuito, o AI Pro e o AI Ultra. O CLI hoje só funciona com chave da API Gemini, credenciais Vertex/Agent Platform ou licença Gemini Code Assist Standard ou Enterprise. Pra programar com agente usando a conta pessoal, o caminho agora é o Antigravity CLI (agy), que substituiu o Gemini CLI.
Qual é o modelo mais barato da API Gemini atualmente?
É o Gemini 2.5 Flash-Lite, com US$ 0,10 por 1M tokens de entrada e US$ 0,40 por 1M tokens de saída. Só que ele está na linha 2.5, que tem acesso restrito desde 18/09/2026 e está sendo aposentada, então não é a melhor aposta pra projeto novo.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
Kimi K3, GLM ou DeepSeek: qual modelo barato aguenta refatorar código de verdade?
Kimi K3 vs GLM vs DeepSeek num teste real de refatoração: veja custo por token, erros e retrabalho para escolher o modelo barato certo no Claude Code.
O que é Jev, o System One Model da TypeSafe AI?
Jev é o System One model da TypeSafe AI: entenda como funciona, o que ele resolve e quanto custa esse modelo de decisão estruturada.
O que é o Hy4 preview, o modelo de 770B da Tencent?
O Hy4 preview é o novo modelo da Tencent: MoE de 770B parâmetros (49B ativos), 1M de tokens de contexto e pesos abertos sob Apache 2.0. Veja o que ele faz.
