
Fugu Ultra v2 consegue entregar alto desempenho sem depender de um modelo de fronteira?

O Fugu Ultra v2 é a configuração de desempenho de pico da arquitetura de orquestração multiagente da Sakana AI, lançada junto com o Fugu Max. O ponto central do anúncio: o pool de modelos do Ultra v2 não contém mais Claude Fable 5, Fable 5.1 nem GPT-6-Astra, e mesmo assim a empresa afirma superar os três. O preço é US$ 5 de entrada e US$ 30 de saída por milhão de tokens, com janela de 1.000.000 de tokens. Só que tudo é autorrelatado: não existe página da Artificial Analysis para nenhum modelo Fugu nem reprodução independente dos números
Fala aí, beleza? A Sakana AI acabou de soltar uma afirmação bem ousada: dá pra entregar desempenho de pico SEM depender indispensavelmente dos modelos de fronteira que o próprio sistema orquestra 👀
O lançamento vem em duas configurações, Fugu Max e Fugu Ultra v2, apresentadas no post oficial Introducing Fugu Max and Fugu Ultra v2: Orchestrating the Pareto Frontier
E o detalhe que faz essa notícia valer a leitura não é o placar de benchmark, é a composição do pool: o Fugu Ultra v2 foi lançado com um conjunto de modelos que não contém mais Claude Fable 5, Claude Fable 5.1 nem GPT-6-Astra, e ainda assim a empresa diz superar os três
Se isso se sustentar, muda a conversa sobre vendor lock-in, revogação de API e modelo saindo do ar por controle de exportação
Se não se sustentar, é só mais um argumento de lançamento bonito no slide
Bora destrinchar?

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
O que é o Fugu e por que ele não é um modelo de fundação
Primeiro ponto, porque é aqui que quase todo mundo se confunde: o Fugu não é um modelo de fundação
Ele é um orquestrador treinado, que roteia o trabalho para um pool de OUTROS modelos por trás de uma única API
Na prática, o que ele faz é rotear, delegar, verificar e recombinar trabalho entre modelos de fornecedores diferentes, e te devolver uma resposta só
Se você já usou um roteador de requisições na sua aplicação, a analogia é quase direta: em vez de você escolher o modelo na mão, quem escolhe é uma camada treinada pra isso
E qual a diferença entre o Fugu Max e o Fugu Ultra v2?
Os dois são a MESMA arquitetura central, otimizada para missões distintas
O Fugu Max mira melhor resultado pelo menor custo
O Ultra v2 mira desempenho de pico em tarefas complexas de múltiplas etapas
Não é irmão mais novo e irmão mais velho, é o mesmo motor com afinação diferente, beleza?
O histórico importa aqui:
O Fugu original foi lançado em 22 de junho de 2026, e a versão Ultra daquela geração podia chamar modelos proprietários de fronteira como Claude Opus 4.8, Gemini 3.1 Pro e GPT-5.5
Ou seja: a independência anunciada agora é uma mudança de rota em relação à própria geração anterior do produto
É exatamente por isso que a afirmação virou o centro da notícia, e não um rodapé
Fugu Max e Fugu Ultra v2: preço, contexto e foco de cada um
Todos os valores abaixo são os divulgados nas páginas dos modelos e no anúncio da Sakana
| Item | Fugu Max | Fugu Ultra v2 |
|---|---|---|
| Foco declarado | Melhor resultado pelo menor custo | Desempenho de pico em tarefas complexas de múltiplas etapas |
| Entrada (por milhão de tokens) | US$ 2 | US$ 5 |
| Saída (por milhão de tokens) | US$ 6 | US$ 30 |
| Acima de 272K de contexto | Não divulgado | US$ 10 de entrada e US$ 45 de saída |
| Janela de contexto | Não divulgada | 1.000.000 de tokens |
| Saída máxima | Não divulgada | 128.000 tokens |
Repara na diferença de saída: US$ 6 contra US$ 30 por milhão de tokens
Em volume, isso não é detalhe, isso é a sua fatura inteira
A Sakana também posiciona o preço de saída do Max como 40% a 60% abaixo de Sonnet 5, GPT 5.6 Terra e Kimi K3, e essa comparação é afirmação da própria empresa no anúncio, não medição de terceiro
A página do Fugu Ultra v2 no OpenRouter é onde estão os valores de preço, contexto e saída máxima do Ultra v2
Os benchmarks que a Sakana apresentou (e o que eles não provam)
O placar declarado no anúncio é forte, vamos combinar:
- Fugu Ultra v2 melhor ou empatado em primeiro em 5 de 8 benchmarks: GDP.pdf, Chartography, SWEFish, DeepSWE e Toolathon
- 48,3 em Chartography, contra 27,3 do Opus 5 e 29,5 do Fable 5
- 74,3 em DeepSWE
- Fugu Max com melhor score geral em 6 benchmarks: Terminal Bench 2.1, GPQA Diamond, AA-LCR, GDP.pdf, AutomationBench e SWEFish

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →E aqui já vale a primeira anotação de lápis: GDP.pdf e SWEFish aparecem nas DUAS listas, cada uma com um produto diferente no topo
O anúncio também não deixa claro se as duas listas rodaram o mesmo conjunto de testes, já que uma fala em 5 de 8 e a outra fala em 6 benchmarks
Outro aviso de nomenclatura, pra ninguém se perder: o Opus 5 que aparece no placar não é o mesmo nome do Claude Opus 4.8 citado lá em cima, na geração anterior do Fugu, e o anúncio não diz que são a mesma coisa
Agora a parte chata, que é a parte importante
Score de orquestrador não é score de LLM:
Um sistema de orquestração é comparado com modelos únicos, e isso não é comparação equivalente
O fornecedor controla o prompt, o scaffold, o acesso a ferramentas e também quais resultados publica
Então a paridade com o Fable 5 é paridade POR DECLARAÇÃO, não teste direto de terceiro
E tem outra: não existe página da Artificial Analysis para nenhum modelo Fugu, e nada disso foi reproduzido de forma independente até agora
Todos os números que você leu ali em cima saíram da própria Sakana
Isso não quer dizer que sejam falsos
Quer dizer que ainda são autorrelato, e autorrelato a gente anota com lápis, não com caneta 😀
O que dá para perceber usando um orquestrador multiagente na prática
Eu já testei o Fugu e mostrei no vídeo como ele funciona de verdade, criando projetos pra ver o potencial real do orquestrador
A primeira coisa que fica clara é a natureza da ferramenta: não é um modelo único respondendo, é uma camada escolhendo entre outras IAs pra montar a resposta final
E a segunda coisa é a que mais me incomodou no uso: tu recebe só o resultado
Sem dizer qual IA foi usada, sem mostrar o caminho da escolha
É como contratar uma equipe inteira, receber o entregável na mesa e não ter ideia de quem fez qual parte
Apesar da promessa de ser melhor que os modelos topo de linha, o comportamento que eu observei no teste não confirmou isso do jeito que é divulgado
E a minha ressalva principal continua de pé: colocar o orquestrador acima dos modelos topo de linha num gráfico perde o sentido se ele aciona esses mesmos modelos por dentro
É justamente por isso que o anúncio escolheu bater nessa tecla de tirar Fable 5, Fable 5.1 e GPT-6-Astra do pool
Tirar os três de dentro é a resposta mais direta que existe pra essa crítica, só que resposta direta não é prova
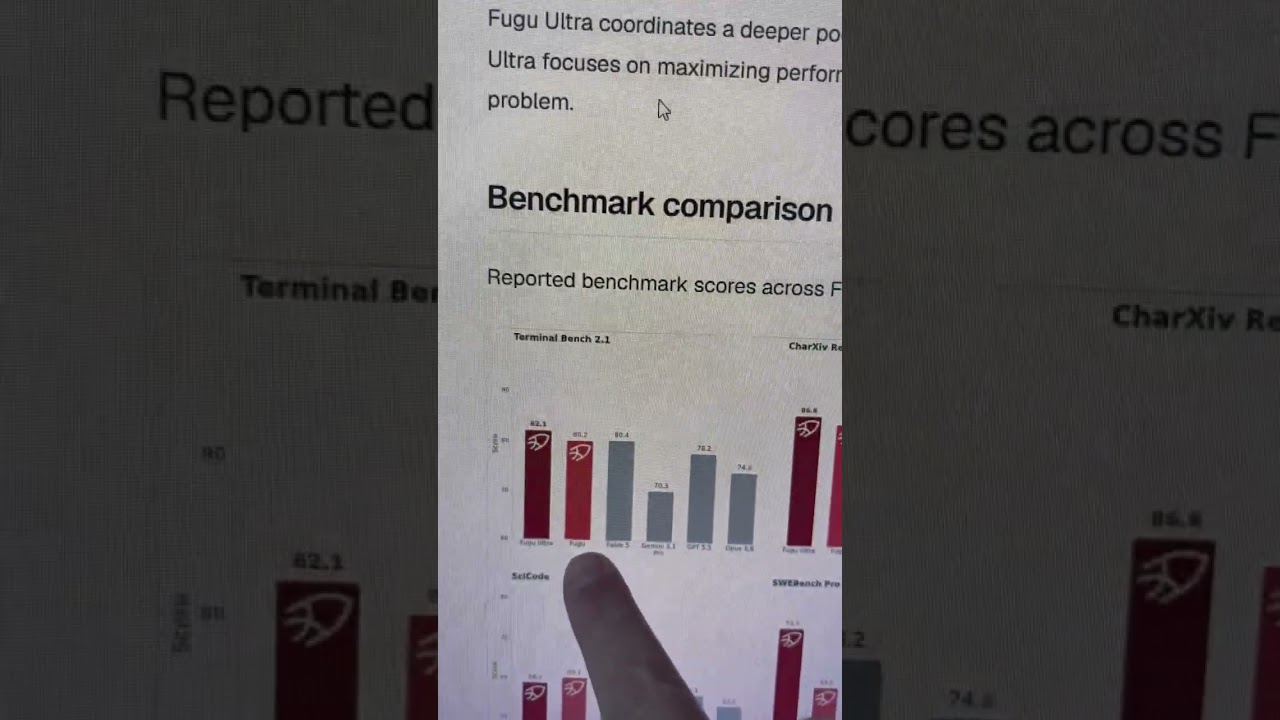
No vídeo acima eu mostro o Sakana Fugu rodando na prática, montando projetos, e comento onde a promessa e o comportamento observado não batem
Para quem esse tipo de independência faz diferença
Não é pra todo mundo, e tá tudo bem
Faz diferença pra você se:
- Você monta produto em cima de uma única API proprietária e perde o sono com vendor lock-in, revogação de API ou modelo saindo do ar por controle de exportação
- Você precisa de contexto absurdamente longo, já que o Ultra v2 anuncia 1.000.000 de tokens de contexto e até 128.000 de saída
- Você roda volume alto e o custo por token dói, e aí o Fugu Max, com US$ 2 de entrada e US$ 6 de saída, entra na conta como opção mais barata que o Ultra v2
Agora, NÃO faz diferença nenhuma se o seu plano era auto-hospedar
Não há pesos abertos do Fugu pra baixar: ele é um serviço de orquestração que roteia requisições pro pool de outros modelos

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Então se a sua fuga do lock-in passava por rodar tudo dentro de casa, com máquina sua, essa porta aqui está fechada
Quem já pensou nesse caminho sabe que ele é outro projeto inteiro, começando pelo hardware: vale mais planejar um upgrade barato de desktop com calma do que sonhar com PC da Nasa no impulso
Risco e continuidade de produto: o que essa aposta muda no seu stack
Aqui mora a troca real, e ela é mais sutil do que o anúncio deixa parecer
Sair da dependência de um modelo de fronteira específico não elimina a dependência
Ela só MUDA de endereço
Você deixa de depender de um fornecedor de modelo e passa a depender da Sakana, que mantém o roteamento proprietário: quais modelos estão no pool e como eles são coordenados não é aberto ao usuário
É opacidade por design
O que você perde de controle:
Você não escolhe o modelo da tarefa, não audita a decisão e não sabe se o pool mudou de composição de uma semana pra outra
Pra quem tem compliance mordendo o calcanhar, isso é um problema concreto
O que você ganha em continuidade:
Se um modelo específico do pool cai, some ou vira problema regulatório, a troca é problema da camada de orquestração, não do seu código
Sua integração continua sendo uma API só
E tem um ponto que ajuda no risco de fornecedor: os modelos Fugu não vivem só nos endpoints da própria Sakana, eles também são oferecidos por provedores de terceiros, incluindo o OpenRouter
Não resolve a opacidade do pool, mas te dá mais de um caminho pra chegar no mesmo serviço
Veredito: a independência é real ou é argumento de lançamento?
Vou separar em três pilhas, do jeito que dá pra defender hoje
O que é fato: o Ultra v2 foi lançado com um pool que não contém mais Claude Fable 5, Claude Fable 5.1 nem GPT-6-Astra
Isso é composição declarada de produto, e é uma mudança concreta em relação à geração anterior, que chamava modelos proprietários de fronteira
O que é declaração: que ele supera esses três mesmo sem eles
Os 48,3 em Chartography, os 74,3 em DeepSWE, os 5 de 8 benchmarks, tudo isso é autorrelato da Sakana, com o fornecedor controlando prompt, scaffold e ferramentas
Paridade por declaração não é paridade testada
O que mudaria meu julgamento: reprodução independente
Uma página de dados viva de terceiro, com metodologia pública e os mesmos scores batendo, resolve a discussão em um dia
Enquanto isso não existe, a independência é real como decisão de arquitetura e é promessa como resultado
E tem a pergunta que o desenho do produto não responde: sem saber quais modelos estão no pool, você não tem como avaliar sozinho se a independência de fronteira é estrutural ou temporária
Conclusão
Recapitulando rapidinho: Fugu Max e Fugu Ultra v2 são a mesma arquitetura de orquestração com missões diferentes, custo por milhão de tokens bem distinto (US$ 2 e US$ 6 no Max, US$ 5 e US$ 30 no Ultra v2), e o argumento central do lançamento é entregar desempenho de pico sem depender indispensavelmente dos modelos de fronteira que o sistema orquestra
O placar é bom e é todo autorrelatado
O próximo passo que eu faria, e que recomendo: pega UMA tarefa real do seu fluxo, roda nela, compara o custo de saída com o modelo que você já usa hoje e vê se o resultado justifica
E segura a mão antes de migrar produto crítico: espera aparecer reprodução independente dos números
Testar cedo é ótimo, apostar cedo é outra coisa 😀
até o próximo post!
Perguntas frequentes
Dá pra usar o Fugu Ultra v2 sem contratar direto com a Sakana AI?
Dá sim. Ele está disponível via OpenRouter, na página openrouter.ai/sakana/fugu-ultra-v2, além dos endpoints próprios da Sakana AI. É ali que aparecem os valores de preço, contexto e saída máxima do modelo.
O Fugu Ultra v2 tem pesos abertos pra rodar localmente?
Não. O Fugu é um serviço de orquestração que roteia as requisições pra um pool de outros modelos, e não existem pesos abertos do próprio Fugu pra auto-hospedagem. Ou seja, ele só funciona como API, não como modelo que você baixa e roda na sua máquina.
Quanto custa usar o Fugu Ultra v2 acima de 272K tokens de contexto?
O preço sobe de US$ 5 de entrada e US$ 30 de saída por milhão de tokens para US$ 10 de entrada e US$ 45 de saída por milhão de tokens quando a conversa passa de 272K tokens de contexto. Vale ficar de olho nisso se você trabalha com prompts longos ou histórico extenso.
Qual o limite de contexto e de saída do Fugu Ultra v2?
A janela de contexto vai até 1.000.000 de tokens, com saída máxima de 128.000 tokens por resposta. É um dos pontos que a Sakana destaca como diferencial de pico frente ao Fugu Max, que não tem esses números divulgados.
O Fugu Ultra v2 ainda chama Claude ou GPT por trás dos panos?
O pool não inclui mais Claude Fable 5, Claude Fable 5.1 nem GPT-6-Astra, segundo o anúncio da Sakana. Mas o roteamento é proprietário e a empresa não abre ao usuário quais modelos exatamente compõem o pool nem como a coordenação entre eles funciona.
Os benchmarks do Fugu Ultra v2 foram confirmados por alguma fonte independente?
Não. Não existe página da Artificial Analysis para nenhum modelo Fugu, e todos os números do placar, incluindo os 48,3 em Chartography e os 74,3 em DeepSWE, foram reportados pela própria Sakana, sem reprodução independente até agora.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
Como usar Fugu Max e Fugu Ultra v2 numa stack que já fala com a API da OpenAI?
Fugu Max e Fugu Ultra v2 usam a API compatível com a OpenAI: troque a base URL, a chave da Sakana e o model. Veja como adotar sem reescrever a stack.
Fugu Max e Fugu Ultra v2: o que significa ser agnóstico de fornecedor na prática?
Fugu Max e Fugu Ultra v2 chegam como orquestradores agnósticos de fornecedor: veja preços, contexto de 1M tokens e o que isso muda na soberania de IA.
Orquestrar vários modelos ou chamar um só? O que muda com Fugu Max e Fugu Ultra v2
Fugu Max estreou com orquestração multiagente: veja preço, contexto de 1M de tokens e como ele se compara ao Fugu Ultra v2 antes de trocar de produção.
