
Orquestrar vários modelos ou chamar um só? O que muda com Fugu Max e Fugu Ultra v2

A Sakana AI anunciou em 11/09/2026 o Fugu Max e o Fugu Ultra v2: duas configurações da mesma arquitetura de orquestração multiagente, não dois produtos diferentes. O Fugu Max roteia a tarefa dinamicamente para o modelo mais enxuto capaz de resolvê-la, custa US$ 2 por milhão de tokens de entrada e US$ 6 de saída, com 1 milhão de contexto. O Ultra v2 mira capacidade máxima e cobra US$ 5 e US$ 30. Os benchmarks divulgados são autoavaliação da Sakana, sem reprodução independente até agora, então vale testar com calma antes de trocar produção
Chamar um LLM é simples: você escolhe o modelo, manda o prompt, recebe a resposta e sabe exatamente quem respondeu
Orquestrar é outra história: existe uma camada no meio que olha a tarefa e decide, sozinha, qual modelo vai resolver aquilo
A Sakana AI anunciou em 11/09/2026 o Fugu Max e o Fugu Ultra v2, e é justamente essa camada que está em jogo
Aqui eu separo onde a orquestração realmente ganha de onde ela só empilha complexidade que talvez você não precise, beleza?
O que a Sakana lançou e por que não são dois produtos:
Primeiro o ponto que quase todo mundo erra na leitura da notícia
Fugu Max e Fugu Ultra v2 são a mesma arquitetura de orquestração multiagente, otimizada para duas missões diferentes
O Max mira o melhor resultado pelo menor custo
O Ultra v2 mira capacidade máxima em tarefas complexas e multi-etapas
Não são produtos separados brigando entre si, são dois ajustes da mesma coisa
E o que é o Fugu por dentro?
Segundo a própria Sakana, o Fugu é um sistema de orquestração multiagente aprendido
Ou seja: um modelo de linguagem treinado pra rotear tarefas entre um pool de modelos abertos e especializados, e pra chamar recursivamente instâncias de si mesmo
Se você conhece um load balancer, a analogia serve bem: não é um servidor monolítico gigante, é um cara na porta decidindo pra onde cada requisição vai
A diferença é que aqui o "cara na porta" também é um modelo, e ele pode chamar ele mesmo de novo pra quebrar a tarefa em pedaços

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
O histórico rápido:
O Sakana Fugu foi lançado em 22/06/2026 já anunciando duas variantes: o Fugu, para trabalho sensível a latência, e o Fugu Ultra, para tarefas complexas e multi-etapas
O Ultra, porém, só foi liberado dois dias depois, em 24/06/2026, então são as duas pontas da mesma estreia: anúncio em 22/06 e disponibilidade do Ultra em 24/06
Agora, nessa atualização, o pool de modelos do Fugu Max foi ampliado com modelos de pesos abertos e especializados, incluindo a família NVIDIA Nemotron, por meio de colaboração com a NVIDIA
E tem um detalhe curioso do outro lado: o pool do Fugu Ultra v2 não contém Claude Fable 5, Claude Fable 5.1 nem GPT-6 Astra
Mesmo assim a Sakana afirma superar os três
Pool menor, resultado maior… segura essa informação que ela volta lá no final do post 😀
Fugu Max x Fugu Ultra v2: preço, contexto e posicionamento:
Agora os números que dá pra colocar numa planilha
| Item | Fugu Max | Fugu Ultra v2 |
|---|---|---|
| Entrada (por milhão de tokens) | US$ 2 | US$ 5 |
| Saída (por milhão de tokens) | US$ 6 | US$ 30 |
| Entrada em cache (por milhão) | US$ 0,25 | US$ 0,50 |
| Acima de 272.000 tokens de contexto | valores fixos em qualquer tamanho de contexto | US$ 10 entrada, US$ 45 saída, US$ 1,00 cache |
| Busca ou fetch na web | US$ 0,007 por chamada | não confirmado |
| Janela de contexto | 1.000.000 de tokens | 1.000.000 de tokens |
| Limite de saída | não confirmado | até 128.000 tokens de completion |
Repara na linha do contexto, que é onde mora a pegadinha
O Max mantém o preço fixo em qualquer tamanho de contexto
O Ultra v2 tem degrau: passou de 272.000 tokens, entrada e saída sobem de patamar
Na prática isso muda o desenho da sua aplicação: se o seu caso empurra contexto gigante por padrão (repositório inteiro, PDF enorme, histórico longo), o Ultra v2 pode dobrar a conta sem você perceber
E a diferença de saída entre os dois é brutal: US$ 6 contra US$ 30 por milhão
Quando o seu gargalo é geração de token (código, relatório, texto longo), é aí que a escolha pesa de verdade
A Sakana ainda afirma que o preço de saída do Fugu Max fica 40% a 60% abaixo do preço de saída de Sonnet 5, GPT 5.6 Terra e Kimi K3
E que o roteamento pro modelo mais enxuto capaz de resolver a tarefa entrega resultado de nível de fronteira com fração do gasto em tokens, posicionado na fronteira de Pareto com desempenho próximo de modelos de elite a custo 2 a 6 vezes menor
Guarda o "alegação da Sakana" nessas frases, porque é exatamente isso: alegação da casa, não medição de terceiro
Quando a orquestração ganha e quando a chamada única basta:
Essa é a parte que interessa pra quem vai decidir arquitetura, não pra quem só quer comentar lançamento no feed
Onde rotear compensa:
- Volume alto e custo por token doendo: se você roda milhares de chamadas por dia e boa parte delas é tarefa simples, mandar tudo pro modelo top de linha é queimar dinheiro. Rotear pro modelo mais enxuto capaz é exatamente o argumento comercial do Max
- Tarefas heterogêneas na mesma pipeline: classificar, resumir, extrair, gerar código e revisar têm perfis de dificuldade MUITO diferentes. Um roteador existe pra isso
- Tarefas multi-etapas longas: é a missão declarada do Ultra v2, com a possibilidade de chamar recursivamente instâncias de si mesmo pra quebrar o problema
- Contexto grande: 1.000.000 de tokens nos dois, então o teto não é o limitador aqui

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →Se o que você quer é montar esse roteamento com a mão, sem depender de uma camada fechada, dá pra orquestrar múltiplos modelos no n8n e manter a régua de decisão visível pra você
Onde a chamada única continua ganhando:
- Comportamento estável: você fixa o modelo, fixa a versão, e o output de amanhã se parece com o de hoje
- Debug direto: deu ruim, você sabe quem respondeu. Não tem camada de decisão no meio pra investigar junto
- Dependência já integrada: se o seu app já está preso num SDK, num tier de contrato ou numa infra que funciona, trocar por orquestração é custo de migração puro
- Tarefa homogênea: se quase tudo o que você manda é a mesma coisa, o roteador não tem o que rotear. Ele só vira mais uma camada entre você e a resposta
O custo escondido que ninguém coloca na tabela:
Ao orquestrar, você para de escolher o modelo
Você passa a confiar no roteador
E isso muda duas coisas que só doem depois: depuração e reprodutibilidade
Quando a resposta vem errada, na chamada única você abre o prompt e o modelo e investiga
Na orquestração você tem um caminho de decisão no meio que você não escreveu, e que pode não estar exposto pra você
Tome cuidado com isso na hora de colocar em fluxo crítico: rodar mais barato não serve de nada se você não consegue explicar por que a resposta mudou entre segunda e quarta
A lógica é a mesma que vale pra quem compara quais modelos usar no OpenCode: escolher provedor é escolher previsibilidade, não só preço
O que já dava pra ver na prática com o Fugu:
Eu já tinha gravado um teste completo do Fugu no canal, criando projetos pra avaliar como o orquestrador se comporta
E tem coisa dali que encaixa direto nesse debate de orquestração x chamada única
A promessa de que o modelo japonês seria melhor que os modelos topo de linha não se confirmou pra mim quando eu fui olhar COMO a ferramenta funciona por dentro
No vídeo eu mostro um benchmark em que a Fugu aparece à frente de modelos concorrentes, e relativizo o resultado ali mesmo
O ponto que mais me incomodou no uso foi outro: na prática a ferramenta entrega só a resposta final, sem explicar qual modelo foi escolhido nem por quê
Pra mim é isso que resume: não é um modelo japonês superior aos líderes do mercado, é uma camada que escolhe e te devolve a resposta pronta
O que, de novo, não é necessariamente ruim… é só uma troca: você ganha custo e perde visibilidade
E se falta visibilidade, o benchmark favorável precisa ser lido com ressalva
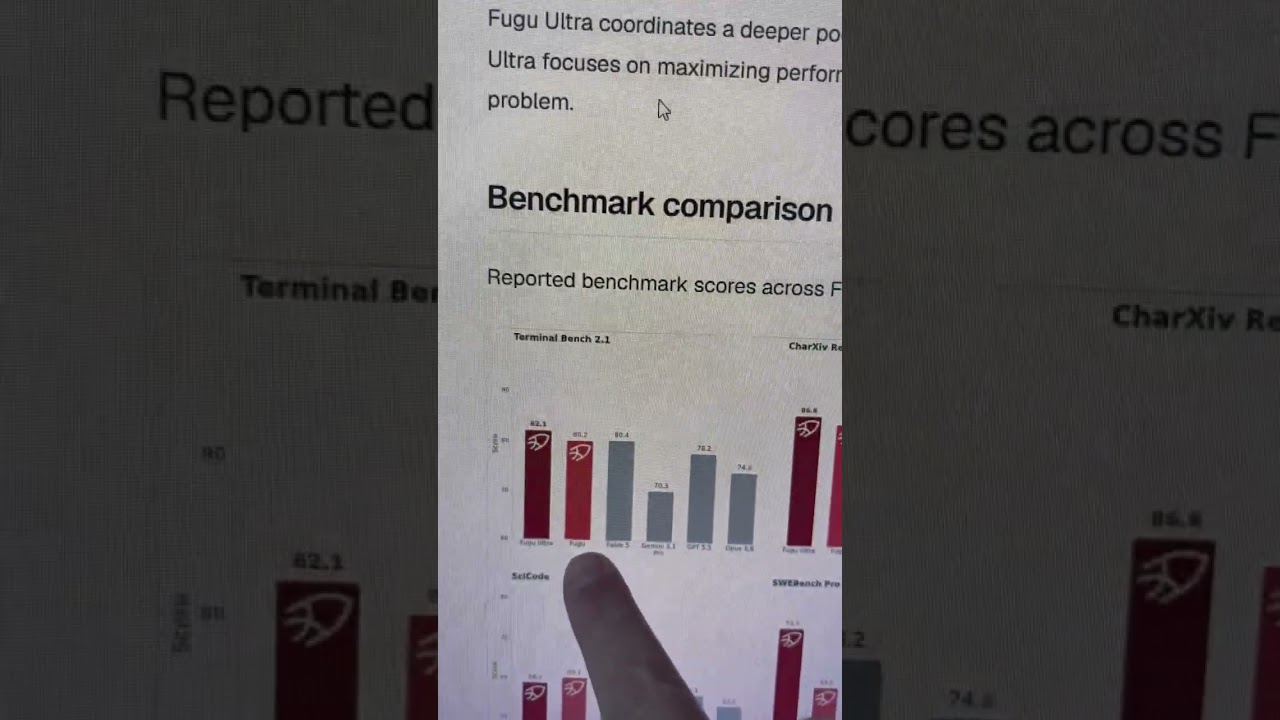
No vídeo acima você me vê criando projeto do zero em cima do orquestrador e olhando o resultado com o benchmark aberto do lado
O que muda no seu código: API, IDs de modelo e Claude Code:
Agora a parte operacional, só com o que está documentado
A API:
A base URL é https://api.sakana.ai/v1, compatível com a interface padrão do SDK da OpenAI
Ou seja: se o seu código já fala OpenAI, é troca de endpoint e de nome de modelo
São suportados Chat Completions, Responses e Anthropic Messages, e a Sakana recomenda a Responses API pra geração
from openai import OpenAI

client = OpenAI(
    base_url="https://api.sakana.ai/v1",
    api_key="SUA_CHAVE"
)

resposta = client.responses.create(
    model="fugu-max",
    input="Refatore esta função e explique o que mudou"
)
Os IDs de modelo:
Estão disponíveis na API da Sakana:
fugu-ultra(aponta para o Fugu Ultra v2, listado na documentação como v2.0: mesma versão, só a numeração completa)fugu-maxfugufugu-ultra-v1.0fugu-ultra-v1.1fugu-cyber

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.E aqui vai o alerta pra quem já estava usando: o endpoint original de junho de 2026 do Fugu Ultra passou a se chamar fugu-ultra-v1.0
Se você fixou o ID datado em algum lugar, confere se a integração ainda resolve e migra pros IDs versionados
A Sakana afirma que usuários existentes atualizam com mudança de um parâmetro, mantendo o mesmo contrato de API
Esse é o tipo de coisa que quebra sexta à noite, então é melhor conferir hoje 🙂
E no Claude Code?
A Sakana oferece endpoints compatíveis com o Claude Code
Como o Claude Code é closed source, a integração é feita inteiramente pelas variáveis de ambiente ANTHROPIC_* documentadas mais o gateway server-side da Sakana
Um exemplo que a documentação mostra: adicionar
ANTHROPIC_CUSTOM_MODEL_OPTION="fugu-ultra-v1.1[1m]"isso cria uma linha fixa de release do Ultra no /model
Repara numa coisa: esse exemplo vem da página da interface do Fugu 1.1 com o Claude Code, por isso ele aparece com o ID fugu-ultra-v1.1 e não com a release nova
Ou seja: é exemplo de COMO se fixa uma linha de release, não recomendação de qual versão você deve usar
O ID da versão mais recente na API é fugu-ultra, mas eu não vou listar aqui receita de variável que a página oficial não mostra, porque nesse assunto errar um nome de env var é passar uma hora achando que a chave está inválida
Dá pra confiar nos números? O que ainda falta:
Vamos aos resultados divulgados, e depois à ressalva
Na avaliação da própria Sakana, o Fugu Max teve a melhor pontuação geral em seis benchmarks (Terminal Bench 2.1, GPQAD, AA-LCR, GDP.pdf, AutomationBench e SWEFish) e expandiu a fronteira de Pareto custo-desempenho em 7 de 10 benchmarks
O Fugu Ultra v2 aparece como melhor ou empatado em primeiro em 5 de 8 benchmarks, incluindo 48,3 em Chartography contra 27,3 do Claude Opus 5 e 29,5 do Claude Fable 5, além de 74,3 no DeepSWE
São números fortes, não dá pra negar
Agora a ressalva, e ela é grande: nenhum desses números foi reproduzido de forma independente
Tudo é autoavaliação da Sakana, e não existe página do Artificial Analysis para nenhum modelo Fugu até 11/09/2026
Não estou dizendo que é mentira, estou dizendo que é a casa medindo a própria casa, e isso é uma categoria diferente de evidência
Pra quem faz sentido testar agora:
- Quem tem volume alto e conta de saída doendo, porque US$ 6 por milhão no Max é um número que se paga rápido se a qualidade segurar
- Quem tem tarefa heterogênea e hoje manda tudo pro modelo mais caro por preguiça de rotear
- Quem consegue rodar um teste paralelo sem colocar produção em risco
Pra quem faz sentido esperar:
- Quem precisa justificar escolha de modelo pra auditoria, cliente ou compliance, porque "o roteador escolheu" não é resposta
- Quem depende de reprodutibilidade fina entre execuções
- Quem só trocaria por causa do benchmark, sem ter caso de uso doendo. Benchmark sem verificação independente não é motivo pra migração
Conclusão:
Orquestrar ou chamar um modelo único é decisão de arquitetura, não de hype
A orquestração te dá custo menor e cobertura maior de tarefa
A chamada única te dá previsibilidade e debug limpo
O Fugu Max e o Fugu Ultra v2 empurram bem forte o primeiro lado, com preço agressivo e 1 milhão de contexto nos dois, mas ainda com os números vindos só da própria Sakana
Então o próximo passo é o de sempre e é chato de propósito: pega uma tarefa real que você já resolve hoje, roda ela contra fugu-max, compara custo e resultado lado a lado com o que você usa
Sem trocar nada em produção antes disso
Se os números baterem no SEU caso, aí sim a conversa muda
até o próximo post!
Perguntas frequentes
Quanto custa usar o Fugu Max comparado ao Fugu Ultra v2?
O Fugu Max cobra US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de saída, com valores fixos em qualquer tamanho de contexto, mais US$ 0,25 por milhão de entrada em cache. Já o Fugu Ultra v2 sai por US$ 5 de entrada e US$ 30 de saída por milhão, subindo para US$ 10 e US$ 45 acima de 272.000 tokens de contexto.
O Fugu Max funciona com Claude Code?
A Sakana oferece endpoints compatíveis com Claude Code, mas como o Claude Code é closed source, a integração acontece pelas variáveis de ambiente ANTHROPIC_* documentadas junto com o gateway server-side da Sakana. O exemplo publicado pela Sakana é da página da interface do Fugu 1.1 e usa ANTHROPIC_CUSTOM_MODEL_OPTION="fugu-ultra-v1.1[1m]" para criar uma linha fixa de release do Ultra no /model: é exemplo de como se fixa uma release, com o ID daquela versão, não recomendação de qual versão usar.
Qual a diferença entre fugu-ultra e fugu-ultra-v1.0 na API da Sakana?
O ID fugu-ultra aponta para a versão mais recente, o Fugu Ultra v2 (listado na documentação da Sakana como v2.0, mesma versão com a numeração completa). Já fugu-ultra-v1.0 é o endpoint original do Fugu Ultra, liberado em 24/06/2026, dois dias depois do anúncio da família Fugu em 22/06/2026, e renomeado quando a Sakana passou a versionar os IDs (também existem fugu-ultra-v1.1, fugu, fugu-max e fugu-cyber).
Os benchmarks do Fugu Max e do Fugu Ultra v2 foram verificados por algum terceiro?
Não. Todos os números divulgados são autoavaliação da própria Sakana AI, e não existe página do Artificial Analysis para nenhum modelo da família Fugu até 11/09/2026. Vale tratar os resultados como alegação da casa, não como medição independente.
Quem já usava o Fugu Ultra de junho de 2026 precisa mudar alguma coisa?
Sim, quem fixou o ID datado do endpoint original deve conferir se a integração ainda resolve e migrar para os IDs versionados, já que o endpoint de junho virou fugu-ultra-v1.0. A Sakana afirma que a atualização é uma mudança de um único parâmetro, mantendo o mesmo contrato de API.
Fugu Max e Fugu Ultra v2 têm o mesmo limite de contexto?
Os dois trabalham com janela de 1.000.000 de tokens de contexto. A diferença aparece no limite de saída, com o Fugu Ultra v2 suportando até 128.000 tokens de completion, e no preço: o Ultra v2 sobe de patamar acima de 272.000 tokens de contexto, enquanto o Max mantém valores fixos independente do tamanho.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
Como usar Fugu Max e Fugu Ultra v2 numa stack que já fala com a API da OpenAI?
Fugu Max e Fugu Ultra v2 usam a API compatível com a OpenAI: troque a base URL, a chave da Sakana e o model. Veja como adotar sem reescrever a stack.
Fugu Max ou Fugu Ultra v2: qual escolher para cada tipo de tarefa?
Fugu Max ou Fugu Ultra v2: veja preço por token, diferenças de arquitetura e quando usar cada variante da Sakana AI em tarefas simples ou complexas.
Fugu Max e Fugu Ultra v2: o que significa ser agnóstico de fornecedor na prática?
Fugu Max e Fugu Ultra v2 chegam como orquestradores agnósticos de fornecedor: veja preços, contexto de 1M tokens e o que isso muda na soberania de IA.
