
Como usar o Laya como roteador de modelos: decidindo small vs frontier a cada request

Usar o Laya como roteador de modelos significa colocar um modelo de decisão open-weight na frente da sua aplicação pra decidir, request por request, se a chamada vai pra um modelo pequeno ou de fronteira. O Laya é publicado pela Convai Innovations sob Apache 2.0, instala com pip install laya e já traz um preset pronto chamado router_questions(). Ele não gera texto: devolve campos fixos com probabilidades, avaliando todas as perguntas num único forward pass. O projeto declara 33 ms para uma pergunta e 7,2 ms por pergunta em lote, medido em GPU T4
Mandar TODA request pro modelo mais caro é a decisão de arquitetura mais cara que você toma sem perceber
Aquele "oi, tudo bem?" do usuário vai pro mesmo lugar que a refatoração de um serviço inteiro
E é aí que entra o Laya, uma família de modelos de decisão open-weight publicada pela Convai Innovations sob licença Apache 2.0
O README do projeto lista quatro casos de uso principais, e o primeiro deles é justamente o Intelligent Model Router (small vs frontier)
Ou seja: o roteamento não é gambiarra que alguém inventou depois, é o caso de uso número 1 do produto 🙂
Bora entender como isso funciona?
Por que um roteador de modelos precisa de um modelo de decisão
A solução óbvia pra rotear é usar um LLM pequeno pra classificar a request
Porém isso te cobra três coisas: tokens de entrada, tokens de saída e a latência da geração token a token
E tem o problema chato: você precisa parsear prosa ou torcer pro JSON gerado vir bem formado
Já me ferrei com isso mais de uma vez, o modelo resolve enfiar um "Claro! Aqui está o JSON:" antes da chave e teu parser explode
O Laya resolve isso por outro caminho: ele não gera texto
Ele responde perguntas tipadas e devolve campos fixos com probabilidades, sem JSON gerado e sem parsing de prosa

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
As três primitivas de pergunta:
As primitivas suportadas são:
choice: escolha entre opçõesscore: ordinalnoul: booleana
E tem o detalhe que muda tudo na conta de latência: todas as perguntas de uma chamada são avaliadas em um único forward pass
Não importa se você faz uma pergunta ou seis, é uma passada só
E de onde veio essa ideia?
O Laya é posicionado como alternativa de pesos abertos ao Jev, um modelo de decisão fechado da TypeSafe AI lançado em 15/09/2026
Na comparação publicada pelo projeto, a latência citada do Jev é de 236 a 276 ms
O Laya fica na casa das dezenas de milissegundos por pergunta, medido em GPU T4, e cai pra 7,2 ms por pergunta quando as perguntas rodam em lote (os números por checkpoint estão logo mais abaixo)
Ordem de grandeza diferente, e com pesos abertos na mão
O que você precisa antes de começar
Lista curta:
- Ambiente Python funcionando
- O pacote oficial, instalado via
pip install laya(a versão mais recente no PyPI é a 0.1.6, sendo que a primeira publicação, a 0.1.1, saiu em 18/09/2026) - Acesso ao Hugging Face, porque o checkpoint é baixado de lá
- E, principalmente: clareza de ONDE o roteador entra na tua aplicação
Esse último item é o que mais gente pula
O roteador é uma etapa ANTES da chamada ao provedor, não é um substituto dela, beleza?
Escolhendo o checkpoint certo:
O projeto publica três checkpoints, com backbones e contextos diferentes:
| Checkpoint | Backbone | Parâmetros | Contexto | Publicação |
|---|---|---|---|---|
| laya | ModernBERT-large | 421M | 512 | 18/09/2026 |
| laya-multilingual | mmBERT-base | 322M | 1024 | 19/09/2026 |
| laya-typed-decisions | ModernBERT-large | 421M | 1024 | 18/09/2026 |
O laya é o checkpoint em inglês
O laya-multilingual cobre 100+ idiomas, o que importa MUITO se teu produto é em português
Olha o contexto de 512 do primeiro com carinho, porque ele vai te morder lá na frente (te conto no passo a passo)
Passo a passo: montando o roteador small vs frontier
- Instale o pacote
pip install layaO erro comum deste passo: assumir que os portes da comunidade são o pacote oficial
Existem coisas como laya-mlx e laya-coreml no PyPI, mas são de terceiros
- Carregue o checkpoint
O helper laya.load puxa o modelo direto do Hugging Face:
import laya

agent = laya.load("convaiinnovations/laya")
Se teu tráfego é multilíngue, o checkpoint da vez é outro: o laya-multilingual, publicado à parte, com backbone mmBERT-base e contexto 1024
E tem coisa melhor: o próprio pacote traz uma classe Router pra escolher o checkpoint certo por request, te mostro no passo 5

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →O erro comum deste passo: carregar o checkpoint em inglês e jogar request em português nele achando que vai dar na mesma
O projeto separou os checkpoints por um motivo
- Faça a pergunta de roteamento
Aqui mora a graça: você não escreve prompt de classificação
O pacote já traz um preset pronto de perguntas de roteamento, o router_questions()
O exemplo do README é esse:
routing = agent.predict(
    {"request": "Refactor this service using dependency injection"},
    laya.router_questions()
)
Repare na assinatura: primeiro o estado (um dict com a request), depois as perguntas
O erro comum deste passo: tentar reescrever na mão as perguntas do preset porque você viu uma lista circulando por aí
Os enunciados que rolam na internet vêm de skills de terceiros, não da documentação oficial
Usa o preset e segue o baile
- Leia a saída e decida o destino
A saída é estruturada, com probabilidades por campo
Não é texto, não é JSON gerado
E é AQUI que a tua aplicação toma a decisão: modelo pequeno ou modelo de fronteira
O pacote responde a pergunta, o dispatch da chamada continua sendo teu
Se o destino for a família da Anthropic, vale ter na cabeça qual modelo Claude usar em cada tarefa antes de fechar as duas pontas do roteador
O erro comum deste passo: tratar o retorno como texto gerado e sair fazendo regex nele
São campos fixos, tu acessa o campo
- Use o Router quando o tráfego for misto
O pacote traz uma classe Router que escolhe o checkpoint certo por request, olhando o script Unicode do texto ANTES do forward pass:
from laya import Router

router = Router(preload=True)
Essa detecção de script roda em menos de 0,5 ms, em Python puro
Ou seja: ela não entra no teu orçamento de inferência, é custo de string mesmo
O preload=True mantém os checkpoints residentes em memória
O erro comum deste passo: esquecer o preload
Aí quando o tráfego alterna entre idiomas você paga uma penalidade de 7 a 10 segundos de cold-swap
Sete segundos… no meio de um request de usuário… dá pra imaginar a cena 😛
E o outro erro clássico: usar o checkpoint de contexto 512 com prompts longos
Se tua request chega com histórico de conversa colado, 512 acaba rápido
O que muda no fluxo da sua aplicação
Antes, o fluxo é reto:
request do usuário → provedor → resposta
Depois, entra um degrau:
request do usuário → decisão em milissegundos → provedor escolhido → resposta
Parece pouco, mas muda a conversa toda sobre custo, porque a pergunta deixa de ser "qual modelo eu uso" e vira "qual modelo ESSA request merece"
E o orçamento de latência?
Esse degrau não é de graça, então bora colocar número na mesa
A ficha técnica consolidada mostra latência p50 medida em Tesla T4:
| Checkpoint | Latência p50 (T4) |
|---|---|
| Inglês, 421M | 39,5 ms |
| Multilíngue, 322M | 32,8 ms |
Em lote, o projeto declara 7,2 ms por pergunta e throughput de 103 a 332 perguntas por segundo numa única T4
Comparando com os 236 a 276 ms citados na comparação com o Jev, a matemática fica bem mais confortável
Se tua chamada ao modelo de fronteira leva segundos, gastar dezenas de milissegundos pra decidir se ela precisa MESMO acontecer é troca fácil
E quando a decisão vem com pouca confiança?
Essa é a parte que ninguém gosta de falar, mas é a mais importante
O F1 por primitiva divulgado pelo projeto é:
noul: 0,857choice: 0,733score: 0,723
Isso não é 1,0 e nem deveria ser lido como se fosse
O roteador VAI errar às vezes

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Então a regra de ouro: decisão de baixa confiança cai pro modelo de fronteira, não pro pequeno
Errar pra cima custa dinheiro, errar pra baixo custa a resposta do usuário
E se tua aplicação já conversa com vários provedores, a mesma lógica de decisão se aplica em cima dos modelos disponíveis em cada plano, o roteador só troca quem recebe a chamada
Roteamento de modelos na prática: o que já vi nesse tipo de arquitetura
Aqui preciso ser honesto contigo: minha experiência é com a IDEIA de arquitetura multi-modelo, não com o Laya especificamente
Mas ela ensina umas coisas que valem demais pra quem vai montar roteador
No vídeo do canal sobre um sistema que usa vários modelos ao mesmo tempo, eu criei vários projetos usando esse orquestrador justamente pra ver o potencial real da abordagem de várias IAs trabalhando juntas
E duas coisas me incomodaram
A primeira: o benchmark mostrando o orquestrador superando modelos como GPT e Opus
Eu questiono isso, porque provavelmente ele usa esses próprios modelos por baixo pra chegar na resposta
Não é o orquestrador sendo melhor, é o orquestrador chamando quem é bom
A segunda, e essa é a que mais dói no dia a dia: o sistema só entrega a resposta final, sem explicar qual modelo interno foi escolhido
Caixa preta
E é exatamente por isso que eu gosto da abordagem de roteador explícito
Quando a decisão é um campo com probabilidade que a TUA aplicação lê e loga, tu sabe pra onde cada request foi
Você consegue auditar, medir e ajustar
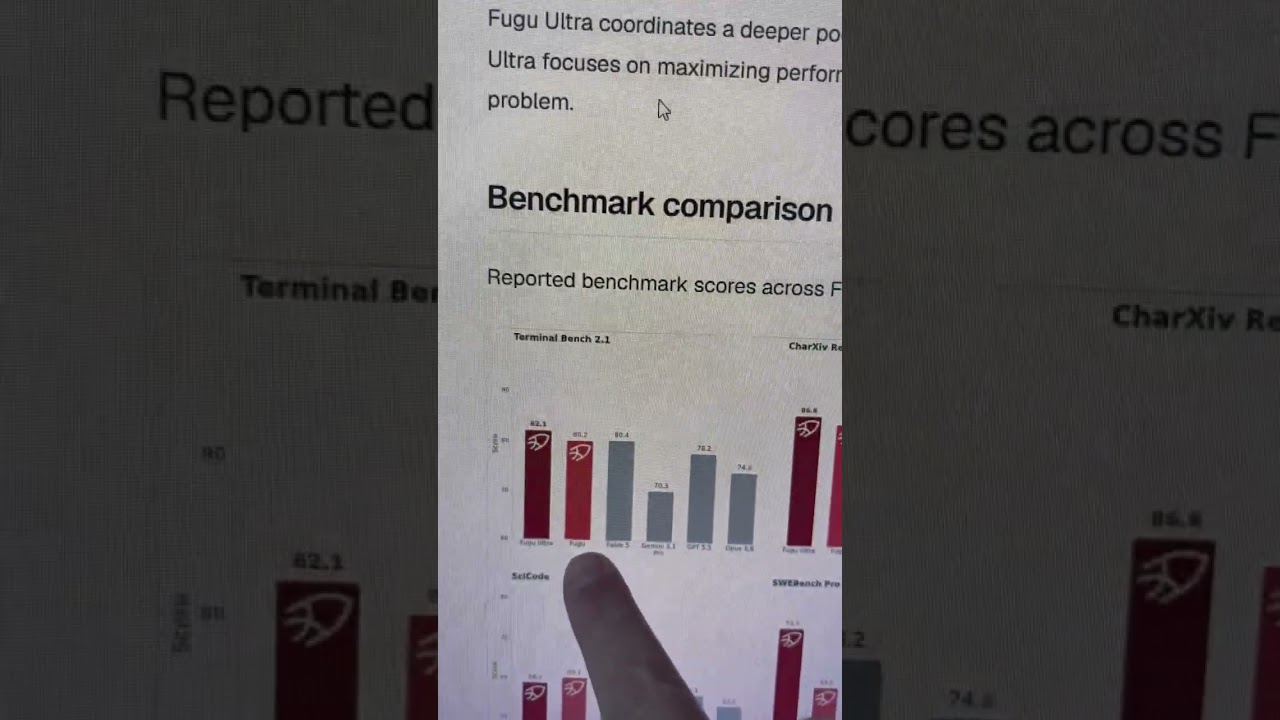
Pra começar do zero com a lógica de vários modelos trabalhando juntos, esse vídeo do canal mostra o sistema rodando e os projetos que eu montei em cima dele
Além do small vs frontier: outros presets do pacote
Lembra que todas as perguntas rodam em um único forward pass?
Isso abre uma porta bem massa
Se o custo é por passada e não por pergunta, você pode carregar mais perguntas na MESMA chamada
O pacote traz estes presets prontos:
router_questionstriage_questionsemail_questionsguard_questionsmoderation_questions
E eles conversam direto com os quatro casos de uso principais listados no README:
- Intelligent Model Router (small vs frontier)
- Real-time Prompt Guardrails
- Content Safety & Moderation
- Support Ticket Triage
Olha a combinação óbvia: rodar roteamento e guardrail juntos
Na mesma passada você descobre se a request é simples ou complexa E se ela é uma tentativa de furar teu guardrail
Se for pra bloquear, nem chega no provedor, e você economizou os dois lados
Em um sistema de suporte, a triagem entra na mesma lógica: classifica o ticket e decide o modelo na mesma decisão
Próximo passo
Recapitulando a decisão de arquitetura: em vez de mandar tudo pro modelo caro, você coloca um modelo de decisão open-weight na frente e resolve small vs frontier a cada request
O Laya faz isso com saída estruturada, sem gerar texto, e com o preset router_questions() já pronto no pacote
A fonte pra consultar é o repositório oficial, github.com/NandhaKishorM/laya
Um aviso importante: laya-mlx, laya-coreml e laya-router-skill são portes e wrappers da comunidade, não foram publicados pela Convai Innovations
Pode ser que te sirvam, mas trate como código de terceiro
E o conselho final: antes de escolher checkpoint, mede teu próprio tráfego
Teus usuários escrevem em português? Os prompts passam de 512 tokens? A distribuição entre request trivial e request complexa é qual?
Sem isso você está escolhendo modelo no chute, e roteador escolhido no chute não economiza nada 😀
Até o próximo post!
Perguntas frequentes
O Laya gera JSON pra decidir o roteamento entre modelo small e frontier?
Não, o Laya não gera texto nem JSON. Ele responde perguntas tipadas usando as primitivas choice, score e noul e devolve campos fixos com probabilidades, sem parsing de prosa envolvido.
Quanto tempo leva pra decidir entre modelo small e frontier usando o Laya?
A ficha técnica consolidada mostra latência p50 medida em Tesla T4 de 39,5 ms no checkpoint em inglês de 421M e 32,8 ms no multilíngue de 322M, e o projeto declara 7,2 ms por pergunta quando a coisa roda em lote. Em comparação, o Jev (concorrente fechado da TypeSafe AI) cita latência de 236 a 276 ms na mesma comparação.
O roteador do Laya substitui a chamada ao provedor do modelo escolhido?
Não. O Laya entra ANTES da chamada ao provedor, é a etapa de decisão. Depois que ele devolve o destino (small ou frontier), o dispatch pra Anthropic, OpenAI ou qualquer outro provedor continua sendo responsabilidade da sua aplicação.
Existe versão do Laya pra Apple Silicon ou Core ML?
Existem laya-mlx e laya-coreml, mas são portes independentes mantidos pela comunidade, não publicados pela Convai Innovations. O pacote oficial se instala com pip install laya e carrega o checkpoint direto do Hugging Face.
Como o Laya escolhe o checkpoint certo quando o tráfego mistura idiomas?
A classe Router olha o script Unicode do texto antes do forward pass, em menos de 0,5 ms, e direciona pro checkpoint certo. Com Router(preload=True) os checkpoints ficam residentes em memória e você evita a penalidade de 7 a 10 segundos de cold-swap na troca entre idiomas.
Qual checkpoint do Laya usar se o produto é em português?
O laya-multilingual, que usa backbone mmBERT-base com 322M de parâmetros e contexto de 1024, cobre mais de 100 idiomas. O checkpoint laya padrão é só em inglês e tem contexto de 512, então não serve pra tráfego multilíngue.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
Fugu Max: quais modelos ele orquestra e onde entra a NVIDIA Nemotron?
Fugu Max é o orquestrador da Sakana AI que roteia tarefas entre modelos, com NVIDIA Nemotron cuidando de código. Veja preço e como funciona.
Como montar fallback entre Fable 5.1 e GPT-6 Astra quando um dos dois falha
Fallback Fable 5.1 GPT-6 Astra: veja como criar um adaptador único, tratar erros e trocar de modelo sem quebrar seu app.

Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação A popularidade da automação de processos com o n8n está em alta, principalmente […]
