
OpenAI, Google, Microsoft e Anthropic vão respeitar um único sinal no robots.txt contra treino de IA: o que muda
Fala aí, beleza? Os quatro maiores laboratórios de IA resolveram concordar em alguma coisa, e é justamente sobre o seu robots.txt 🙂
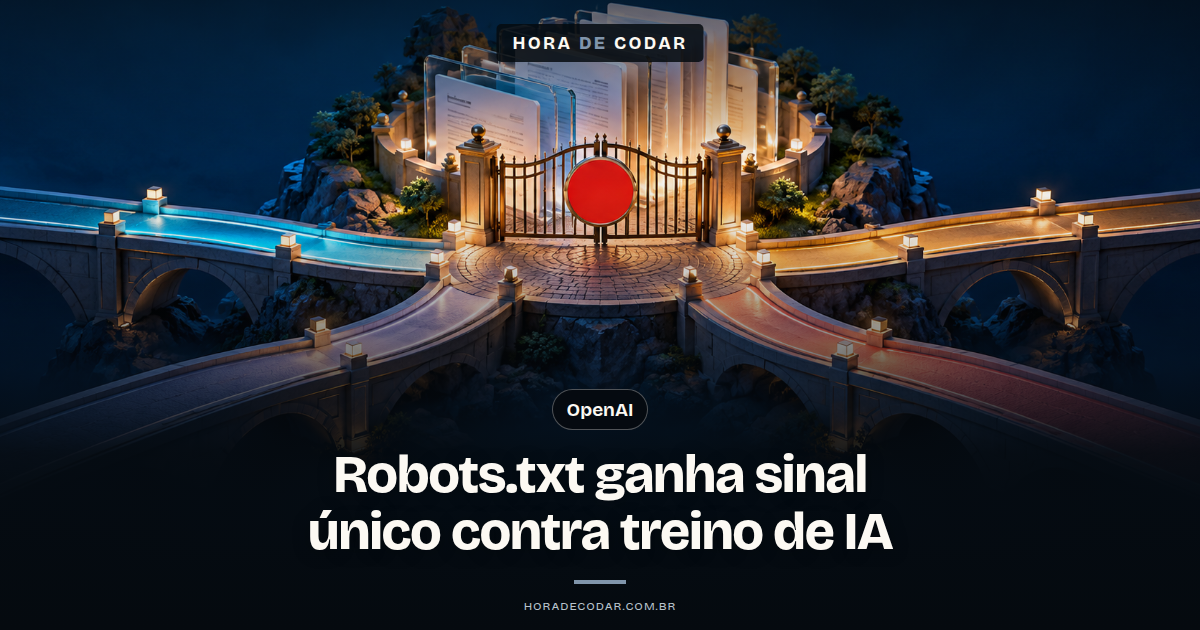
OpenAI, Google, Microsoft e Anthropic anunciaram em 30/10/2026 que vão respeitar um sinal compartilhado, o policy token __usage_ai-training, para o operador do site dizer uma única vez se aceita que o conteúdo entre no treino de modelos fundacionais de IA generativa
O The Verge repercutiu o anúncio, citando cobertura anterior do Search Engine Roundtable
Só que calma: isso ainda é um rascunho individual no IETF, não um padrão aprovado, e nenhuma das quatro tem o sinal funcionando de forma geral hoje
A Anthropic diz que já começou a implementar, as outras três deram previsões diferentes (ou ainda nem ativaram)
Como funciona o policy token __usage_ai-training no robots.txt
O token entra na linha User-Agent de um grupo comum do robots.txt, como se fosse o nome de um crawler

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
A sacada é essa: ele não inventa diretiva nova nem gramática nova
Caminhos, precedência pelo match mais longo e estrutura de grupos seguem iguaizinhos ao RFC 9309 (o Robots Exclusion Protocol), então se tu já escreveu um Disallow na vida, já sabe escrever esse grupo
O próprio rascunho traz este exemplo, que declara preferência contra treino de IA no site inteiro, exceto na pasta /press-kit/:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
E aqui vem o ponto que mais vai confundir gente: isso NÃO é uma diretiva de rastreamento, é uma preferência de uso
As regras normais do product token de cada crawler continuam valendo para decidir quem acessa o site; o token de treino, por si só, não bloqueia ninguém
Só que o próprio rascunho pede que os crawlers não busquem aquilo que não podem usar, então a expectativa é que provedores que respeitem o sinal evitem buscar o conteúdo recusado: mas isso depende de cada provedor aplicar esse comportamento na prática
Qual a diferença para o bloqueio atual por crawler (GPTBot, Google-Extended e outros)
Hoje, quem quer recusar o treino precisa escrever regras separadas para o crawler de cada provedor: GPTBot na OpenAI, Google-Extended no Google, e assim por diante para os demais
Com o token, a ideia é declarar uma vez só e valer para todo provedor que decidir respeitar o sinal
É tipo trocar um monte de cadeado individual por uma placa única na porta, só que a placa depende de quem lê querer obedecer haha
Se liga em dois detalhes do rascunho que fazem toda a diferença:
- Grupos com
User-Agent: *NÃO podem ser interpretados como se valessem para o token, o curinga não cobre ele - Um robots.txt sem grupo
__usage_ai-trainingnão expressa preferência nenhuma, nem a favor nem contra

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →E sobre compatibilidade: parsers de robots.txt que não reconhecem o token simplesmente ignoram o grupo, do mesmo jeito que fazem com qualquer user-agent desconhecido
Além disso, a OpenAI deixou claro que o novo sinal não substitui os controles atuais, como o GPTBot, que continuam valendo
Em que estágio está a proposta no IETF
A proposta é o rascunho individual Machine-Readable Training Preference Signal, de Kevin Kelley, da Anthropic
O identificador é draft-kelley-aipref-training-preference-signal-00, versão -00, publicada em 30/10/2026
Que estágio é esse? É um Internet-Draft ativo, sem endosso do IETF e sem status formal no processo de padronização
Traduzindo: não é RFC, é uma proposta na mesa
O documento tem relação com o trabalho do grupo AI Preferences (aipref) do IETF, que padroniza formas de expressar preferências de uso de conteúdo por IA
Kelley anunciou o rascunho na lista ai-control do IETF e disse que a Anthropic já começou a implementar o suporte
Tome cuidado com uma data que vai aparecer por aí: o rascunho expira em 03/05/2027
Isso é só a validade padrão de qualquer Internet-Draft, não é prazo de adoção nem data de entrada em vigor 😉
O que cada empresa prometeu e quando
Cada uma falou uma coisa diferente, então vale olhar uma por uma
Anthropic
Segundo o e-mail de Kelley na lista do IETF, a Anthropic já começou a implementar o suporte
Não há data informada para isso valer em produção
OpenAI
A OpenAI diz que vai respeitar o sinal compartilhado e pretende implementar "nos próximos meses", com outra atualização trazendo os detalhes
Ela cita o grupo AI Preferences do IETF como base
Enquanto isso, vale o que está na documentação de bots da OpenAI: o GPTBot é o agente que rastreia conteúdo que pode ser usado no treino dos modelos fundacionais, e bloquear ele indica que o conteúdo não deve entrar nesse treino

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.O Google pretende dar suporte ao sinal (user-agent __usage_ai-training) em 2027, então ainda não está ativo
Tem um detalhe importante: quando o site usar o token para recusar treino e não especificar nada para o Google-Extended, o Google pretende tratar isso como se o Google-Extended tivesse sido bloqueado
Microsoft (Bing)
O Bing vai começar a respeitar as novas preferências durante o rastreamento a partir de 01/02/2027
As preferências de AI Training no robots.txt valem para o site ou caminho, e as preferências de AI Training e AI Grounding no nível da página valem para páginas individuais
O que quem mantém sites precisa observar agora
Resumindo o que muda na prática pra quem cuida de site e infraestrutura web:
- As regras por crawler continuam necessárias: o sinal ainda não é aplicado de forma geral, então tirar o bloqueio do GPTBot ou de outros crawlers de IA agora pensando só no token seria dar um tiro no pé
- O curinga não resolve:
User-Agent: *não declara preferência pelo token, se tu quer usar o sinal, precisa do grupo__usage_ai-trainingexplícito - Efeito colateral no Google: segundo a análise do PPC Land com base na documentação do Google, o Google-Extended cobre treino e grounding, então o opt-out pelo token também tira o conteúdo do grounding no Gemini Apps
- Adesão é voluntária: o sinal só vale para os provedores que decidirem respeitar. Pelo menos OpenAI, Google, Microsoft e Anthropic confirmaram que vão aplicar o token (segundo o The Verge, Andy Stone, chefe de comunicação da Meta, sinalizou apoio ao sinal, mas a reportagem não confirma se a Meta vai de fato respeitá-lo)
- Não é bloqueio de acesso: se o objetivo é impedir que o crawler chegue no conteúdo, o token não faz isso, ele só declara preferência de uso (ainda que o rascunho peça que os crawlers evitem buscar o que não podem usar)
- Pode mudar: é uma versão -00 de rascunho, sintaxe e detalhes podem mudar até (e se) virar padrão
Aquele efeito no grounding do Google é o tipo de coisa que pega gente de surpresa, então vale pensar antes de sair colando o grupo no robots.txt de produção
Mudando de "token" no sentido de robots.txt pro "token" no sentido de consumo de modelo: se tu usa Claude Code no dia a dia, aqui no canal tem um vídeo com comandos do Claude Code pra economizar tokens, mto útil pra quem vive no terminal com IA
Próximo passo
Abre o robots.txt do teu site e mapeia quais crawlers de IA já estão tratados por user-agent hoje (GPTBot, Google-Extended e os demais que tu bloqueia ou libera)
Depois, decide qual é a tua preferência de treino de verdade, levando em conta que no Google o opt-out pelo token pode levar junto o grounding no Gemini Apps
E antes de depender só do token, acompanha o rascunho no IETF e as próximas atualizações da OpenAI e do Google, que ainda devem detalhar como vão aplicar o sinal
Até o próximo post! 🙂
Quer aprender mais sobre inteligência artificial e programação na prática? Conheça o canal Hora de Codar no YouTube e acompanhe os próximos vídeos.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
Como Recuperar Conversas Apagadas no ChatGPT: É Possível?
Conversas excluídas do ChatGPT não podem ser recuperadas pela interface ou pelo suporte. Se a conversa foi arquivada, você pode desarquivá-la. Se apenas sumiu da […]
ChatGPT não funciona: saiba como corrigir erros
ChatGPT não funciona? O ChatGPT pode deixar de funcionar por diversos motivos, e a maioria deles está relacionada a problemas de conexão, cache ou instabilidade […]
Como limpar histórico do ChatGPT e proteger sua privacidade
Veja como limpar o histórico do ChatGPT e proteger sua privacidade de forma simples e eficaz, mantendo seus dados seguros online. Para apagar uma conversa […]
