
OpenAI cria o Pando: o backend compatível com Git feito para o volume de código do Codex
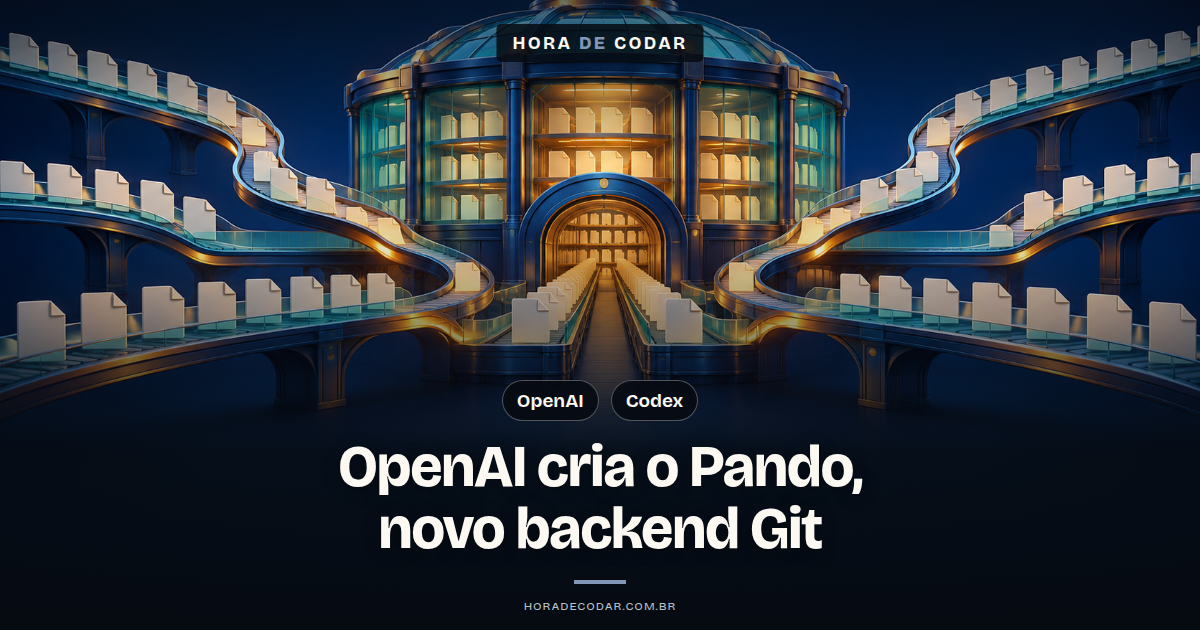
Fala aí, beleza? A OpenAI publicou o texto Scaling Git at OpenAI contando como construiu o Pando, um backend compatível com Git feito pra aguentar a escala de desenvolvimento que o Codex tornou possível
Hoje o Pando sustenta TODO o desenvolvimento no monorepo da OpenAI, e segundo a empresa a troca aconteceu sem interromper a engenharia e sem mudar o jeito como o time usa o Git 😀
Por que o Git padrão não aguentou o volume do Codex
O volume de commits do monorepo da OpenAI cresceu rápido demais, porque o Codex permite que muitas pessoas e agentes trabalhem ao mesmo tempo
E a confiabilidade dos merges, em alguns períodos, chegava a cair abaixo de 90%
Mas qual era o gargalo, na real?
Pensa assim: antes, um time de devs fazia push no ritmo humano, com café, reunião e tal
Aí entram agentes rodando em paralelo, cada um no seu branch, todos empurrando código ao mesmo tempo
O servidor passa a receber MUITO mais pushes concorrentes em muitos branches, e é exatamente aí que a coisa aperta

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
Como o Pando funciona por dentro
O Pando foi desenhado em cima de dois objetivos: escrita escalável horizontalmente, otimizada pra pushes concorrentes em muitos branches, e leitura com throughput máximo, pra que os clientes consigam saturar a banda de rede disponível
A troca central: consistência causal
Pra chegar nisso, o Pando abre mão da consistência global do repositório e adota consistência causal
Que raios é isso?
Na prática, não existe mais uma fila única pra todo o repositório: pushes em refs diferentes são confirmados em paralelo, e pushes no mesmo ref continuam serializados
Ou seja, dois agentes mexendo em branches diferentes não ficam mais esperando um ao outro 🙂
O caminho de um push
Quando chega um push, o Pando guarda o packfile recebido como um blob imutável em um blob store (armazenamento de objetos na nuvem)
A cada movimento do branch, um serviço de metadados registra a nova versão do ref (a "ref version") junto com suas dependências
O dado pesado fica no blob store, e o controle de qual versão depende de qual fica no metadata store
O lado da leitura
Pra escalar as leituras, o Pando reaproveita packfiles já gerados e em cache, em vez de montar um packfile individual pra cada cliente
Resultado: os leitores recebem os mesmos bytes

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →Quem já montou pipelines para grandes volumes de dados conhece bem essa lógica: recalcular tudo a cada pedido não escala, reaproveitar o que já foi processado sim
Rust e Codex nos bastidores
O Pando foi escrito em Rust, e a OpenAI criou um ferramental de testes extenso pra caçar bugs de concorrência
E tem um detalhe curioso: segundo a OpenAI, ele foi desenvolvido com ajuda do próprio Codex em cerca de 10 semanas, com um engenheiro desenhando o núcleo e times de agentes cuidando da implementação
O Codex criou o problema e ajudou a resolver haha
Os números do Pando em produção
Em produção, a OpenAI divulgou estes resultados:
- Latência mediana de push quase 80% menor (cerca de 5x)
- Confiabilidade de merge em 99,99%, contra períodos anteriores em que às vezes caía abaixo de 90%
- Quase 1 petabyte de dados Git entregues por dia
- Mais de 57 terabytes de packs servidos em uma única hora, com mais de 99% vindo do cache em disco local
Se liga: são números da própria OpenAI, medidos no ambiente dela e no monorepo dela
Não dá pra transportar isso direto pro seu repositório, beleza?
O que continua igual para quem usa Git
Segundo a OpenAI, o time continuou usando o Git do mesmo jeito, e a troca aconteceu sem interromper o trabalho de engenharia
A mudança está no backend, ou seja, no servidor que recebe e entrega os dados
Do lado do desenvolvedor, o fluxo seguiu o mesmo, e é justamente isso que o "compatível com Git" do nome entrega
É como trocar o motor do carro sem mexer no volante nem nos pedais 🙂
Vale reforçar: hoje o Pando é infraestrutura interna da OpenAI, sem disponibilidade pra terceiros: mas a própria empresa diz que está estudando formas de compartilhar com os usuários a tecnologia que torna o Pando possível

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Pando e Scion: OpenAI e Anthropic batendo no mesmo limite
São dois acontecimentos separados, mas o recado é parecido
A Anthropic criou o Scion, um sistema próprio de controle de versão pensado pro desenvolvimento com agentes em grande escala
A empresa diz que o Scion não é "de forma alguma um substituto adequado do Git para uso geral" e não se comprometeu com uma versão pública
O contraste concreto está na proposta: o Scion usa um cliente próprio (o scn), enquanto o Pando manteve a compatibilidade com o cliente Git do lado do desenvolvedor, trocando só o que roda no servidor
Duas empresas que vivem de agente de código chegaram no mesmo muro, cada uma resolvendo do seu jeito
O que isso significa para quem usa agentes de código
Pra maioria dos times, nada muda hoje, porque o Pando é infraestrutura interna da OpenAI
O impacto real é o sinal: quando agentes multiplicam commits, branches e merges em paralelo, o gargalo deixa de ser escrever código e passa a ser a infraestrutura de versionamento
Se o teu time está começando a rodar vários agentes ao mesmo tempo, vale ficar de olho em alguns pontos:
- Latência de push: se começar a subir conforme os agentes aumentam, é sintoma de contenção no servidor
- Conflitos: muitos agentes no mesmo trecho de código tendem a gerar mais conflito
- Falhas de merge: se merges começam a falhar com frequência, o problema pode não estar no código, e sim na infra
Não precisa sair reescrevendo o backend de Git em Rust, né? xD
Mas observar esses sinais cedo evita a surpresa de descobrir o limite quando o time já depende dos agentes no dia a dia
Agentes em paralelo na prática
Pra ter uma noção de como fica o lado de quem gera esse volume de código com agentes, vale conferir o vídeo abaixo no canal
Próximo passo
Vale ler o post "Scaling Git at OpenAI" na íntegra, principalmente as partes sobre consistência causal e reuso de packfiles, que são o coração da arquitetura
Depois, olha pro teu próprio repositório e acompanha como push, conflitos e merges se comportam conforme o uso de agentes cresce
Até o próximo post! 😀
Quer aprender mais sobre inteligência artificial e programação na prática? Conheça o canal Hora de Codar no YouTube e acompanhe os próximos vídeos.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
O que é o GPT-6 Astra e para que ele serve no dia a dia de quem programa?
GPT-6 Astra é o modelo mais avançado da OpenAI, com foco em coding e raciocínio complexo. Veja preço, contexto e uso no dia a dia de quem programa.
Jalapeño: por que o chip da OpenAI não obriga a escolher entre throughput e latência?
Jalapeño OpenAI é o chip de inferência feito com a Broadcom que promete throughput alto e latência baixa ao mesmo tempo. Veja os benchmarks da Hot Chips 2026.
Em quais modelos o chip Jalapeño da OpenAI foi testado? GPT-OSS 120B, DeepSeek R1 e Kimi K2.5
Jalapeño modelos testados: veja como o chip da OpenAI performou com GPT-OSS 120B, DeepSeek R1 e Kimi K2.5 contra a Nvidia.
