
O que é o MiMo-V2.6? Entenda a série de modelos de fronteira da Xiaomi
O MiMo-V2.6 é a série de modelos abertos da Xiaomi anunciada com o lema oficial de inteligência de fronteira, todas as modalidades e desenvolvimento em público. São três modelos: o Pro (MoE de 1,02 trilhão de parâmetros totais e 42 bilhões ativos), o Flash (309B totais e 15B ativos) e o Distill-Qwen-9B. Todos são nativamente omnimodais, aceitam texto, imagem, fala e vídeo como entrada e trabalham com janela de 1 milhão de tokens. Os pesos estão no Hugging Face sob licença MIT, e o Pro marca 46 no Intelligence Index do Artificial Analysis, o melhor entre pesos abertos
Apareceu do nada na sua timeline, todo mundo comentando, e você ficou sem saber se é mais um modelo chinês ou algo realmente diferente
A Xiaomi anunciou a série com uma frase curta e bem ambiciosa: "Frontier intelligence, all the modalities, built in public"
Ou seja: inteligência de fronteira, todas as modalidades e desenvolvimento em público
Neste post eu explico o que é a série, o que ela entrega de fato e o que ainda é promessa de fabricante, sem hype e sem chute 🙂
O que a Xiaomi anunciou com a série MiMo-V2.6
O anúncio veio pela conta oficial da Xiaomi MiMo e o posicionamento já diz tudo que eles querem vender: fronteira, multimodalidade completa e processo aberto
O Artificial Analysis registra o lançamento do MiMo-V2.6-Pro em 21 de setembro de 2026
E não foi só modelo solto
Junto vieram o MiMo Desktop e planos de assinatura, com duas formas de usar: pela assinatura ou plugando a sua própria chave de API
Tem também uma variante chamada MiMo-V2.6-Pro UltraSpeed, disponível no MiMo Desktop e via API, anunciada como até 20 vezes mais rápida na geração
Esse "até" é palavra do fabricante, então trate como claim de marketing até alguém medir em produção, beleza?

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 45min
MiMo-V2.6-Pro, Flash e Distill-Qwen-9B: as diferenças
A série não é um modelo só, são três
E cada um mira um bolso e um caso de uso diferente
| Modelo | Arquitetura e tamanho | Preço de API (por 1M tokens) |
|---|---|---|
| MiMo-V2.6-Pro | MoE com 1,02 trilhão de parâmetros totais e 42 bilhões ativos por inferência | US$ 0,435 entrada / US$ 0,87 saída |
| MiMo-V2.6-Flash | MoE esparso com 309 bilhões totais e 15 bilhões ativos, 48 camadas transformer, 256 experts roteados e 8 ativos por token | US$ 0,14 entrada / US$ 0,28 saída |
| MiMo-V2.6-Distill-Qwen-9B | 9B, fine-tuning supervisionado do Qwen3.5-9B sobre dados gerados pelo MiMo | Não informado |
Repara no detalhe do MoE (Mixture of Experts): o Pro tem 1,02 trilhão de parâmetros no total, mas só ativa 42 bilhões a cada inferência
É o mesmo truque que os modelos abertos grandes vêm usando: capacidade enorme guardada, custo de execução bem menor que o tamanho sugere
Se você conhece cache de aplicação, a lógica é parecida, tu não carrega tudo na memória o tempo todo, carrega o que a rota pede
E tem um ponto que eu achei massa: a Xiaomi afirma que a série MiMo-V2.6 mantém os MESMOS preços de API da série V2.5
Modelo novo, preço velho… não é sempre que rola isso
O que significa "todas as modalidades" na prática
Aqui é onde a conversa fica interessante de verdade
Os modelos da série são nativamente omnimodais: aceitam texto, imagem, fala e vídeo como entrada, e geram texto como saída
Somando a isso, a janela de contexto é de 1 milhão de tokens
"Nativamente" é a palavra chave. Não é um Whisper transcrevendo antes nem um OCR colado do lado, a entrada entra no mesmo modelo
O que isso destrava no dia a dia:
- Jogar um vídeo de reunião ou de aula e pedir resumo, decisões e pendências em texto
- Mandar áudio de suporte ou de call de cliente e extrair os pontos sem pipeline de transcrição separado
- Subir prints de tela, diagramas e erros de build junto com o código pra debugar com contexto visual
- Alimentar uma base de código longa ou um calhamaço de documentação e pedir análise cruzada, aproveitando a janela de 1M
Esse tipo de entrada mista casa bem com automação também
Se você já monta fluxo com inteligência artificial no n8n, a ideia de ter UM endpoint que engole áudio, imagem e texto simplifica bastante o desenho do workflow
Um detalhe importante pra não criar expectativa errada: a saída é texto
Não espere geração de imagem ou de áudio aqui
O MiMo-V2.6-Pro é bom mesmo? O que dizem os benchmarks
Bora aos números, que é o que interessa
Na página viva do Artificial Analysis, o MiMo-V2.6-Pro marca 46 no Intelligence Index e aparece como o modelo de pesos abertos mais bem colocado
Atrás dele ficam GLM-5.3 (max) com 45 e Kimi K3 (max) com 44
O índice usado é a versão v4.3.2, composta por 10 avaliações: AA-Briefcase v1.1, GDPval-AA v2.1, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity’s Last Exam, GDP.pdf, CritPt, AA-Omniscience e AA-LCR v1.1
Velocidade medida: 130 tokens por segundo
Nos benchmarks reportados pro Pro, se liga:
| Benchmark | MiMo-V2.6-Pro |
|---|---|
| SWE-bench Verified (modo thinking) | 78,6 |
| Terminal-Bench 2.1 | 89,9 |
| CyberGym | 94,0 |
| Terminal-Bench 4.0 | 34,9 |
Agora o contrapeso, porque post que só mostra o lado bonito é press release
No Terminal-Bench 4.0 o Pro fica em 34,9 contra 49,0 do Claude Opus 5
É uma diferença grande, no benchmark mais duro da lista
E a afirmação da Xiaomi de que o MiMo-V2.6-Pro está "on par" com Claude Opus 5 e GPT-5.6 Sol na maioria dos benchmarks de agente é claim do fabricante
Ela convive com o resultado do Terminal-Bench 4.0 ali em cima, então leia as duas coisas juntas
A leitura honesta na minha visão: é o melhor peso aberto medido nesse índice hoje, com preço de entrada muito abaixo do topo fechado, e ainda com gap nas tarefas de agente mais longas
Sobre o Flash, a Xiaomi diz que ele supera o MiMo-V2.5-Pro de forma ampla
Modelo menor batendo o topo da geração anterior é o padrão que a gente vem vendo se repetir… e continua sendo massa de ver
"Built in public": o que a Xiaomi abriu junto com os modelos
Essa parte é a que menos gera manchete e que mais importa pra quem constrói coisa
O pacote aberto da série inclui:
- Os pesos de Pro e Flash
- O relatório técnico
- Mais de 7.000 ambientes de tarefas de RL
- Um framework de RL ponta a ponta
- O modelo MiMo-V2.6-Distill-Qwen-9B, que também saiu de pesos abertos (a série foi lançada com os três modelos abertos)
E o que são esses ambientes de RL?
São cenários de treino por reforço pra tarefas de agente, cobrindo quatro domínios: engenharia de software, reprodução de vulnerabilidades, trabalho intensivo em conhecimento e web design/desenvolvimento
Ou seja, não é só o modelo pronto, é o ferramental que produziu o comportamento agêntico dele
E tem prova de que o ferramental funciona: o MiMo-V2.6-Distill-Qwen-9B é um agentic de 9B com fine-tuning supervisionado do Qwen3.5-9B sobre dados gerados pelo MiMo
Rodando RL com os ambientes liberados, o SWE-bench Verified dele subiu de 61,1 para 66,2
Um 9B saindo de 61,1 pra 66,2 com treino aberto e reproduzível é o tipo de coisa que muda o jogo pra quem tem GPU e não tem datacenter
A transparência foi até o custo
A Xiaomi publicou que o treino de RL custou cerca de US$ 3,47 milhões no total: aproximadamente US$ 850 mil no Flash e US$ 2,62 milhões no Pro
Tudo isso em cerca de 6 dias, com 30 passos de RL e cerca de 750 mil trajetórias por modelo
Empresa publicando fatura de treino não é comum, e ajuda muito quem tenta entender o que é realmente caro nesse processo
Como acessar o MiMo-V2.6 hoje
Três caminhos verificados, sem inventar moda:
- Pesos abertos no Hugging Face. Os três modelos da série (Pro, Flash e Distill-Qwen-9B) estão publicados na organização XiaomiMiMo sob licença MIT. MIT é licença permissiva, então uso comercial está liberado, o que já resolve a dúvida jurídica que sempre aparece nos comentários
- Via API pelo OpenRouter. O Pro está listado com provedores de API na página openrouter.ai/xiaomi/mimo-v2.6-pro. É o caminho mais rápido pra testar sem subir nada
- Pelo MiMo Desktop. Dá pra usar por assinatura ou com a sua própria chave de API, e é ali (e também na API) que aparece a variante Pro UltraSpeed
Tome cuidado com uma coisa: peso aberto não significa que roda na sua máquina
Um MoE de 1,02 trilhão de parâmetros totais não cabe no seu notebook, nem no PC da Nasa que tu montou ano passado haha
Se a ideia é hospedar algo da família por conta própria ou manter automações ligadas direto, aí a conversa vira infra, e rodar modelos em uma VPS costuma ser o caminho mais sensato que tentar no desktop
Pra teste rápido mesmo, começa pela API e só depois pensa em self-host
Vídeo: quando vale combinar vários modelos
Um modelo aberto forte raramente entra sozinho no seu stack, ele entra somando com o que você já usa
E essa ideia de combinar modelos diferentes já virou produto
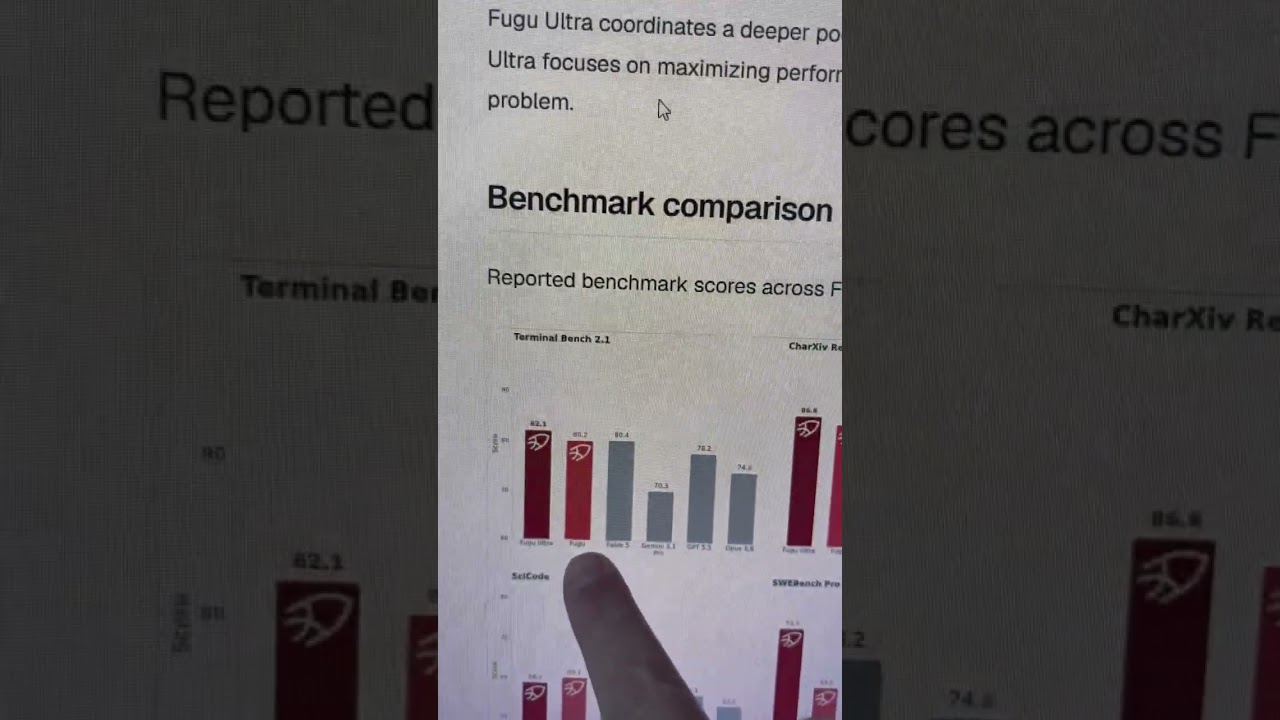
Pra entender esse conceito do zero, este vídeo do canal mostra o Sakana Fugu, um orquestrador que usa vários modelos ao mesmo tempo pra chegar na resposta final, com os benchmarks que eles apresentam e as ressalvas que dá pra fazer em cima dessa comparação
Conclusão
O MiMo-V2.6 chega como o peso aberto mais bem colocado no Intelligence Index v4.3.2, com 46 pontos, entrada de API barata e um pacote aberto que vai muito além dos pesos
Relatório técnico, mais de 7.000 ambientes de RL, framework de treino e até o custo da conta publicado
Mas benchmark não é produção, nunca foi
O 34,9 no Terminal-Bench 4.0 contra 49,0 do Claude Opus 5 é um lembrete bem concreto de que ainda tem gap nas tarefas de agente mais longas
Então o próximo passo é simples: pega o Flash ou o Pro via OpenRouter, joga uma tarefa REAL sua nele (aquela que você já sabe de cor como o seu modelo atual resolve) e compara o resultado e a conta no fim do mês
É assim que dá pra saber se vale sair do lock-in ou se é só barulho de lançamento
Bora testar e me conta o que deu?
Até o próximo post! 😀
Perguntas frequentes
Quanto custa usar a API do MiMo-V2.6-Pro e do Flash?
O MiMo-V2.6-Pro sai por US$ 0,435 a cada milhão de tokens de entrada e US$ 0,87 por milhão de saída. O Flash é bem mais barato: US$ 0,14 de entrada e US$ 0,28 de saída por milhão de tokens. A Xiaomi mantém esses valores iguais aos da série V2.5 anterior.
Onde baixar os pesos do MiMo-V2.6 e qual a licença?
Os pesos abertos da série estão publicados na organização XiaomiMiMo no Hugging Face, e são os três modelos: Pro, Flash e Distill-Qwen-9B. A licença usada é a MIT, que permite uso e modificação com poucas restrições.
Qual a diferença de parâmetros ativos entre MiMo-V2.6-Pro e Flash?
O Pro é um MoE com 1,02 trilhão de parâmetros totais e ativa 42 bilhões por inferência. O Flash é bem menor: 309 bilhões totais, com 15 bilhões ativos, distribuídos em 48 camadas transformer e 256 experts roteados, dos quais 8 são ativados por token.
O que é o MiMo-V2.6-Distill-Qwen-9B e pra que ele serve?
É um modelo agentic de 9B feito pela Xiaomi MiMo com fine-tuning supervisionado sobre o Qwen3.5-9B, usando dados gerados pelo próprio MiMo. Depois de passar por RL com os ambientes de tarefas liberados pela série, o resultado dele no SWE-bench Verified subiu de 61,1 para 66,2.
Quanto custou treinar a série MiMo-V2.6 com RL?
A Xiaomi publicou o custo total: cerca de US$ 3,47 milhões, sendo aproximadamente US$ 850 mil no Flash e US$ 2,62 milhões no Pro. O treino levou cerca de 6 dias, com 30 passos de RL e por volta de 750 mil trajetórias para cada modelo.
O MiMo-V2.6-Pro está disponível em algum agregador de API além da Xiaomi?
Sim, o MiMo-V2.6-Pro também está listado com provedores de API no OpenRouter. É uma opção pra quem já usa esse tipo de agregador e quer testar o modelo sem trocar de infraestrutura.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 27min




Blog | Mais populares
Kimi K3, GLM ou DeepSeek: qual modelo barato aguenta refatorar código de verdade?
Kimi K3 vs GLM vs DeepSeek num teste real de refatoração: veja custo por token, erros e retrabalho para escolher o modelo barato certo no Claude Code.
O que é Jev, o System One Model da TypeSafe AI?
Jev é o System One model da TypeSafe AI: entenda como funciona, o que ele resolve e quanto custa esse modelo de decisão estruturada.
O que é o Hy4 preview, o modelo de 770B da Tencent?
O Hy4 preview é o novo modelo da Tencent: MoE de 770B parâmetros (49B ativos), 1M de tokens de contexto e pesos abertos sob Apache 2.0. Veja o que ele faz.
