MiMo-V2.6 vs modelos fechados: como comparar sem cair em benchmark de marketing
O MiMo-V2.6 é a série de modelos que a Xiaomi lançou em 21/09/2026 com pesos, código e relatório técnico sob licença MIT, e isso faz dela um ótimo caso pra aprender a comparar aberto contra fechado sem engolir gráfico de anúncio. O caminho é montar critérios: índice composto independente e versionado, preço por milhão de tokens, contexto e limite de saída, modalidades, transparência do processo de treino e controle sobre os pesos. No Artificial Analysis Intelligence Index o Pro marca 46, contra 53 do topo fechado, mas o preço e a auditabilidade contam muito na decisão real
Todo lançamento vem com aquele gráfico de barrinhas onde o modelo novo é o mais alto
E aí você compara um modelo de pesos abertos com um fechado usando um número solto, sem saber qual avaliação gerou aquilo, em qual versão, com qual preço por token no outro lado da mesa
O MiMo-V2.6 é o caso perfeito pra treinar o olho nisso. A Xiaomi lançou a série em 21/09/2026 publicando pesos, código e relatório técnico sob licença MIT, com o MiMo-V2.6-Pro e o MiMo-V2.6-Flash em repositórios sem gate
Ou seja: dá pra conferir quase tudo em vez de acreditar em slide. Bora montar a comparação do jeito certo?
O que é a série MiMo-V2.6 e por que ela serve de régua
Antes do julgamento, a ficha técnica. Sem ficha, comparação é chute
- MiMo-V2.6-Pro: MoE esparso com 1,02 trilhão de parâmetros totais e 42 bilhões ativados por token
- MiMo-V2.6-Flash: MoE com 309 bilhões de parâmetros totais e 15 bilhões ativados por token
- Modalidades: nativamente omnimodal, texto, imagem, vídeo e áudio no mesmo modelo
- Contexto: janela de 1 milhão de tokens
E o que tem na API oficial? A documentação da MiMo lista três modelos na série V2.6: mimo-v2.6-pro, mimo-v2.6-flash e mimo-v2.6-pro-ultraspeed, esse último descrito como o desempenho do V2.6-Pro até 20x mais rápido
Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 45min
Os pesos oficiais vivem no Hugging Face, em XiaomiMiMo/MiMo-V2.6-Pro-RL e no repo equivalente do Flash, os dois MIT e sem gate
O relatório técnico não ficou escondido num PDF de imprensa: o arquivo MiMo_V2_6_technical_report.pdf está na raiz do repo de pesos do Pro
É por isso que a série serve de régua. Quando um lado publica pesos, licença, stack e relatório, os critérios de comparação ficam visíveis. Quando o outro lado não publica, o que sobra é benchmark de marketing 🙂
Os 6 critérios que importam mais que o benchmark do anúncio
Minha lista é essa, na ordem em que costumo aplicar:
- índice composto independente (e versionado)
- preço por milhão de tokens, entrada e saída separados
- contexto e limite de saída
- modalidades cobertas nativamente
- transparência do processo de treino
- controle e portabilidade (licença, pesos, provedores)
Agora os mesmos critérios preenchidos só com dado verificado, MiMo-V2.6 contra os fechados de topo:
| Critério | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Fechados de topo |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 46, o melhor colocado de pesos abertos do leaderboard | sem pontuação de terceiro localizada | Claude Fable 5.1 (max) 53, GPT-6 Astra (max) 53, Claude Opus 5 (max) 51, GPT-5.6 Sol (max) 47 |
| Preço por 1M de tokens | US$ 0,435 entrada e US$ 0,87 saída (divulgado pela Xiaomi) | US$ 0,14 entrada, US$ 0,28 saída e US$ 0,0028 em leitura de cache (OpenRouter) | Claude Opus 5 a partir de US$ 5 entrada e US$ 25 saída na API da Anthropic |
| Contexto e saída | janela de 1 milhão de tokens | 1.048.576 tokens de contexto e até 131.072 de saída na OpenRouter | não coberto pelos dados aqui |
| Modalidades | texto, imagem, vídeo e áudio no mesmo modelo | texto, imagem, vídeo e áudio no mesmo modelo | não coberto pelos dados aqui |
| Transparência do treino | painel público de RL, stack aberto e relatório técnico no repo | painel público de RL do run do Flash | acesso por API, sem pesos nem logs de treino publicados |
| Controle e portabilidade | pesos MIT sem gate no Hugging Face | pesos MIT sem gate, e na OpenRouter a página indica um único provedor hospedando o modelo | API fechada |
Repare no que a tabela faz com você: o Pro perde em pontuação de índice e ganha em preço, contexto, modalidade e controle
Nenhum dos dois lados "ganha" no geral. Quem ganha é o critério que pesa na SUA tarefa
Como aplicar os critérios ao seu caso (4 cenários)
1. Volume alto e tarefa repetitiva:
Aqui o critério de preço atropela tudo o resto
Classificar ticket, extrair campo de nota fiscal, resumir transcrição em lote: a diferença entre US$ 0,28 e US$ 25 por milhão de tokens de saída não é detalhe, é o orçamento do mês
É o mesmo raciocínio de quem monta esteira com modelos prontos de automação n8n: o fluxo roda milhares de vezes, então o custo unitário manda
2. Auditoria, compliance e rodar dentro de casa:
Se o seu cliente pergunta "onde esse dado trafega" e "o que exatamente foi treinado", pesos MIT sem gate mais relatório técnico público vencem qualquer pontinho de benchmark
Com API fechada você tem contrato. Com peso aberto você tem o arquivo
3. Teto de raciocínio em tarefa difícil:
Aqui eu não vou fingir. Os 53 do topo fechado no índice contra 46 do Pro existem, e em tarefa cabeluda essa distância aparece
Refatoração longa, problema com muitos passos encadeados, raciocínio que não perdoa desvio: teste antes de migrar por preço
E vale lembrar do outro lado da moeda: tem um monte de tarefa em que qualquer modelo entrega igual, e nesses casos comparar é perda de tempo
4. Pipeline multimodal com documento gigante:
Esse é o cenário onde o MiMo-V2.6 brilha por arquitetura, não por placar
Texto, imagem, vídeo e áudio em um único modelo, com 1 milhão de tokens de janela, significa menos cola entre serviços, menos conversão, menos ponto de falha
Um aviso operacional honesto: a página do Flash na OpenRouter indica um único provedor hospedando o modelo. Provedor único é risco de disponibilidade, então se o seu produto depende disso, planeje o plano B (os pesos são MIT, então o plano B existe)
Por que eu prefiro comparar critérios a comparar campeões
Tem um vídeo meu sobre o Sakana Fugu, um sistema que usa vários modelos ao mesmo tempo, que explica bem a minha birra com placar
No vídeo eu mostro um benchmark onde o Fugu aparece com desempenho melhor que GPT e Opus, e eu já desconfio na hora: se ele provavelmente usa esses mesmos modelos por trás dos panos pra gerar a resposta, dizer que ele é "melhor" que eles fica estranho, né?
O que me incomoda não é o número, é a caixa fechada. Pelo que dá pra ver de fora, chega só o resultado final, sem detalhe de qual modelo respondeu nem do critério daquela escolha
E aí você não tem critério, tem só o pódio
Eu fiz um teste mais completo dele em outro vídeo, criando vários projetos pra ver o potencial real, e a conclusão prática é sempre a mesma: na vida real você não escolhe UM modelo, você escolhe qual modelo entra em qual etapa
Por isso critério vence campeão. Critério você aplica na sua etapa. Campeão só serve pra thread de Twitter 😛
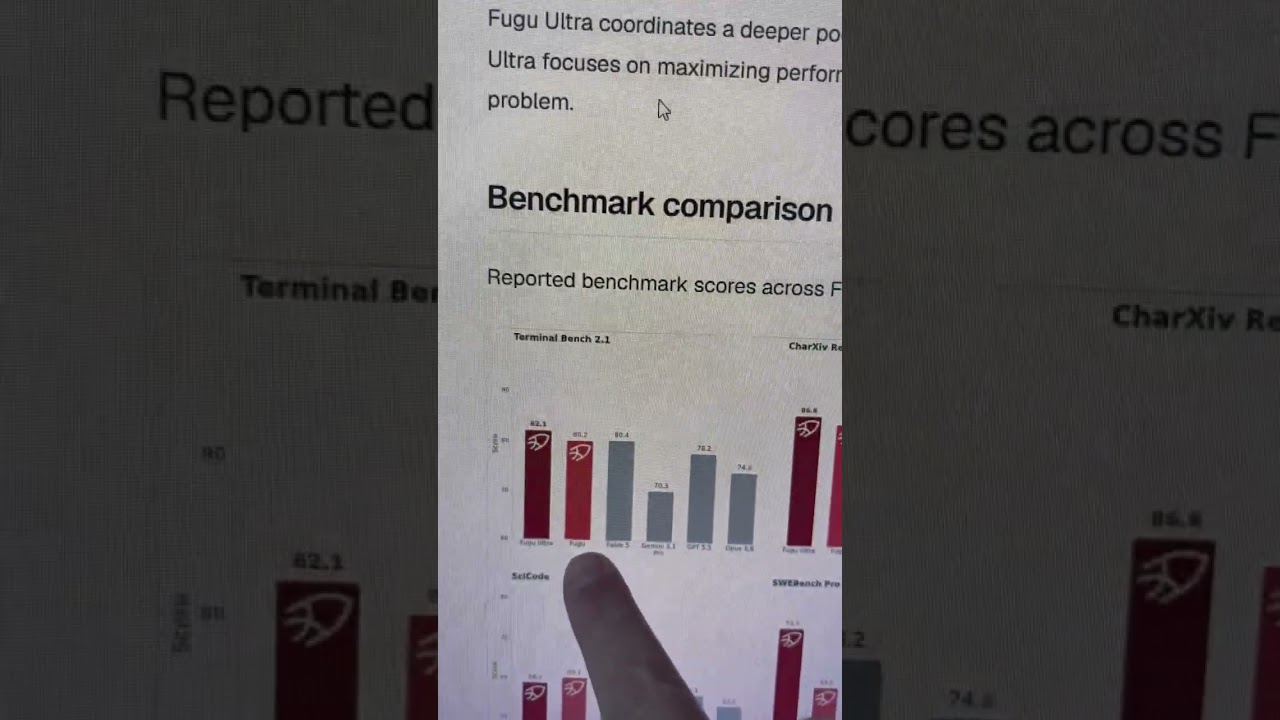
Nesse vídeo eu mostro como funciona um sistema que roda vários modelos ao mesmo tempo, o benchmark que ele exibe e por que eu olho aquele resultado com desconfiança
Transparência do processo: o que a Xiaomi mostrou e um modelo fechado não mostra
Esse é o critério que mais separa os dois mundos, e é o menos comentado
A Xiaomi publicou um painel público com os logs do treino de reinforcement learning do MiMo-V2.6, em mimo.xiaomi.com/rl, exibindo métricas ao vivo do trainer
Dois jobs de pós-treino por RL (Pro e Flash) começaram em 15/09/2026, e o painel público foi noticiado em 18/09/2026
| O que foi publicado | O que isso te permite verificar |
|---|---|
| Curvas de recompensa dos runs do Pro e do Flash | se o ganho veio de treino consistente ou de um pico solto |
| Contagem de rollouts e tempo por passo | a escala real do pós-treino, não a adjetivada |
| Custo computacional acumulado | aproximadamente US$ 2,62 milhões no Pro e cerca de US$ 850 mil no Flash |
| Escala declarada do RL | 30 passos grandes cobrindo cerca de 750.000 trajetórias em menos de seis dias |
| Método de pós-treino no card | GRPO totalmente assíncrono, batches de 1.568 prompts x 16 rollouts por passo, em um run misto de código, agentes gerais, visão e cibersegurança |
| Stack de RL aberto | mais de 7.000 ambientes de RD graduados (engenharia de software, reprodução de vulnerabilidades, trabalho intensivo em conhecimento e design/desenvolvimento web), framework ponta a ponta sobre o verl e mini-harnesses componíveis, sob MIT |
Se liga no que muda aqui. Um modelo fechado te dá o resultado e a conta
Essa série te dá o resultado, a conta, o método e os ambientes de treino. Você pode discordar do número e ir ver o log
E dá pra fazer a pergunta mais importante de todas sobre um benchmark: esse ganho apareceu em qual tipo de ambiente? Com stack aberto, isso é uma consulta. Com API fechada, é fé
Como montar sua própria comparação em 5 passos
- Escolha um índice composto e ANOTE a versão
Índice composto existe justamente pra você não decidir por uma avaliação só. O Artificial Analysis Intelligence Index na versão v4.3.2 combina 10 avaliações: AA-Briefcase v1.1, GDPval-AA v2.1, AutomationBench-AA, Terminal-Bench 4.0, SciCode, AA-LCR v1.1, AA-Omniscience, Humanity’s Last Exam, GDP.pdf e CritPt
O erro comum deste passo: citar o número sem a versão e sem a data. A página do leaderboard é viva, ela muda, e o print de hoje não prova nada em dezembro
- Confira o preço medido por terceiro contra o preço do fornecedor
A Xiaomi divulgou US$ 0,435 por milhão de entrada e US$ 0,87 de saída no Pro. Na página do modelo no Artificial Analysis o preço listado é US$ 0,43 e US$ 0,87
O erro comum deste passo: comparar preço de anúncio de um lado com preço de provedor do outro. Padronize a fonte antes de fazer a conta, senão a planilha mente bonitinho
- Compare contra a MEDIANA, não só contra o topo
Índice 46 no Pro parece pouco ao lado dos 53 do topo fechado, até você ver que a mediana dos modelos comparáveis na mesma página é 18
O erro comum deste passo: montar comparação só com os quatro melhores do mundo e concluir que o resto é lixo. A sua alternativa real quase nunca é o topo absoluto
- Defina a SUA tarefa e o critério de aprovação antes de testar
Escreva 20 ou 30 casos da sua rotina, com entrada real e saída esperada, e um critério binário de passou/não passou. Só depois rode nos candidatos
# esqueleto do que você precisa ter em mãos
casos/
  001_entrada.txt   001_esperado.txt
  002_entrada.txt   002_esperado.txt
  ...
criterio.md         # o que conta como aprovado, escrito antes do teste
resultados.csv      # modelo, caso, passou, tokens_saida, custo
O erro comum deste passo: definir o critério DEPOIS de ver a resposta bonita do modelo. Aí você não testou nada, você se convenceu
- Calcule custo total considerando verborragia
Preço por token não é custo. Custo é preço multiplicado por quantos tokens o modelo cospe pra resolver o seu caso
O Artificial Analysis descreve o Pro como entre os líderes em inteligência, com preço razoável frente a outros modelos de pesos abertos de tamanho similar, além de rápido, porém verborrágico. Modelo falante infla justamente o token de saída, que é o mais caro dos dois lados
O erro comum deste passo: comparar tabela de preço e parar ali. Registre tokens_saida por caso no seu CSV e faça a conta com o número medido, não com o anunciado
Veredito: quando o MiMo-V2.6 substitui um modelo fechado (e quando não)
Substitui bem quando o que pesa é custo por token, contexto longo, multimodalidade nativa e auditabilidade
Esteira de alto volume, ingestão de documento gigante, pipeline que mistura áudio, imagem e texto, projeto que precisa de licença permissiva e peso na mão: nesse território o MiMo-V2.6 não é "a alternativa barata", é a escolha coerente
Não substitui quando os pontos de topo do índice viram diferença real na sua tarefa. A distância entre 46 e 53 existe, e em trabalho de raciocínio longo e encadeado ela aparece no resultado, não só no gráfico
E tem o ponto operacional: provedor único hospedando o Flash na OpenRouter é um risco que o preço bonito não apaga. Com peso MIT você tem saída, mas precisa planejar essa saída antes da primeira indisponibilidade
Última coisa, e essa é a mais importante: nenhum número aqui é veredito eterno. O leaderboard é página viva, preço muda, modelo novo entra. O que dura é o método de comparar 🙂
Conclusão
Recapitulando os critérios que valem mais que a barrinha do anúncio:
- índice composto independente, com versão e data anotadas
- preço de entrada, de saída e de cache, da mesma fonte nos dois lados
- contexto e limite de saída, medidos onde você vai rodar
- modalidades cobertas nativamente pelo mesmo modelo
- transparência do processo de treino (painel, método, ambientes)
- controle e portabilidade: licença, pesos e quantos provedores existem
O próximo passo é chato e é o único que funciona: pegue a sua tarefa, monte os 20 casos e rode antes de migrar
Comece pelo Flash por causa do custo, e se a qualidade não bater, suba pro Pro e compare de novo
Depois abre o MiMo_V2_6_technical_report.pdf no repo oficial e lê com calma. É raro ter esse material na mão, seria desperdício decidir por print de benchmark tendo o relatório aberto ali…
Até o próximo post!
Perguntas frequentes
Quanto custa usar o MiMo-V2.6-Pro pela API comparado a um modelo fechado como o Claude Opus 5?
A Xiaomi divulga US$ 0,435 por milhão de tokens de entrada e US$ 0,87 por milhão de saída para o MiMo-V2.6-Pro. O Claude Opus 5 na API da Anthropic parte de US$ 5 por milhão de entrada e US$ 25 por milhão de saída, uma diferença que pesa bastante em uso de volume.
O MiMo-V2.6 é open source e dá pra rodar os pesos por conta própria?
Sim, a Xiaomi publicou os pesos sob licença MIT e sem gate nos repositórios XiaomiMiMo/MiMo-V2.6-Pro-RL e XiaomiMiMo/MiMo-V2.6-Flash-RL no Hugging Face. O código e o framework de RL usado no pós-treino também foram abertos junto.
Qual a diferença entre MiMo-V2.6-Pro e MiMo-V2.6-Flash?
O Pro é um MoE esparso com 1,02 trilhão de parâmetros totais e 42 bilhões ativados por token, enquanto o Flash tem 309 bilhões de parâmetros totais e 15 bilhões ativados. Na OpenRouter o Flash sai por US$ 0,14 por milhão de tokens de entrada e US$ 0,28 de saída, mais barato que o Pro.
O MiMo-V2.6-Pro fica na frente dos modelos fechados no Artificial Analysis Intelligence Index?
Não. O Pro pontua 46 no índice, o melhor entre os modelos de pesos abertos do leaderboard, mas atrás de Claude Fable 5.1 e GPT-6 Astra (53 cada), Claude Opus 5 (51) e GPT-5.6 Sol (47). O índice é composto e versionado, então vale olhar a composição e a versão antes de comparar só o número final.
O que é o mimo-v2.6-pro-ultraspeed listado na documentação da API?
É o terceiro modelo da série V2.6 na API oficial da MiMo, ao lado do mimo-v2.6-pro e do mimo-v2.6-flash. A documentação descreve o ultraspeed como o desempenho do Pro entregue até 20x mais rápido.
Onde ver o relatório técnico e os logs de treino do MiMo-V2.6?
O relatório técnico está no arquivo MiMo_V2_6_technical_report.pdf, na raiz do repositório de pesos do Pro no Hugging Face. Os logs de RL ficam expostos ao vivo no painel público em mimo.xiaomi.com/rl, com curvas de recompensa, contagem de rollouts e custo computacional acumulado dos runs do Pro e do Flash.
Matheus Battisti
Formações
Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 27min
Blog | Mais populares
Kimi K3, GLM ou DeepSeek: qual modelo barato aguenta refatorar código de verdade?
Kimi K3 vs GLM vs DeepSeek num teste real de refatoração: veja custo por token, erros e retrabalho para escolher o modelo barato certo no Claude Code.
O que é Jev, o System One Model da TypeSafe AI?
Jev é o System One model da TypeSafe AI: entenda como funciona, o que ele resolve e quanto custa esse modelo de decisão estruturada.
O que é o Hy4 preview, o modelo de 770B da Tencent?
O Hy4 preview é o novo modelo da Tencent: MoE de 770B parâmetros (49B ativos), 1M de tokens de contexto e pesos abertos sob Apache 2.0. Veja o que ele faz.