
GPT-6 Astra ou modelo chinês: o que muda na prática além do preço?
GPT-6 Astra vs modelos chineses é uma decisão que quase ninguém fecha só pelo preço, apesar de a conversa sempre começar por aí. O Astra saiu em 03/09/2026 com liberação escalonada; em 04/09 o acesso ainda estava restrito a um conjunto pequeno de organizações, mas o rollout já terminou e o modelo está disponível na API da OpenAI, no Microsoft Foundry, no Amazon Bedrock (GA desde 08/09/2026) e no GitHub Copilot; no ChatGPT, o acesso segue desigual entre planos: o Plus só acessa via Work e Codex, enquanto Pro e Business Premium recebem o modelo no chat como "GPT-6 Pro", com o chat padrão continuando no GPT-5.6 Sol. Do outro lado, DeepSeek, Qwen e Kimi expõem endpoints compatíveis com a API da OpenAI, o que deixa o teste barato. O que decide de verdade: onde o dado fica armazenado, se dá para rodar pesos abertos e como o modelo se comporta em temas sensíveis: vale lembrar que o estudo mais citado sobre recusa em temas políticos testou DeepSeek, mas não Qwen nem Kimi
Trocar de modelo por preço é a parte fácil
O resto da conta aparece depois: quando o acesso não vem, quando alguém pergunta em que país o dado está parado, quando a resposta encurta justo no assunto que interessa
A OpenAI lançou o GPT-6 Astra em 03/09/2026 e, na mesma semana, muita gente que já tinha cogitado migrar para DeepSeek, Qwen ou Kimi voltou a fazer a pergunta antiga: vale a pena?
O que pesa de verdade nessa decisão é acesso, integração, onde o dado mora e como o modelo se comporta
Bora por partes? 🙂
Como está o acesso ao GPT-6 Astra agora:
O lançamento foi em 03/09/2026, com rollout em etapas
A promessa oficial era chegar a ChatGPT Plus, Pro, Business e Enterprise, à API, à Microsoft Azure e à AWS Bedrock, com disponibilidade ampla anunciada para os dias seguintes
Nos primeiros dias, esse plano andou mais devagar que o anunciado: as notas de versão do ChatGPT de 4 de setembro ainda descreviam o Astra como restrito a um pequeno conjunto de organizações
O primeiro grupo a receber acesso foram organizações do programa de cibersegurança Daybreak, da OpenAI

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 116 aulas
- 4 projetos
- 9h 23min
No ecossistema Microsoft, o modelo começou a ser liberado pelo Microsoft Foundry Limited Access Program, com expansão gradual para clientes participantes
E por que tanto portão? O GPT-6 Astra é o primeiro modelo da OpenAI classificado no nível Critical de capacidade em cibersegurança dentro do Preparedness Framework, o que faz parte das funções sensíveis ficar atrás de programa de acesso restrito
O atraso doeu em quem paga: a OpenAI anunciou que usuários de ChatGPT Work e Codex ganhariam um reset acumulado por dia sem acesso ao Astra, e Sam Altman chegou a dizer que esperava liberar o modelo no fim de semana, sem poder prometer
Essa fase já passou: o rollout restrito terminou, e hoje o GPT-6 Astra está disponível na API da OpenAI, no Microsoft Foundry, no Amazon Bedrock (com disponibilidade geral desde 08/09/2026) e no GitHub Copilot; no ChatGPT, porém, o acesso segue desigual entre planos: no Plus, o Astra aparece só no ChatGPT Work e no Codex, sem chegar ao chat comum, enquanto Pro e Business Premium recebem o modelo no chat como "GPT-6 Pro", com o chat padrão continuando no GPT-5.6 Sol
O ponto prático que fica dessa história: plano pago elegível não é garantia automática de acesso no dia do anúncio, nem de acesso igual entre planos: nesse caso, a espera durou pouco mais de uma semana entre o lançamento e a disponibilidade ampla, e mesmo essa disponibilidade veio fatiada por plano dentro do próprio ChatGPT
GPT-6 Astra e modelos chineses: comparação por critério
A tabela abaixo só traz o que é verificável nas fontes oficiais de cada provedor
Onde não existe dado confirmado, fica indicado, porque chute em post de decisão é pior que lacuna
| Critério | GPT-6 Astra (OpenAI) | DeepSeek | Qwen (Alibaba Cloud Model Studio) | Kimi (Moonshot AI) |
|---|---|---|---|---|
| Disponibilidade (situação em 13/09/2026) | Lançado em 03/09/2026 com rollout escalonado, restrito a um pequeno grupo de organizações nos primeiros dias; o rollout já terminou e o modelo está disponível na API da OpenAI, no Microsoft Foundry, no Amazon Bedrock (GA desde 08/09/2026) e no GitHub Copilot; no ChatGPT, o Plus só acessa via Work e Codex (não no chat comum), enquanto Pro e Business Premium recebem o modelo no chat como "GPT-6 Pro" | API pública documentada | API pública documentada | API pública documentada |
| Como se conecta | Model id gpt-6-astra na API da OpenAI |
SDK da OpenAI apontando base_url para https://api.deepseek.com |
Interface compatível com OpenAI em https://dashscope-intl.aliyuncs.com/compatible-mode/v1 |
Endpoint compatível com OpenAI em https://api.moonshot.ai/v1 |
| Onde os dados ficam | Residência de dados para clientes corporativos em Europa, Reino Unido, EUA, Canadá, Japão, Coreia do Sul, Cingapura, Índia, Austrália e Emirados Árabes Unidos (Brasil fora da lista) | Política informa coleta, processamento e armazenamento de dados pessoais na República Popular da China | A região selecionada no Model Studio determina onde os dados são armazenados; o escopo de implantação determina onde ocorre a inferência. Confira as regiões disponíveis no console e as condições do modelo (documentação) | Sem dado confirmado |
| Uso dos dados para treino | Dados da API não treinam os modelos por padrão, retenção de até 30 dias para monitoramento de abuso e Zero Data Retention para endpoints elegíveis | Sem dado confirmado | Sem dado confirmado | Sem dado confirmado |
| Pesos abertos e execução própria | Sem dado confirmado | Pesos do DeepSeek-V4-Pro publicados no Hugging Face sob licença MIT, com uso comercial, modificação e execução em infra própria | Sem dado confirmado | Sem dado confirmado |
| Presença em nuvem | Microsoft Foundry, API da OpenAI, Amazon Bedrock (GA desde 08/09/2026), GitHub Copilot e ChatGPT (Plus via Work/Codex; Pro e Business Premium no chat como "GPT-6 Pro") | Modelos DeepSeek no Amazon Bedrock, incluídos na expansão da AWS de outubro/2025 para US East (Ohio) e Ásia-Pacífico (Jacarta) | Modelos Qwen também no Amazon Bedrock, na mesma expansão da AWS, com parte dos modelos Qwen3 (32B, 235B e Coder-30B) chegando também à Europa (Frankfurt) | Kimi K2.5 adicionado como modelo totalmente gerenciado no Amazon Bedrock em 10/02/2026, junto com DeepSeek V3.2, MiniMax M2.1, GLM 4.7, GLM 4.7 Flash e Qwen3 Coder Next |
| Temas politicamente sensíveis | Estudo da PNAS Nexus com 145 perguntas mediu 0% a 3% de recusa em modelos ocidentais | 30% a 60% de recusa em modelos de origem chinesa no mesmo estudo (DeepSeek fez parte da amostra) | Não avaliado nesse estudo: a amostra chinesa foi BaiChuan, ChatGLM, Ernie Bot e DeepSeek | Não avaliado nesse estudo: a amostra chinesa foi BaiChuan, ChatGLM, Ernie Bot e DeepSeek |
Repare que a linha de integração é quase idêntica nos três provedores chineses
Isso muda o peso do argumento de lock-in, e a gente volta nisso no veredito
O que isso muda para quem desenvolve no Brasil:
O Brasil está entre os dez maiores mercados da OpenAI em número de clientes corporativos, com crescimento de cinco vezes ano a ano em assentos do ChatGPT Enterprise
Ou seja: mercado grande, adoção acelerada
Só que o Brasil não aparece na lista de regiões com residência de dados da OpenAI para clientes corporativos
E aqui mora a parte chata da conversa
Se o teu projeto precisa justificar para um cliente, para um jurídico ou para um comitê interno onde o dado trafega e onde ele descansa, esse é o tipo de pergunta que aparece na reunião antes de qualquer planilha de custo
É por isso que duas alternativas entram no papo mesmo entre quem prefere a OpenAI: rodar pesos abertos em infraestrutura própria (o DeepSeek-V4-Pro está no Hugging Face sob licença MIT, que permite uso comercial, modificação e execução onde você quiser) ou consumir modelo via Amazon Bedrock escolhendo a região
Não estou dizendo que existe uma exigência legal específica te obrigando a isso
Estou dizendo que a pergunta vai chegar, e que a resposta "não sei" custa caro 😛
Quando cada escolha faz sentido:
Produto que precisa entrar em produção esta semana:
Isso já deixou de ser problema: o rollout restrito que limitava o Astra a um pequeno grupo de organizações em 04/09/2026 terminou, e o modelo está disponível na API da OpenAI, no Microsoft Foundry, no Amazon Bedrock (GA desde 08/09/2026) e no GitHub Copilot; no ChatGPT, vale lembrar que o Plus só acessa via Work e Codex, e quem quer o Astra no chat propriamente dito precisa de Pro ou Business Premium (lá, ele aparece como "GPT-6 Pro")
Vale guardar a lição mesmo assim: entre o lançamento e a disponibilidade ampla passou pouco mais de uma semana, e quem tinha prazo fechado bem no meio desse intervalo sentiu a diferença: não dá pra tratar "anunciado" como sinônimo de "disponível na tua conta" quando o próximo modelo sair
Time que já tem código com o SDK da OpenAI:
Esse é o cenário mais barato de testar
A API da DeepSeek usa formato compatível com a da OpenAI, os modelos Qwen no Alibaba Cloud Model Studio expõem interface compatível exigindo trocar apenas chave, base URL e nome do modelo, e a plataforma Kimi oferece endpoint compatível também
Na prática, o teu diff é isso:
from openai import OpenAI

# mesmo SDK, só muda chave e base_url
client = OpenAI(
    api_key="SUA_CHAVE",
    base_url="https://api.deepseek.com",
)

# para Qwen: https://dashscope-intl.aliyuncs.com/compatible-mode/v1
# para Kimi: https://api.moonshot.ai/v1
O erro comum aqui é achar que compatibilidade de API significa comportamento igual
O transporte é o mesmo, o modelo do outro lado não é, e prompt que funcionava lindo pode precisar de ajuste (vale a mesma lógica de escrever prompt para modelo de raciocínio, que muda mais do que parece)
Projeto com dado sensível ou necessidade de retenção zero:
A OpenAI declara que dados enviados pela API não são usados para treinar os modelos por padrão, com retenção de até 30 dias para monitoramento de abuso e opção de retenção zero para endpoints elegíveis
Do lado da DeepSeek, a política de privacidade informa que a empresa coleta, processa e armazena dados pessoais na República Popular da China
São dois fatos de natureza diferente, e é exatamente essa diferença que o teu time precisa colocar no papel
Aplicação que toca tema político, jornalístico ou de moderação:
Aqui tem número, e ele é feio pra um lado específico
Um estudo publicado na PNAS Nexus testou nove modelos com 145 perguntas politicamente sensíveis e encontrou taxa de recusa de 30% a 60% nos modelos chineses da amostra: BaiChuan, ChatGLM, Ernie Bot e DeepSeek: , contra 0% a 3% em modelos ocidentais, além de respostas mais curtas e imprecisas
Qwen e Kimi não fizeram parte dessa amostra, então esse número não pode ser estendido a eles sem dado próprio
Se o teu produto vive nesse território, isso não é detalhe de rodapé: é requisito: e, no caso de Qwen e Kimi, um requisito que ainda precisa de teste próprio, já que o estudo não cobriu esses dois
Quem quer rodar on-premises ou modificar o modelo:
Pesos abertos ganham fácil
A licença MIT do DeepSeek-V4-Pro permite uso comercial, modificação e execução em infraestrutura própria, o que nenhum acesso via API entrega
Sim, isso pede máquina de verdade, quase um PC da Nasa, mas a chave é tua
Quem depende de cibersegurança avançada:
O Astra é o primeiro modelo da OpenAI classificado no nível Critical de capacidade em cibersegurança dentro do Preparedness Framework, com capacidades cyber sensíveis liberadas por acesso confiável
Se esse é o teu caso de uso, a fila é essa mesmo, e ela é curta por design
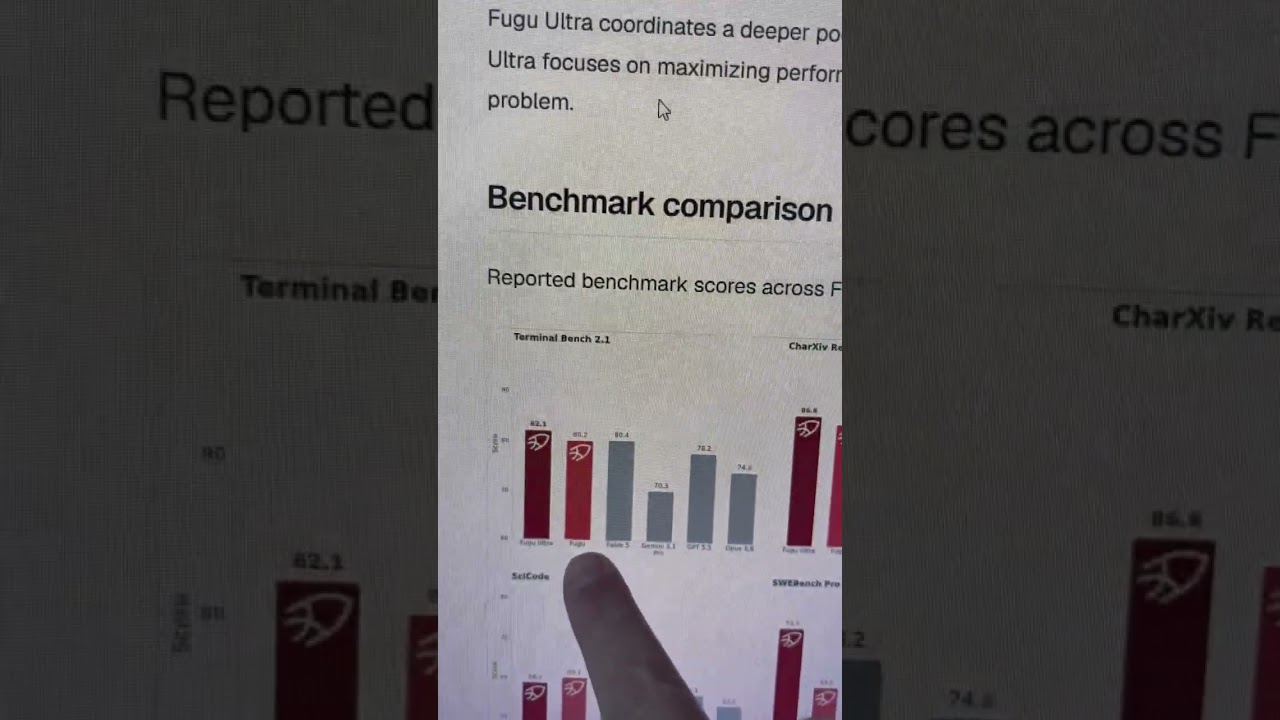
Vídeo: rodar vários modelos ao mesmo tempo
Uma coisa que costuma sumir nesse debate: escolher um modelo não precisa ser exclusivo
Dá pra combinar, e este vídeo do canal apresenta o Sakana Fugu, uma IA que usa vários modelos ao mesmo tempo:
Veredito: quando o preço deixa de ser o argumento
Vou ser direto
Na semana do lançamento, o fator decisivo contra o GPT-6 Astra não era qualidade, era acesso: em 04/09/2026 o modelo continuava restrito, com compensação em resets acumulados por dia de espera para ChatGPT Work e Codex e uma expectativa de fim de semana que o próprio Altman disse não poder prometer. Isso já mudou em parte: o rollout terminou, e o Astra está disponível na API da OpenAI, no Microsoft Foundry, no Amazon Bedrock (GA desde 08/09/2026) e no GitHub Copilot; no ChatGPT, porém, o acesso segue desigual entre planos, com o Plus restrito a Work e Codex e o chat comum ainda rodando GPT-5.6 Sol, enquanto Pro e Business Premium recebem o modelo no chat como "GPT-6 Pro"
O fator decisivo contra os modelos chineses também não é qualidade: é onde o dado mora e, no caso do DeepSeek, como o modelo se comporta em tema sensível: o estudo da PNAS Nexus mediu recusa de 30% a 60% em BaiChuan, ChatGLM, Ernie Bot e DeepSeek, mas não testou Qwen nem Kimi, então esse número não pode ser estendido a eles sem dado próprio
E tem um terceiro ponto que quase ninguém coloca na balança: o custo técnico de migrar é baixo nos dois sentidos, porque os três provedores chineses citados expõem endpoint compatível com a API da OpenAI
Isso enfraquece bastante o discurso de lock-in
Para time corporativo com exigência de residência e política de dados escrita, a OpenAI segue mais fácil de defender, mesmo com o Brasil fora da lista de regiões
Para quem precisa de infra própria, modificação do modelo ou controle total, pesos abertos sob MIT resolvem o que API nenhuma resolve
Para quem quer só testar, testa: é troca de chave, base URL e nome do modelo
A parte que era mais incerta na semana do lançamento já se resolveu em boa medida: a disponibilidade ampla que a OpenAI havia anunciado se confirmou na API e nas plataformas de nuvem, mas dentro do próprio ChatGPT o acesso ficou fatiado por plano
Conclusão: como decidir sem apostar às cegas
Recapitulando o que o post levanta: acesso escalonado do Astra (hoje já resolvido na API e na nuvem, mas ainda desigual entre planos do ChatGPT), integração praticamente idêntica entre os provedores, residência e uso de dados como divisor real, pesos abertos como saída para infra própria e comportamento em temas sensíveis como requisito de produto: com a ressalva de que esse último dado, no estudo citado, cobre DeepSeek, mas não Qwen nem Kimi
O próximo passo é bem prático
- Monte um teste paralelo com o mesmo código, trocando só chave e base URL entre os endpoints compatíveis
- Liste as exigências de dados do teu projeto ANTES de olhar qualquer preço: onde o dado pode ficar, se pode ser retido, se precisa de retenção zero
- Se for usar o Astra, saiba que o rollout restrito já terminou na API e na nuvem, mas confira em qual plano do ChatGPT ele realmente aparece antes de prometer isso pra alguém: nem todo lançamento futuro vem com acesso imediato ou uniforme, então confirme a disponibilidade atual antes de fechar prazo em cima de um modelo recém-anunciado
E vale lembrar que preço é só um dos números que enganam nessa escolha: contexto de 1M de tokens é outro critério que parece detalhe e muda o projeto inteiro
Agora me conta: no teu projeto, o que pesa mais? Acesso, onde o dado mora ou liberdade pra rodar em casa?
Comenta aí que eu quero ver como tá a decisão de vocês, até o próximo post!
Perguntas frequentes
O GPT-6 Astra já está liberado na API da OpenAI?
Sim, na API. O rollout restrito que existia logo após o lançamento em 03/09/2026: quando o acesso ficava limitado a um pequeno grupo de organizações: já terminou, e hoje o modelo está disponível na API da OpenAI, no Microsoft Foundry, no Amazon Bedrock (disponibilidade geral desde 08/09/2026) e no GitHub Copilot. No ChatGPT o acesso é desigual: no plano Plus, o Astra aparece só no ChatGPT Work e no Codex, não no chat comum; Pro e Business Premium recebem o modelo no chat como "GPT-6 Pro", enquanto o chat padrão segue no GPT-5.6 Sol.
Dá para trocar DeepSeek, Qwen ou Kimi usando o mesmo código feito para a API da OpenAI?
Sim, os três oferecem endpoint compatível com o SDK da OpenAI. Basta apontar a base_url para https://api.deepseek.com (DeepSeek), https://dashscope-intl.aliyuncs.com/compatible-mode/v1 (Qwen) ou https://api.moonshot.ai/v1 (Kimi) e trocar a chave e o nome do modelo.
Os dados enviados para o GPT-6 Astra ficam armazenados no Brasil?
Não. O Brasil não está na lista de regiões com residência de dados da OpenAI para clientes corporativos, que inclui Europa, Reino Unido, EUA, Canadá, Japão, Coreia do Sul, Cingapura, Índia, Austrália e Emirados Árabes Unidos. Isso vale mesmo o Brasil estando entre os dez maiores mercados da OpenAI em clientes de negócios.
A DeepSeek armazena dados pessoais fora da China?
Não segundo a própria política de privacidade da empresa. Ela informa que coleta, processa e armazena dados pessoais na República Popular da China.
Modelos chineses recusam mais perguntas sobre temas politicamente sensíveis que modelos ocidentais?
Segundo estudo publicado na PNAS Nexus com nove modelos e 145 perguntas politicamente sensíveis, sim, para os modelos chineses testados. A taxa de recusa ficou entre 30% e 60% em BaiChuan, ChatGLM, Ernie Bot e DeepSeek, contra 0% a 3% em modelos ocidentais, com respostas também mais curtas e imprecisas. Qwen e Kimi não fizeram parte da amostra desse estudo, então esse número não pode ser atribuído a eles.
É possível rodar o DeepSeek em servidor próprio sem depender da API da empresa?
Sim, para o DeepSeek-V4-Pro. Os pesos estão publicados no Hugging Face sob licença MIT, o que permite uso comercial, modificação e execução em infraestrutura própria.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 27min




Blog | Mais populares
GPT-6 Astra ou Gemini: qual modelo usar para código no dia a dia?
GPT-6 Astra ou Gemini: qual escolher para código no dia a dia? Compare preço, limite de saída e casos de uso e veja o veredito sem enrolação.
Como usar o GPT-6 Astra para entender um repositório legado que ninguém documentou
O GPT-6 Astra promete entender repositórios legados sem documentação. Veja o passo a passo com 1 milhão de tokens de contexto e como validar cada resposta.
Streaming ou resposta completa no GPT-6 Astra: qual escolher na sua aplicação?
Streaming GPT-6 Astra ou resposta completa? Veja quando cada modo faz sentido, como funciona o modo background e por que o preço por token não muda.
