
Gemini 3.7 Flash em fluxos agentivos: por que latência e pensamento ajustável mudam o resultado?
O Gemini 3.7 Flash chegou em 13 de agosto de 2026, três semanas depois do 3.6 Flash e já em disponibilidade geral (GA), com o model ID gemini-3.7-flash na Gemini API. O ponto do post é o uso agentivo: o Google descreve o modelo como refinamento algorítmico sobre a base do 3.6, com 30,4% no AutomationBench contra 17,0% da versão anterior, e expõe o parâmetro thinking_level (LOW, MEDIUM padrão e HIGH). Como tokens de pensamento são cobrados como tokens de saída, em cadeia longa a escolha do nível mexe direto na latência e na conta
Fala aí, beleza? O Google soltou em 13 de agosto de 2026 o Gemini 3.7 Flash, e o recorte que interessa aqui não é a manchete: é o que muda quando esse modelo roda dentro de um agente, disparando chamada atrás de chamada
O lançamento veio três semanas depois do 3.6 Flash, e o modelo novo já chega em disponibilidade geral (GA), ou seja, liberado pra produção e não em preview
E ele veio com duas coisas que pesam muito em fluxo agentivo: pensamento ajustável por parâmetro e um preço promocional de entrada
O que o Google lançou no Gemini 3.7 Flash
O model card descreve o 3.7 Flash como melhoria algorítmica sobre a base de raciocínio da versão 3.6 Flash, e não como um novo pré-treino
Ou seja: é refinamento, não modelo do zero

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 114 aulas
- 4 projetos
- 9h 18min
Os ganhos citados ficam concentrados em três frentes: engenharia de software, trabalho com documentos e desenvolvimento web
O modelo é nativamente multimodal e aceita texto, imagens, áudio e vídeo de entrada
A janela é de 1 milhão de tokens de contexto, com até 64 mil tokens de saída
A suíte de ferramentas embutidas é a MESMA do 3.6 Flash, então quem já tinha algo montado não precisa reaprender o ferramental
E o posicionamento oficial é bem direto: o Google apresenta o 3.7 Flash como o modelo mais inteligente dele pra código e agentes, otimizado pra orquestração multi-etapa, refatoração de código e raciocínio geral, com mais esforço em planejamento multi-etapa e chamadas de ferramenta
Onde ele já está disponível:
- Gemini API, via Google AI Studio e Android Studio
- Google Antigravity
- Gemini Enterprise Agent Platform e app Gemini Enterprise
- app Gemini, em rollout no Spark, exigindo assinatura AI Pro ou Ultra
O identificador na API é gemini-3.7-flash
Gemini 3.7 Flash x Gemini 3.6 Flash: o que mudou na prática
| Item | 3.7 Flash | 3.6 Flash |
|---|---|---|
| AutomationBench | 30,4% | 17,0% |
| Preço no lançamento (Gemini API) | US$ 0,75 por 1M de entrada e US$ 3,75 por 1M de saída, promocional até 31/12/2026 | preço de lançamento usado como referência do corte de 50% |
| Controle de pensamento | thinking_level, enum de string no generation_config |
thinking_budget, o parâmetro legado que foi substituído |
| Origem do modelo | refinamento algorítmico sobre a base de raciocínio do 3.6 | base de raciocínio de referência |
| Ferramentas embutidas | mesma suíte | mesma suíte |
Leitura rápida: de todos esses números, o AutomationBench é o que mais fala com quem monta agente, porque ele mede fluxos de trabalho reais de negócio, e não uma pergunta isolada
Sair de 17,0% pra 30,4% em tarefa de fluxo é um salto que aparece justamente no cenário onde o modelo precisa encadear passos sem se perder no meio
Por que um agente faz dezenas de chamadas em cadeia
Aqui vale explicar o PORQUÊ antes do como
Um agente não responde de uma vez só: ele planeja, chama uma ferramenta, lê o retorno, decide o próximo passo, chama de novo, e por aí vai
Cada um desses passos é uma chamada nova ao modelo
Então latência e custo por chamada não ficam sozinhos: eles se MULTIPLICAM pelo número de etapas
E tem o efeito colateral clássico: um erro no meio da cadeia não morre ali, ele contamina todos os passos seguintes, porque o agente continua raciocinando em cima de uma conclusão errada
Se você já montou fluxos n8n com GPT-4o e Gemini, já viu esse filme: o nó 3 quebra e os nós 4 a 10 entregam bobagem com toda a confiança do mundo 😅
E como o modelo mantém o fio da meada?
É aí que entram as thought signatures
Elas preservam o estado de raciocínio em conversas multi-turno e multi-etapa
No generateContent elas vêm como metadado anexado a partes, inclusive dentro de partes functionCall
Traduzindo: o raciocínio não se perde toda vez que o agente para pra chamar uma ferramenta e volta
Sobre velocidade, a página viva do Artificial Analysis mede a variante 3.7 Flash (high) na API do Google assim: índice de inteligência 56 contra mediana 34 da faixa de preço, velocidade de saída de 340,1 tokens por segundo contra mediana 67,8, e tempo até o primeiro token de 9,83s contra mediana 2,86s
Tome cuidado com essa leitura: são medições de terceiro, em página que muda, e cobrem a variante high
Repara no contraste: a saída é bem mais rápida que a mediana, mas o primeiro token demora mais que a mediana
Em cadeia longa, esse tempo até o primeiro token é justamente o que se paga várias vezes
thinking_level: como LOW, MEDIUM e HIGH mudam o resultado do agente
O thinking_level é um enum de string que fica no generation_config, no lugar do legado thinking_budget
Ele aceita três valores: LOW, MEDIUM (padrão) e HIGH
{
  "model": "gemini-3.7-flash",
  "generation_config": {
    "thinking_level": "MEDIUM"
  }
}
O erro comum aqui: MINIMAL NÃO é suportado no 3.7 Flash e retorna erro de validação da API
Se você veio de outro setup e tentou copiar esse valor, a chamada quebra na validação, não no meio da geração
O que o Google diz de cada nível:
- LOW: reduz o tempo até a resposta em tarefas sensíveis a latência
- MEDIUM: é o padrão e o recomendado pra código complexo e casos agentivos
- HIGH: maximiza raciocínio e uso de ferramentas nas tarefas mais difíceis, com maior consumo de tokens e custo
E o custo disso?
Essa é a parte que muita gente descobre tarde
Os tokens de pensamento são cobrados como tokens de SAÍDA na Gemini API
Ou seja, o preço da resposta com pensamento ativo é a soma dos tokens de saída com os tokens de pensamento
A boa notícia é que dá pra medir antes de escalar: a API devolve thoughts_token_count por chamada, e o acumulado aparece em total_thought_tokens
Então o teste honesto é rodar o mesmo fluxo em LOW, MEDIUM e HIGH e comparar esse campo, em vez de escolher o nível no feeling
Quando usar cada nível de pensamento no seu fluxo
Traduzindo os níveis pros cenários que o próprio Google cita:
LOW pra pipelines de resposta a incidente, chat em tempo real, rascunhos e análise rápida de dados
É o cenário onde o usuário (ou o alerta) está esperando, e cada segundo a mais dói
MEDIUM pra código complexo e orquestração agentiva
Como é o padrão e o recomendado justamente pro caso agentivo, ele é o ponto de partida natural: comece aqui e só mexa com dado na mão
HIGH pras tarefas mais difíceis, com planejamento multi-etapa pesado e muita chamada de ferramenta
Só lembre do combo: HIGH maximiza raciocínio e uso de ferramentas, mas com maior consumo de tokens e custo
E agora junta as duas pontas do post: nível mais alto dentro de uma cadeia de dezenas de passos multiplica tokens de pensamento em CADA passo
Por isso a conta não é "quanto custa uma chamada", é "quanto custa a cadeia inteira"
Mede com thoughts_token_count num fluxo real seu antes de fixar o nível, beleza? 🙂
O que já vimos na prática usando o Gemini no dia a dia
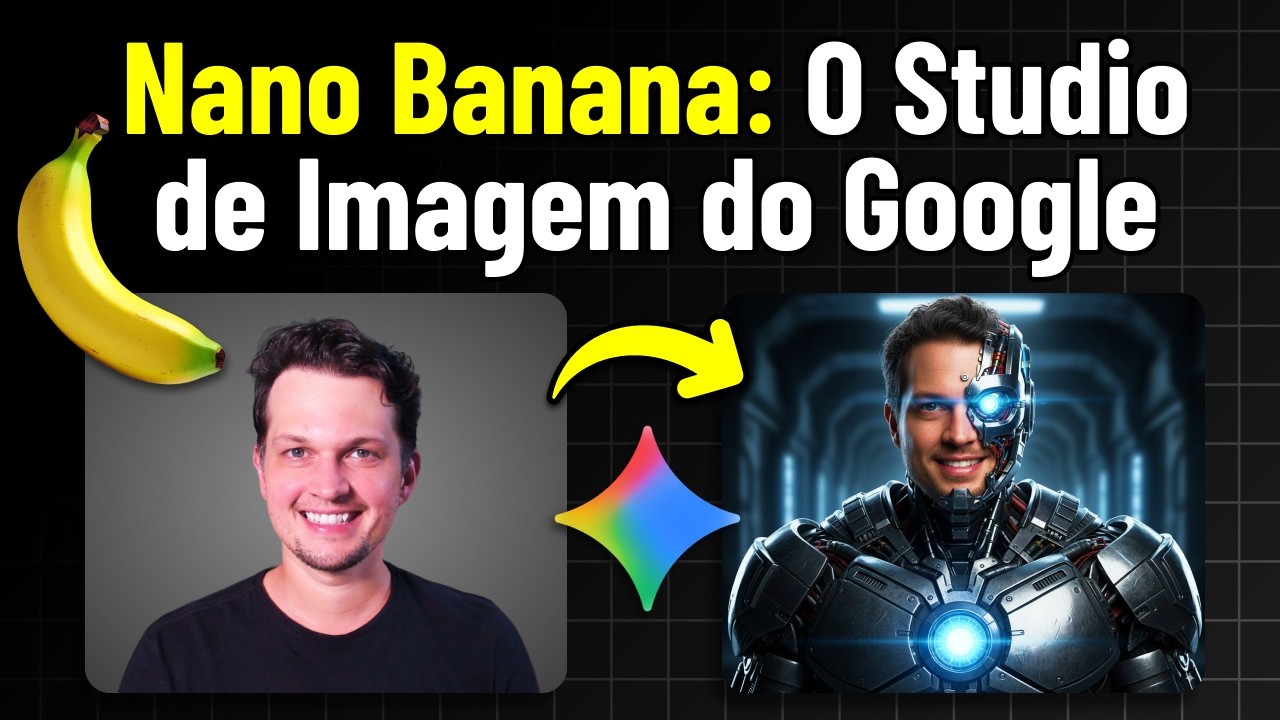
O material de primeira mão que eu tenho é de outro recorte, o Gemini Flash Image, o tal do Nano Banana, que eu mostrei em vídeo
Lá eu acessei o Google AI Studio pelo navegador, abri o modelo de imagem (dá pra chegar nele pelo atalho visível ou pela lista de modelos), pedi uma pessoa olhando o próprio reflexo em uma bolha de água, com pedido explícito de imagem realista, e a imagem saiu
O ponto aproveitável pra este post é outro: depois de gerar VÁRIAS imagens seguidas na mesma conversa, o consumo do limite de tokens mostrado na tela ficou em cerca de 10%
Ou seja, eu só descobri que o limite era generoso porque o número estava ali, visível, enquanto eu usava
É exatamente esse hábito que vira obrigatório em fluxo agentivo: acompanhar consumo de token deixa de ser detalhe de curioso quando o fluxo é longo e repetitivo, e é pra isso que o thoughts_token_count existe
Veja no vídeo
Pra começar do zero no ecossistema Gemini, este vídeo do canal mostra o modelo de imagem do Google dentro do AI Studio: como chegar na tela, onde escolher o modelo, o primeiro prompt rodando e como o limite de uso aparece enquanto você gera
Conclusão
Recapitulando sem hype: o Gemini 3.7 Flash é refinamento algorítmico sobre a base do 3.6 Flash, não um modelo novo em folha, e já chega em disponibilidade geral (GA)
O número que sustenta a conversa agentiva é o AutomationBench, 30,4% contra 17,0% da versão anterior, porque ele mede fluxo de trabalho real, que é o que o agente faz o dia inteiro
Mas quem decide mesmo é o SEU fluxo, com as suas ferramentas e o seu número de etapas
Próximo passo concreto: testa o model ID gemini-3.7-flash na Gemini API ainda dentro da janela promocional, que vale até 31/12/2026 com US$ 0,75 por 1M de entrada e US$ 3,75 por 1M de saída
A partir de 1º de janeiro de 2027 passa a valer US$ 1,50 por 1M de entrada e US$ 7,50 por 1M de saída, então dá pra usar essa janela como laboratório
Começa no MEDIUM, roda a mesma cadeia em LOW e HIGH e compara o thoughts_token_count dos três
Aí sim você escolhe o nível com dado, não com achismo 😀
até o próximo post!
Perguntas frequentes
O que é o thinking_level no Gemini 3.7 Flash e quais valores ele aceita?
É um parâmetro em enum de string, definido no generation_config, que substitui o antigo thinking_budget. Ele aceita três valores: LOW, MEDIUM (padrão) e HIGH, cada um ajustando o quanto o modelo raciocina antes de responder.
Por que o valor MINIMAL dá erro no thinking_level do 3.7 Flash?
Porque esse valor simplesmente não é suportado nessa versão do modelo, e a API retorna erro de validação assim que recebe a chamada. Quem migrou um setup de outro modelo esperando MINIMAL precisa trocar para LOW, que é o nível mais rápido disponível aqui.
Como são cobrados os tokens de pensamento na Gemini API?
Os tokens de pensamento entram na conta como tokens de saída, então o preço final da resposta é a soma dos tokens de saída com os tokens de pensamento. A API devolve esse gasto no campo thoughts_token_count por chamada, com o acumulado em total_thought_tokens.
Qual é o preço do Gemini 3.7 Flash na Gemini API?
No lançamento, o preço promocional é de US$ 0,75 por 1M de tokens de entrada e US$ 3,75 por 1M de tokens de saída, válido até 31 de dezembro de 2026. A partir de 1º de janeiro de 2027 passa a valer US$ 1,50 por 1M de entrada e US$ 7,50 por 1M de saída.
Qual thinking_level usar em fluxo agentivo?
O próprio Google recomenda MEDIUM, que já é o padrão, para código complexo e casos agentivos. HIGH fica reservado pras tarefas mais difíceis, quando vale pagar mais tokens por mais raciocínio e uso de ferramentas, enquanto LOW serve pra reduzir latência em cenários como chat em tempo real.
Onde o Gemini 3.7 Flash já está disponível?
Ele roda na Gemini API (via Google AI Studio e Android Studio), no Google Antigravity, na Gemini Enterprise Agent Platform e no app Gemini Enterprise. No app Gemini, está em rollout no Spark, exigindo assinatura AI Pro ou Ultra.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 27min




Blog | Mais populares
Gemini Pro vale a pena para estudante? O que muda de verdade na rotina de estudo
Gemini Pro estudante: veja o preço atual do Google AI Pro, o que muda na rotina de estudo e se vale migrar do plano gratuito para universitários em 2026.
Gemini e NotebookLM: qual a relação entre as duas ferramentas de IA do Google?
Gemini e NotebookLM viraram uma dupla: em julho/2026 o Google renomeou o NotebookLM para Gemini Notebook. Veja a diferença e quando usar cada um.
Como excluir sua conta do Gemini e o que acontece com seus dados
Como excluir conta Gemini: apague só o histórico ou encerre a Conta Google inteira. Saiba exatamente o que acontece com seus dados antes de decidir.
