
Inkling 2 Mini: o que é o modelo local em loop da Thinking Machines
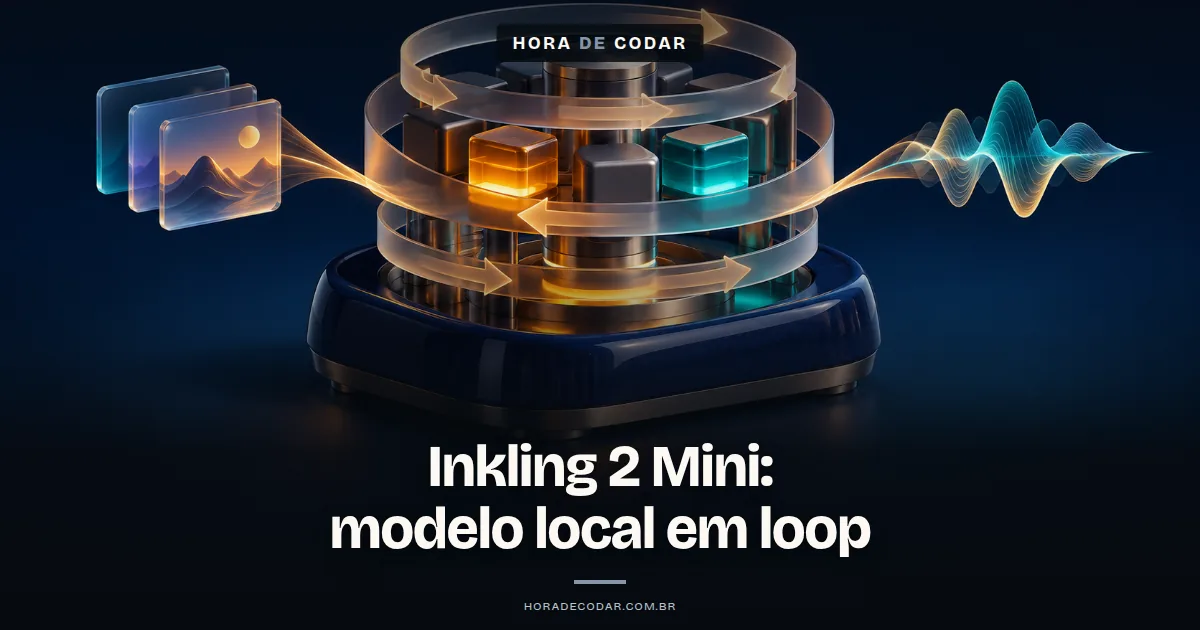
O Inkling 2 Mini é o modelo de pesos abertos (Apache 2.0) da Thinking Machines Lab feito para rodar localmente: um MoE multimodal de 26,4B parâmetros no total, cerca de 3B ativos por token, entrada de texto e imagem e contexto de 1M de tokens. Em relação ao Inkling 2 Small, ele é bem menor (o Small tem 594B no total e 17B ativos) e usa um núcleo de camadas que roda em loop três vezes com os mesmos pesos. No lançamento, roda em Mac com 32GB ou mais de RAM via Ollama, no NVIDIA DGX Spark, no Transformers, no llama.cpp (Llama App), no MLX, no SGLang e no Tinker.
Em 20/11/2026, a Thinking Machines Lab lançou o Inkling 2 Mini, um modelo de pesos abertos pensado para rodar localmente, inclusive em laptops. Os pesos estão no Hugging Face sob licença Apache 2.0, e o modelo aceita texto e imagem na entrada, com contexto de até 1M de tokens.
O limite prático aparece logo de cara: no lançamento, a Thinking Machines indica rodar em qualquer Mac com pelo menos 32GB de RAM via Ollama ou no NVIDIA DGX Spark. Se a sua máquina está abaixo disso, o caminho verificado é outro, e ele aparece mais abaixo.
Como funciona a arquitetura em loop do Inkling 2 Mini
O modelo tem 24 camadas físicas de decoder, mas as 12 do meio rodam três vezes. Segundo o blog da Hugging Face, as camadas 0 a 5 rodam uma vez, as camadas 6 a 17 rodam três vezes com os mesmos pesos e as camadas 18 a 23 rodam uma vez.

Black Week do Nexus
A formação de IA mais completa do Brasil
- 7 formações · 112 cursos · 26 mil alunos
A conta fica 6 + 3×12 + 6, o que dá 48 visitas lógicas por token com apenas 24 camadas guardadas no checkpoint.
E como uma passagem conversa com a outra? Cada passagem pelo núcleo em loop parte da mesma entrada, que é a saída das 6 primeiras camadas. A informação entre as passagens vai por mensagens cross-pass, e um pequeno controlador com gate decide quanto esquecer da entrada atual e quanto somar da mensagem. Na prática, cada passagem refina o que a anterior calculou.
Se liga na consequência: reaproveitar os pesos reduz o que fica armazenado, mas não reduz a computação. O modelo continua executando as 48 visitas, e cada uma mantém seu próprio estado de KV.
Na atenção, cada bloco de seis camadas tem cinco camadas de janela deslizante (até 1.024 tokens) e uma de atenção completa, com 24 query heads e 8 KV heads. No MoE, o roteador escolhe 8 entre 128 experts por camada para cada token.
Quantos parâmetros ativos o Inkling 2 Mini tem de verdade
Depende de quem conta e de como conta. O total físico é 26,4B segundo o model card (a Hugging Face arredonda para cerca de 26B), mas o número de ativos muda conforme a fonte:
- Model card: 3,4B ativos.
- Blog da Hugging Face: cerca de 3B ativos.
- Artificial Analysis: 5,4B ativos se contar as três passagens no loop, com 3,1B pesos únicos por token de texto.
A divergência vem justamente do loop. Contando só os pesos usados por token, cada fonte chega a um valor um pouco diferente: 3,4B no model card, cerca de 3B no blog da HF e 3,1B pesos únicos por token de texto na Artificial Analysis. Contando cada repetição do núcleo como computação ativa, como faz a Artificial Analysis, ele sobe para 5,4B.

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →Inkling 2 Mini vs Inkling 2 Small: o que muda
As duas variantes fazem 48 visitas por token e mandam cada token para 8 experts. A diferença está no tamanho de tudo ao redor disso.
| Item | Mini | Small |
|---|---|---|
| Parâmetros totais | 26,4B | 594B |
| Parâmetros ativos | 3,4B a 5,4B, conforme a fonte | 17B |
| Experts por camada | 128 | 384 |
| Hidden size | 2.304 | 4.608 |
| Experts por token | 8 | 8 |
| Visitas por token | 48 | 48 |
Os dados do Small vêm da documentação do NVIDIA NeMo AutoModel, e os do Mini do blog da HF e do model card. Segundo a Thinking Machines no X, o Mini foi uma resposta a quem achou o Small grande demais.
Precisão NVFP4 e MXFP8 e o drafter DSpark
O checkpoint é único, com cerca de 20GB, em precisão mista: 20 camadas em NVFP4 e 4 em MXFP8. Segundo o model card, é a mesma precisão usada no treino.
O pacote também traz um drafter DSpark, que acelera a geração em troca de um pequeno custo extra de memória. A Hugging Face não publicou, no post de lançamento, números de ganho de velocidade, então vale medir no seu próprio hardware.
Desempenho: o que a Hugging Face diz até agora
Por enquanto, o que existe é impressão inicial e dado de anúncio. Nos vibe tests da equipe da Hugging Face (testes informais), o modelo é pelo menos comparável ao Qwen 3.8 27B, e a própria HF diz que falta validar mais.
No anúncio, a HF afirma que, contra Gemma 4 31B, Muse Glimmer, Qwen3.8-27B e Nemotron 3.5 Super VL, o modelo lidera em 32 de 48 benchmarks. Em código, lidera no FrontierCode v2.0, empata com o Qwen3.8-27B no Terminal-Bench 4.0 e fica atrás do Qwen no AutomationBench-AA v1.0.6.
Esses números são da HF e do model card no dia do lançamento, não de teste feito aqui.

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Em quais ferramentas já dá para rodar o Inkling 2 Mini
O acesso confirmado no lançamento é este:
- Ollama: em Mac com 32GB ou mais de RAM, segundo a Thinking Machines.
- NVIDIA DGX Spark.
- Transformers, llama.cpp (via Llama App) e MLX: suporte anunciado pela Hugging Face.
- SGLang: suporte desde o primeiro dia, voltado a deploy em produção em hardware de datacenter.
- Tinker e Tinker Playground: inferência e fine-tuning, segundo a Thinking Machines no X.
No Transformers, o exemplo publicado pela HF carrega o modelo com AutoProcessor e AutoModelForMultimodalLM, usando o ID thinkingmachines/Inkling-2-Mini:
import torch
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "thinkingmachines/Inkling-2-Mini"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id)

messages = [{"role": "user", "content": [{"type": "text", "text": "Why is the sky blue?"}]}]
inputs = processor.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=True,
    return_dict=True,
    return_tensors="pt",
).to(model.device)

input_len = inputs["input_ids"].shape[-1]
outputs = model.generate(**inputs, max_new_tokens=1024)
print(processor.decode(outputs[0][input_len:], skip_special_tokens=False))
Os comandos exatos para Ollama, llama.cpp e MLX (tag, arquivo, flags) não estavam confirmados no momento do lançamento. Confira a página do modelo de cada ferramenta antes de rodar.
A variante de pesquisa com loop variável
Junto com o modelo principal saiu o TML-d24-varloop-research. Ele tem a mesma arquitetura, mas foi treinado para aceitar 1, 2 ou 3 passagens no loop.
Com 1 ou 2 passagens, a inferência fica bem mais rápida, com qualidade possivelmente um pouco menor. A HF diz que testou e que funciona, mas que não avaliou a fundo. Ele tem suporte no Transformers, mas o parâmetro exato para escolher o número de passagens não estava confirmado no momento do lançamento, então confira a documentação antes de usar.
Vale testar o modelo no seu setup?
Se você tem um Mac com 32GB ou mais ou um DGX Spark, comece pela ferramenta que já usa no dia a dia entre as suportadas e coloque o modelo lado a lado com o seu modelo local atual nas suas próprias tarefas. Os números de desempenho ainda são do anúncio, então o que vale é o resultado no seu fluxo.
Abaixo desse hardware, a via verificada é o Tinker Playground. Para os detalhes completos, os pontos de partida são o post da Hugging Face e o model card.
Perguntas frequentes
Posso usar o Inkling 2 Mini em projeto comercial?
Os pesos são distribuídos sob licença Apache 2.0 no Hugging Face, que é uma licença permissiva e costuma liberar uso comercial. Vale confirmar os termos direto na página do modelo antes de colocar em produção.
Fontes consultadas
Consulta em .
- Introducing Inkling 2 Mini (Thinking Machines Lab) e post @thinkymachines no X
- Blog da Hugging Face
- Model card thinkingmachines/Inkling-2-Mini
- Model card (HF), blog da HF e artigo da Artificial Analysis
- NVIDIA NeMo AutoModel, Inkling 2 Small
- Thinking Machines (@thinkymachines) no X
- Thinking Machines (@thinkymachines) no X
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
Como Recuperar Conversas Apagadas no ChatGPT: É Possível?
Conversas excluídas do ChatGPT não podem ser recuperadas pela interface ou pelo suporte. Se a conversa foi arquivada, você pode desarquivá-la. Se apenas sumiu da […]
ChatGPT não funciona: saiba como corrigir erros
ChatGPT não funciona? O ChatGPT pode deixar de funcionar por diversos motivos, e a maioria deles está relacionada a problemas de conexão, cache ou instabilidade […]
Como limpar histórico do ChatGPT e proteger sua privacidade
Veja como limpar o histórico do ChatGPT e proteger sua privacidade de forma simples e eficaz, mantendo seus dados seguros online. Para apagar uma conversa […]
