
Model Integration Contracts: a proposta da Hugging Face para pegar bugs do Transformers antes do merge
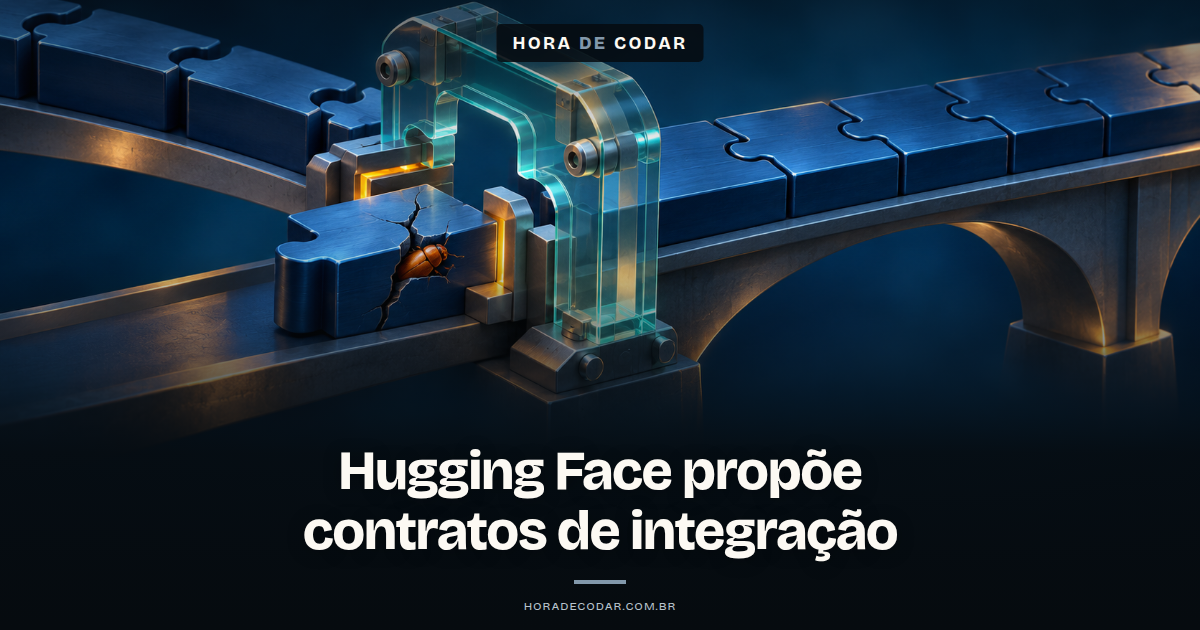
Fala aí, beleza? A Hugging Face publicou em 3 de novembro de 2026, no blog oficial, o transformers-mic: uma proposta de padrão pra empacotar os testes de integração do Transformers usando modelos reduzidos que rodam numa CPU barata. Segundo a Hugging Face, até 1º de novembro de 2026 esse job de MIC no CI do Transformers reportava falhas sem bloquear PRs; se vai passar a bloquear os merges depende de medições que a equipe ainda não fez
O post é assinado por Tarek Ziadé e nasceu de um bug real: o decoder do UMT5 ficou na main de 30 de julho a 28 de setembro de 2026 sem gerar nenhum crash 😀
O que aconteceu com o UMT5 e por que o bug passou dois meses na main
Em 30 de julho de 2026 o Transformers habilitou o SDPA (scaled dot-product attention) do PyTorch para o T5
Como efeito colateral, o decoder do UMT5 passou a enxergar tokens futuros
Traduzindo: durante o treino o modelo podia espiar a resposta que ele deveria prever, tipo fazer a prova com o gabarito do lado haha

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
Nada quebrou, nada deu erro, e a correção só entrou em 28 de setembro
Mas por que um bug desses passa batido?
A causa é de escala, segundo a Hugging Face: o Transformers suporta mais de 750 tipos de modelo, tem mais de 88.000 testes de CPU na main e mais de 200.000 testes de GPU numa execução diária
Rodar a integração completa em todo PR exigiria GPUs ocupadas o dia inteiro, o que não é prático
Aí a execução agendada até encontra a regressão… só que quando ela já está na main
O que é um Model Integration Contract (MIC)
Um Model Integration Contract é um pacote de teste com três partes, rodado contra um modelo encolhido em CPU:
- fixture: o modelo reduzido, feito a partir da configuração do checkpoint real, publicado uma vez e fixado
- usage path: um exemplo executável em Markdown de algo que as pessoas realmente fazem com o modelo, como gerar texto ou rodar um passo de treino
- baselines: as saídas registradas ao rodar esse exemplo, revisadas por um humano
O critério é simples: o contrato vale se rodar o usage path na fixture ainda produz as baselines
Se a saída mudou, alguma coisa no código mudou junto, e alguém precisa olhar
Um detalhe importante: o contrato cobre uma arquitetura mais um usage path, não um checkpoint isolado
Checkpoints compatíveis podem compartilhar a mesma fixture, cada um com os seus resultados esperados
Os contratos ficam publicados na organização huggingface-mic no Hub
Exemplo: o contrato SmolLM
O contrato do SmolLM gera texto a partir de prompts como "The capital of France is" e compara os token IDs com a resposta registrada
O trecho de geração, simplificado pra um prompt só no post oficial, é este:

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →inputs = tokenizer("The capital of France is", return_tensors="pt")
outputs = model.generate(**inputs, max_new_tokens=4, do_sample=False)
new_tokens = outputs[:, inputs["input_ids"].shape[1]:]
print(tokenizer.batch_decode(new_tokens, skip_special_tokens=True))E não para no texto gerado: o contrato também compara a loss de treino, checa se os gradientes são finitos e verifica se um passo do otimizador realmente altera os pesos
Há um usage.md completo descrevendo esse fluxo no repositório do contrato
Como os contratos pegaram a regressão do UMT5
A prova que a Hugging Face apresenta é um replay: ela rodou MICs congelados sobre cinco meses de commits do Transformers
A pequena fixture do UMT5 sinalizou a regressão em todos os commits, desde a introdução em 30 de julho até a correção em 28 de setembro
Separadamente, num estudo de custo em CPU, a fixture experimental do UMT5 usava 66 MB de pesos, contra 1.227 MB do checkpoint de origem: o que ajuda a explicar por que esse tipo de teste cabe num runner barato
As diferenças contra a baseline revisada foram de 1,22 nas log-probabilidades dos labels e de cerca de 0,20 na loss de treino
Se liga no detalhe que fez TODA a diferença: o contrato usava SDPA, que é o caminho de atenção padrão
Rodar só a variante eager de atenção não pegava o bug!
Ou seja, a fixture só ajuda se passar pelo mesmo código que o checkpoint real passa
Depois disso, a equipe reverteu a correção numa branch de prova no CI do Transformers
A checagem falhou com as mesmas diferenças, e o passo do runner do contrato T5 levou 13,4 segundos em CPU, sem contar o setup
Como a Hugging Face encolhe um modelo sem perder o que importa
Encolher não é só diminuir as dimensões e cortar camadas, principalmente em arquiteturas mistas
Manter duas camadas não serve pra nada se as duas usam sliding attention e as de full attention somem do modelo 😛
Por isso a receita tem quatro etapas, cada uma com uma decisão clara:
- Encolher a configuração mantendo os tipos de camada: partindo de um checkpoint real, reduz hidden sizes, cabeças de atenção e profundidade, mas preserva as misturas (sliding e full attention, dense e MoE). Pra larguras que a regra genérica não conhece pelo nome, aproveita os tamanhos que o
ModelTesteremtest_modeling_<model>.pyjá escolhe à mão - Manter o pré-processamento intacto: vocabulário, tokens especiais e dimensões de entrada ficam iguais, e os arquivos de tokenizer e processor são copiados byte a byte, porque carregar e pré-processar também faz parte do que se quer testar
- Construir e validar os pesos: tenta pesos aleatórios com seed e, se o modelo não reagir a entradas diferentes, treina no pequeno lote do contrato. Builds com saídas, loss ou gradientes não finitos são rejeitados
- Congelar e registrar: salva os pesos aceitos e mede saídas repetíveis num build do Transformers conhecido como bom, revisando as baselines por plataforma e precisão

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.A lógica por trás é: o modelo pode ficar minúsculo, mas o CAMINHO que o código percorre precisa ser o mesmo do modelo grande
Como os contratos entram no CI de cada PR
Hoje, na prática, a Hugging Face escolhe os MICs de um PR com base nos arquivos que o patch altera
Segundo a Hugging Face, até 1º de novembro de 2026 esse job no CI do Transformers reportava falhas sem bloquear PRs, enquanto a equipe decide com medições se vale travar o merge por aí
Ou seja, mexeu no T5? A seleção puxa o contrato que passa pelo T5, como aconteceu na branch de prova citada acima
Pra garantir reprodução, um dataset fleet no Hub fixa cada MIC numa revisão congelada, junto com as versões dos pacotes usadas pra registrar as baselines
E cada execução de CI registra qual revisão do fleet usou, então dá pra reproduzir aquele resultado depois
O que muda para quem mantém ou integra modelos no Transformers
Modelinhos de teste não são novidade: o Transformers já tem os checkpoints tiny-random-*
A diferença do MIC é ter uma receita comum e checagens que vão além de carregar o modelo e rodar um forward pass
E isso pesa, porque o bug do UMT5 teria passado tranquilo num forward pass
Outro ganho: modelos grandes demais pros runners de GPU padrão podem ser cobertos via fixture em CPU, sem precisar de PC da Nasa no CI haha
Agora os limites, que precisam ficar claros:
- é uma proposta de padrão: até 1º de novembro de 2026, segundo a Hugging Face, o job reportava falhas no CI do Transformers, mas ainda não bloqueava PRs
- segundo a própria Hugging Face, as fixtures não substituem os testes de integração completos, elas complementam nos PRs
E tem uma lição que serve pra qualquer projeto, com ou sem Transformers: teste pelo mesmo caminho de código padrão que o usuário real vai usar
O caso eager versus SDPA mostra bem isso, o teste estava lá, só não passava por onde o bug morava…
Vídeo complementar do canal
Se você quer ver outro lançamento recente em ação, no canal tem um vídeo sobre o lançamento e os testes do Kimi K3, usando o Kimi Code
Próximo passo: comece pelos contratos já publicados
Abre a organização huggingface-mic no Hub e procura o contrato SmolLM
Lê o usage.md dele com calma: é ali que dá pra ver como o usage path, as baselines e as checagens de treino se encaixam na prática
Entendendo esse formato, fica muito mais fácil pensar em qual usage path faria sentido pra arquitetura que você mantém, e em qual caminho de código padrão ele precisa passar
Até o próximo post!
Quer aprender mais sobre inteligência artificial e programação na prática? Conheça o canal Hora de Codar no YouTube e acompanhe os próximos vídeos.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação A popularidade da automação de processos com o n8n está em alta, principalmente […]
O que significa “ChatGPT network error” e como resolver
Network error indica falha de comunicação, mas não identifica sozinho a causa. Confira o status do ChatGPT, teste uma nova conversa e uma janela sem […]

Como usar o Antigravity do Google: guia completo do zero ao primeiro app
Aprenda neste guia prático como usar o Antigravity do Google: descubra a instalação, configuração, criação de projetos com o Agent Manager e o primeiro deploy, […]
