
Repositório inteiro ou um recorte: quanto contexto entregar ao Gemini 4 Carbon numa tarefa longa?
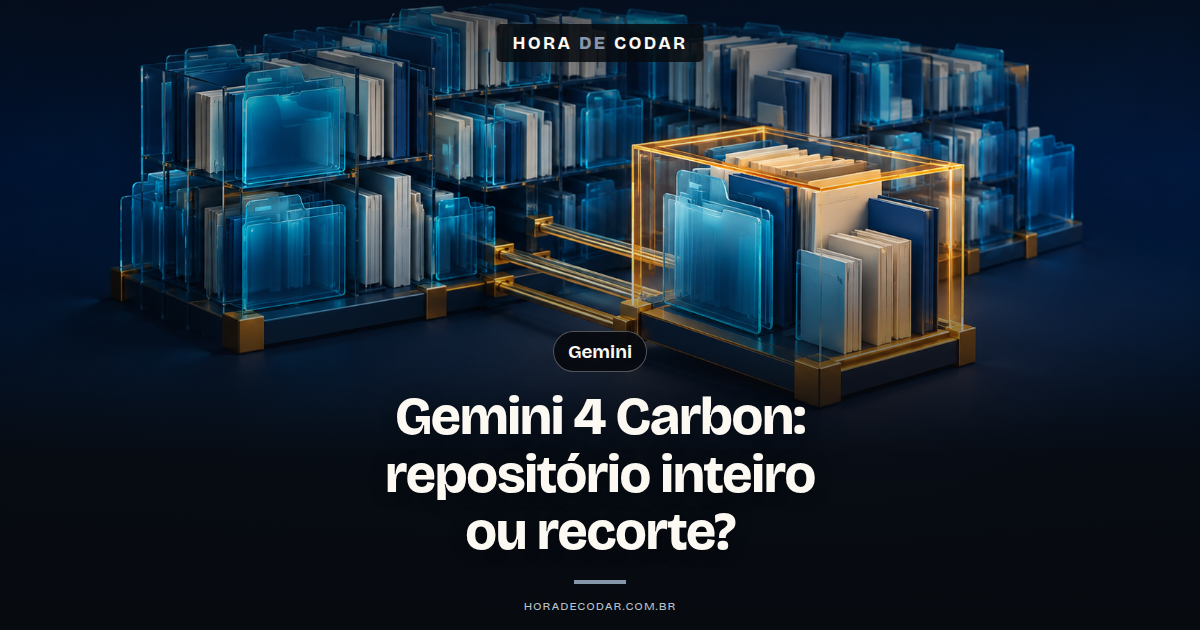
Fala aí, beleza? Se a dúvida é quanto contexto entregar ao Gemini 4 Carbon numa tarefa longa, a resposta curta é: na maioria dos casos, comece por um recorte (o módulo ou o fluxo afetado) e só abra o repositório inteiro quando o problema atravessa módulos e a causa raiz é desconhecida, mesmo com a janela de contexto de 1 milhão de tokens à disposição
Contexto rápido: o modelo foi anunciado pelo Google em 28/10/2026 e hoje o acesso é restrito ao Fairwind Program
Ele ainda não está no app Gemini, no AI Mode da Busca nem na Gemini API pública, e a liberação ampla não tem data
Repositório inteiro x recorte por módulo: o que muda em cada critério
O recorte ganha em custo, em revisão e em controle do que foi alterado
O repositório inteiro ganha quando a causa raiz pode estar em qualquer lugar
| Critério | Repositório inteiro | Recorte por módulo |
|---|---|---|
| Custo por execução | Mais tokens de entrada a cada rodada, a US$ 2 por 1M no preço introdutório (US$ 4 depois, sem data para a mudança) | Menos tokens de entrada, com a mesma tabela de preço aplicada a um volume menor |
| Custo de saída | US$ 10 por 1M tokens (US$ 20 depois), cobrado sobre o que o modelo gera | Mesmo preço de saída, sobre o que o modelo gera |
| Facilidade de revisar o resultado | Mais difícil: a mudança pode aparecer em qualquer arquivo do projeto | Mais fácil: o diff fica dentro do módulo combinado |
| Risco de alterações fora do alvo | Maior, porque o projeto todo está ao alcance | Menor, porque o alvo foi delimitado antes de começar |
| Achar causa raiz que cruza módulos | Ponto forte: as conexões entre módulos estão no contexto | Ponto fraco: a causa pode estar fora do recorte |
| Reaproveitamento de contexto | Contexto grande repetido entre rodadas pode usar o desconto de 95% dos tokens de entrada em cache | Também pode usar o cache, mas o volume de entrada já é menor |
Os preços são os divulgados pelo Google no lançamento
Repara que eu não coloquei quantos tokens um repositório "típico" ocupa: isso varia demais de projeto pra projeto e chutar número aqui seria zoado

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
Quando recortar por módulo: critérios práticos
Recorte quando a tarefa cabe numa fronteira que você consegue nomear
Se você responde "sim" pra maioria destes pontos, o recorte é o caminho:
- A tarefa tem fronteira clara: um serviço, um pacote, uma feature
- O bug é reproduzível dentro do módulo: você consegue disparar o problema sem depender do resto do sistema
- Existem testes locais pra validar: a suíte do módulo diz se a correção funcionou
- A revisão humana precisa caber num diff legível: alguém vai ler linha por linha antes do merge
Como montar o recorte?
A ideia é entregar o módulo-alvo MAIS aquilo de que ele depende pra fazer sentido
Ou seja: o código do módulo, as interfaces que ele consome, os contratos que ele expõe (tipos, schemas, assinaturas de API interna) e os testes dele
Pensa assim: é como passar pra um dev novo só a pasta do serviço e a documentação das APIs que ele chama, em vez de jogar a empresa inteira no colo dele haha
Tome cuidado com o recorte apertado demais! Se você tira um contrato que o módulo usa, o modelo pode "adivinhar" o formato e errar com toda a confiança do mundo…

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →Quando faz sentido abrir o projeto todo
Abra o repositório inteiro quando você não sabe onde o problema nasce
Os cenários em que o contexto amplo compensa:
- Bug sutil sem causa conhecida: o sintoma aparece num lugar, mas a origem pode estar em qualquer canto
- Comportamento que nasce na interação entre módulos: cada parte isolada funciona, o problema só aparece quando elas conversam
- Auditoria de segurança transversal: uma vulnerabilidade pode depender de como dados passam por várias camadas
É exatamente o tipo de trabalho que o Google diz ter mirado
Segundo o anúncio, o Carbon foi feito para fluxos agênticos sustentados e problemas de engenharia de longo horizonte, e equipes internas o viram rodar por dias, contornando becos sem saída, em tarefas como achar a causa raiz e corrigir bugs sutis em codebases grandes
Vale o detalhe: é uma declaração do Google baseada em uso interno, não uma medição independente
Se tu quiser entender melhor esse tipo de pedido, tem um post aqui sobre tarefas de longo horizonte que ajuda a montar a base
Outro indicador divulgado é o benchmark de contexto longo GraphWalks: 96,2% para o Gemini 4 Carbon contra 71,8% do GPT-6 Astra, segundo a MarkTechPost
Massa, mas se liga: benchmark mostra capacidade num teste específico, não garante como o modelo vai se sair no SEU repositório
Não existe medição pública comparando a qualidade do Carbon com o contexto cheio versus contextos recortados, então essa decisão ainda é sua
Se quiser conhecer melhor o canal, tem um vídeo do Hora de Codar sobre o Gemini 4 Argon no Gemini CLI
Os riscos de entregar o repositório inteiro numa tarefa longa
O maior risco não é só o custo: é perder o controle do que foi mudado e por quê
Os riscos concretos:
- Custo de entrada repetido a cada execução: numa tarefa longa o contexto volta várias vezes, e isso soma; o desconto de 95% nos tokens de entrada em cache alivia, mas não zera
- Diffs espalhados por arquivos fora do alvo: com tudo ao alcance, o modelo pode "aproveitar" e mexer onde ninguém pediu
- Revisão mais lenta e menos confiável: diff grande cansa o revisor, e revisor cansado aprova coisa que não deveria
- Dificuldade de atribuir mudança a decisão: fica difícil saber qual alteração resolveu o problema e qual veio de carona
- Exposição de código sensível: você entrega mais código do que a tarefa exige, incluindo partes que talvez nem precisassem sair do seu controle

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Nada disso impede usar o contexto amplo
Só significa que ele cobra uma revisão mais rígida, e é aí que o escopo muda tudo…
Como o escopo escolhido muda a revisão do resultado
O escopo define o que o revisor precisa checar: com recorte, ele valida contra o módulo; com o repositório inteiro, ele valida contra o projeto todo
Revisando um recorte:
Aqui o trabalho é mais direto
O revisor confere se o diff ficou dentro do módulo combinado, se os contratos que o módulo expõe continuam iguais e se a suíte de testes do módulo passa
Um diff contido dá pra ler com calma, linha por linha
Revisando o repositório inteiro:
Aqui o revisor precisa olhar três coisas a mais:
- Efeitos colaterais: a correção quebrou algo em outro módulo?
- Mudanças fora do pedido: o que foi alterado sem relação com o problema?
- A cadeia de raciocínio até a causa raiz: o caminho que levou à correção faz sentido, ou o sintoma só foi escondido?
Pra esse último ponto, registrar o percurso da tarefa ajuda MUITO, e tem um post aqui sobre como montar uma trilha de auditoria da tarefa
Uma checagem verificável pros dois escopos
Isto é uma prática de revisão, não um resultado testado:
- Antes de começar, defina por escrito o que pode ser alterado (arquivos, pastas ou módulos permitidos). O erro comum aqui é deixar o limite implícito e só descobrir na revisão que cada pessoa imaginava um escopo diferente
- Quando o resultado chegar, compare o diff contra esse limite. Tudo que estiver fora vira uma pergunta: precisava mesmo?
- Rode a suíte do módulo (no recorte) ou a suíte do projeto (no repositório inteiro). O erro comum é rodar só os testes do módulo depois de uma tarefa com o projeto todo aberto, e deixar passar o efeito colateral
Simples, né? Mas é isso que separa revisão de verdade de "parece que funcionou" 😛
Veredito: qual escopo usar no Gemini 4 Carbon
Depende do perfil da tarefa, e não do tamanho da janela
- Tarefa delimitada com testes locais: recorte. Revisão rápida, diff contido, custo menor
- Causa raiz desconhecida ou problema transversal: repositório inteiro, com regra de revisão mais rígida (limite definido antes, diff comparado, suíte do projeto rodando)
- Orçamento sensível: recorte, ou contexto amplo reaproveitado entre rodadas pra aproveitar o desconto do cache de entrada
Sobre o contexto competitivo: no Artificial Analysis, o Carbon aparece em 1º no Intelligence Index v5 com 59 pontos, entre 77 modelos
Já no Coding Agent Index ele fica em 2º: 59 pontos com o Antigravity CLI, atrás do Claude Code com Claude Opus 5.5 (max), que tem 62
São páginas vivas, então esses números podem mudar
E ranking nenhum decide escopo: quem decide é a fronteira do problema e o quanto você consegue revisar com segurança
Próximo passo enquanto o acesso não abre
Use o tempo de espera pra deixar a decisão de escopo pronta
Mapeie hoje os módulos do seu projeto, as fronteiras entre eles (quem chama quem, quais contratos existem) e quais suítes de teste cobrem cada parte
Quando o acesso chegar, tu bate o olho no problema e já sabe se é recorte ou projeto todo
Quem pode pedir acesso agora? A inscrição é por formulário do Fairwind Program, com prioridade para governos, operadores de infraestrutura crítica e grandes plataformas de tecnologia, e laboratórios acadêmicos de benchmarking defensivo também podem se candidatar
Pra todo o resto, é aguardar a liberação ampla, que ainda não tem data
Até o próximo post! =)
Perguntas frequentes
O Gemini 4 Carbon aceita só texto como entrada?
Não, a janela de 1 milhão de tokens aceita entrada em texto, imagem, fala e vídeo, com saída em texto.
Quais benchmarks de cibersegurança o Google divulgou pro Carbon?
No lançamento, o Google divulgou 88,2% no SEC-bench Pro (detecção de vulnerabilidades), 54,8% no ExploitGym (exploração) e 71,0% no CWE-bench (correção).
Quer aprender mais sobre inteligência artificial e programação na prática? Conheça o canal Hora de Codar no YouTube e acompanhe os próximos vídeos.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
Gemini Pro vale a pena para estudante? O que muda de verdade na rotina de estudo
Gemini Pro estudante: veja o preço atual do Google AI Pro, o que muda na rotina de estudo e se vale migrar do plano gratuito para universitários em 2026.
Como excluir sua conta do Gemini e o que acontece com seus dados
Como excluir conta Gemini: apague só o histórico ou encerre a Conta Google inteira. Saiba exatamente o que acontece com seus dados antes de decidir.
Dá para criar vídeos grátis no Gemini? A verdade (e a pegadinha) em 2026
Gemini criar vídeos grátis exige assinatura paga. O Veo só roda no AI Plus, Pro ou Ultra. Veja a única exceção sem custo e como não cair na pegadinha.
