
Gemini 4 Carbon na resposta a incidentes: o que dá para delegar e onde o humano precisa aprovar
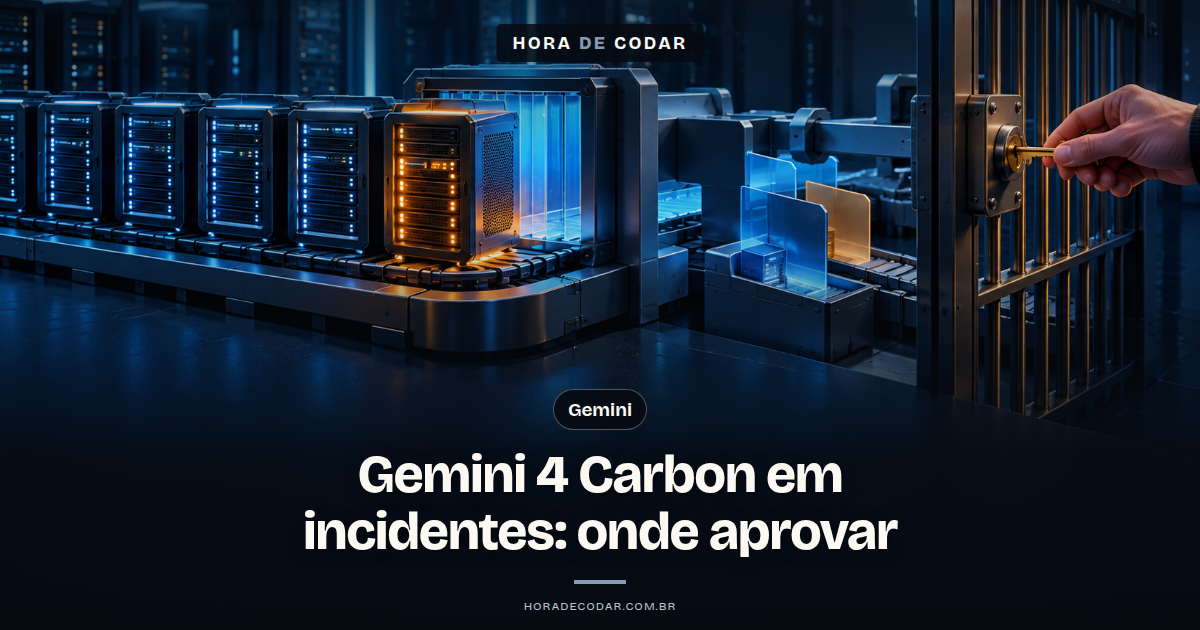
Dá pra delegar à IA a investigação (puxar dados do incidente, analisar correlações e ler logs), a escolha e a proposta de uma mitigação predefinida e o rascunho do postmortem. Qualquer mudança em produção precisa de confirmação humana explícita: no fluxo publicado pelo Google, o SRE revisa e aprova a mitigação antes do rollout. O modelo novo do Google ainda está restrito ao programa Fairwind e fora da Gemini API, então hoje o trabalho útil é desenhar esses portões de aprovação no seu runbook
Fala aí, beleza? O Google anunciou o Gemini 4 Carbon em 28/10/2026 como o seu novo modelo de fronteira, com foco declarado em cibersegurança e em fluxos agênticos longos, só que o acesso hoje está fechado no programa Fairwind
Então, pra separar o que dá pra entregar na mão da IA durante um incidente e o que precisa de um humano aprovando, a referência aqui é o fluxo que o próprio Google publicou usando Gemini 3 com Gemini CLI
Se liga: não existe relato público do Carbon rodando nesse fluxo, beleza? O mapa abaixo vale pra qualquer modelo que chegue no seu time

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min
O que é o Gemini 4 Carbon e quem pode usar hoje
O Carbon é o modelo que o Google apresenta como o mais forte da casa, feito pra cibersegurança, tarefas de longo horizonte e fluxos agênticos que podem rodar por dias em trabalhos de engenharia com várias etapas, segundo o anúncio oficial do Google
O acesso começa por um grupo de defensores de cibersegurança e parceiros de confiança do programa Fairwind, e o Google promete abrir pra desenvolvedores, empresas e consumidores ‘o mais rápido possível’, sem data, como relata a cobertura da VentureBeat
Hoje ele não está na Gemini API, não tem ID de modelo nem endpoint público e não tem data pra API, Vertex AI ou app Gemini, conforme o levantamento da MindStudio
E por que tanto cuidado? Porque achar e explorar vulnerabilidades serve tanto pra defesa quanto pra ataque (o famoso uso duplo), então o modelo passa primeiro por defensores e por testes do governo antes de ser liberado
Os números anunciados:
- Preço: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, com entrada em cache 95% mais barata (anúncio do Google)
- Contexto: janela de 1 milhão de tokens (anúncio do Google)
- Ranking: 1º lugar no Artificial Analysis Intelligence Index v5.0, com 59 pontos na versão High, contra 58 do Claude Opus 5.5 (Max)
- Segurança: SEC-bench Pro 88,2% (achar vulnerabilidades), ExploitGym 54,8% (exploração) e CWE-bench 71,0% (correção), números divulgados pelo Google

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →Como o Google estrutura um incidente com IA no circuito
O Google descreve um fluxo em que a IA é copiloto e o humano fica no circuito o tempo todo, do alerta ao postmortem
O detalhe importante: o relato dos SREs do Google Cloud usa o Gemini 3 com o Gemini CLI, NÃO o Carbon
As quatro etapas do incidente:
- Paging: o alerta dispara e alguém precisa reconhecer
- Mitigation: reduzir o impacto no cliente ANTES de entender a causa raiz
- Root Cause: investigar e corrigir o bug de origem
- Postmortem: documentar o que rolou e criar action items pros times
Por que MTTM e não MTTR?
No fluxo do Google a métrica principal é o MTTM (Mean Time to Mitigation), e não o MTTR, como detalha a reportagem da InfoQ
Faz sentido, né? O cliente sente o impacto, não a causa raiz
Primeiro tu estanca o sangramento, depois descobre de onde veio o corte 😛
E o reconhecimento do alerta tem SLO de 5 minutos, então a pressão começa logo no primeiro passo
O que dá para delegar à IA em cada etapa do incidente
No relato do Google, a IA assume o trabalho pesado de leitura e análise e chega até a sugerir a mitigação, mas não executa nada sozinha
Bora ver etapa por etapa?
Investigação:
- Puxar os dados do incidente
- Analisar causalidade e correlações de séries temporais
- Ler logs
É a parte mais braçal do incidente, e é onde a IA economiza MUITO tempo de quem está de plantão
Mitigação:
- Escolher uma mitigação predefinida, como o reinício de task (se você conhece Kubernetes, é parecido com reiniciar um pod)
- Apenas PROPOR a ação
Repara no verbo: propor
A execução depende de aprovação, e isso é intencional
Postmortem:
- Rascunho gerado automaticamente por um Custom Command do Gemini CLI, que junta timestamps, logs e ações
- Registro automatizado dos action items
Rascunho continua sendo rascunho, beleza? Vale a mesma lógica de testar a citação da IA: conferir se cada timestamp e cada ação batem com o que aconteceu de verdade antes de publicar o documento

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Os pontos de aprovação humana que não podem sair do fluxo
O Google deixa a IA ler quase tudo e escrever quase nada, e toda mudança em produção passa por confirmação humana explícita
São três portões, bora ver um por um?
Portão 1: o desenho de permissões
- Leitura ampla: registros do incidente, telemetria, logs, playbooks, histórico de mudanças e issues
- Escrita restrita: só mitigações predefinidas
Ou seja, o agente enxerga o cenário inteiro, mas o cardápio do que ele pode fazer é fechado
Nada de improvisar um comando em produção às 3 da manhã (os rm -rf da vida agradecem haha)
Portão 2: os controles de cada mitigação
Cada mitigação predefinida carrega:
- Metadados de risco
- Checagem de política
- Regras de reversibilidade
- Confirmação humana explícita antes de qualquer mudança em produção
Esse sistema roda num framework interno do Google chamado ProdAgent
Tome cuidado: é ferramenta interna, não é algo que tu instala e usa no seu time, o que vale copiar é o desenho
Portão 3: a aprovação da mitigação
Quando o Gemini sugere instruções de mitigação, o SRE precisa revisar e aprovar o código, submeter e aguardar o rollout automatizado
A IA propõe, o humano decide, a esteira aplica
O raciocínio por trás:
A IA derruba o MTTM onde o tempo é gasto de verdade: juntar dados, correlacionar e ler log
Já a decisão de mexer em produção continua com o humano, porque é ali que um erro vira um segundo incidente
O que o Carbon muda para o seu time agora
Se você não está no Fairwind, hoje nada muda na sua operação
Não tem API, não tem endpoint e não tem data de disponibilidade, então não dá pra plugar o Carbon em nenhuma ferramenta de incidente por enquanto
O que dá pra fazer já é desenhar o fluxo de permissões e aprovação usando a referência pública do Google, e isso não depende de modelo nenhum
E tem um recado no próprio lançamento: o Google segura o Carbon numa liberação escalonada justamente por causa do risco de uso duplo
Se quem criou o modelo trata a capacidade ofensiva com esse cuidado, manter portões humanos no seu fluxo é o mínimo, né?
Pra quem quer ir se familiarizando com a família Gemini 4 no terminal, esse vídeo do canal mostra o lançamento do Gemini 4 Argon no Gemini CLI com projetos pesados
Bora conferir? 🙂
Próximo passo: revise o seu runbook antes do modelo chegar
Abre o seu runbook e faz esse checklist, usando o desenho de leitura ampla e escrita restrita do Google como gabarito:
- Liste todas as ações de ESCRITA em produção que existem hoje (restart, rollback, mudança de config e por aí vai)
- Confirme que cada uma passa por confirmação humana explícita antes de rodar
- Confirme que cada uma tem regra de reversão documentada
- Separe o que é só leitura (logs, telemetria, playbooks, histórico de mudanças): é isso que um agente poderia acessar sem portão
O que sobrar sem aprovação ou sem reversão é o seu buraco, e ele existe com ou sem IA no circuito
E vale ficar de olho no anúncio oficial do Google pra saber quando o Carbon chegar na Gemini API
Até o próximo post!
Quer aprender mais sobre inteligência artificial e programação na prática? Conheça o canal Hora de Codar no YouTube e acompanhe os próximos vídeos.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 30min




Blog | Mais populares
Gemini Pro vale a pena para estudante? O que muda de verdade na rotina de estudo
Gemini Pro estudante: veja o preço atual do Google AI Pro, o que muda na rotina de estudo e se vale migrar do plano gratuito para universitários em 2026.
Como excluir sua conta do Gemini e o que acontece com seus dados
Como excluir conta Gemini: apague só o histórico ou encerre a Conta Google inteira. Saiba exatamente o que acontece com seus dados antes de decidir.
Dá para criar vídeos grátis no Gemini? A verdade (e a pegadinha) em 2026
Gemini criar vídeos grátis exige assinatura paga. O Veo só roda no AI Plus, Pro ou Ultra. Veja a única exceção sem custo e como não cair na pegadinha.
