Como usar o Jev para o chatbot decidir se pergunta mais ou já responde

O Jev é o modelo de decisão tipada da TypeSafe AI, lançado em 15 de setembro de 2026 como o primeiro System One model: ele não gera texto, recebe um estado mais perguntas tipadas e devolve escolha, score ou probabilidade. Pra um chatbot, isso resolve uma dúvida barata que hoje é paga caro: perguntar mais ou já responder? Você monta um Choice com as rotas, um Noul estreito do tipo "o pedido tem o identificador?" e um Score de completude, tudo numa chamada só, e transforma cada saída num caminho determinístico no código
Fala aí, beleza? Chatbot que responde rápido demais é pior que chatbot lento
O usuário manda "meu pedido não chegou" e o bot já dispara um textão genérico, sem saber qual pedido, sem saber se é atraso ou extravio, sem saber nada
A decisão ali é ridiculamente simples: falta informação essencial ou dá pra responder?
E hoje essa decisão bobinha é paga com um LLM caro, com prompt gigante, streaming, latência de segundos e uma resposta em texto livre que você ainda precisa parsear
É aí que entra o Jev, o modelo da TypeSafe AI apresentado como o primeiro de uma classe chamada System One models
Ele não gera texto livre
Ele recebe estado mais perguntas tipadas e devolve uma escolha, um score ou uma probabilidade
Ou seja: a decisão vira um valor, não um parágrafo pra você interpretar na unha 🙂
O que você precisa antes de começar
Antes de sair codando, se liga no que precisa estar na mesa:
- Uma chave de API da TypeSafe, que os clientes oficiais leem da variável de ambiente
TYPESAFE_API_KEY - Python 3.10 ou superior com
pip install typesafe-sdk(ouuv add typesafe-sdk), ou Node.js 20 ou mais novo comnpm install @typesafe-ai/sdk - Seu chatbot já existente, com o LLM caro que hoje faz tudo sozinho
Um aviso importante antes que você perca tempo: a TypeSafe abriu cadastro direto no console pra todo mundo em 20 de setembro de 2026, com US$ 5 de crédito, e pausou os novos cadastros em 22 de setembro por excesso de demanda
Contas existentes seguem funcionando e a empresa declarou que trabalha pra reabrir
Se você não tem conta, o Jev também é acessível por terceiros: está no Vercel AI Gateway, listado no OpenRouter e disponível na Cloudflare, onde o modelo é chamado como typesafe/jev com o mesmo schema de { state, questions } da API da TypeSafe
Ah, e os clientes oficiais chamam jev-latest por padrão
A versão publicada do modelo é a jev-1.13, e IDs versionados como jev-1.13.0 são aceitos no campo model mesmo quando não aparecem na listagem de GET /v1/models
Sobre custo: o preço listado é de US$ 0,042 por 1 milhão de tokens de entrada, com tokens de saída gratuitos
Compara isso mentalmente com o que seu LLM atual cobra só pra dizer "faltou o número do pedido" e você já entende o motivo deste post 😀

Domine o Jev e coloque decisões de IA dentro do seu sistema
Você vai aprender a usar o Jev, o System One Model da TypeSafe AI, pra automatizar decisões com resposta tipada e confiança medida, sem depender de chat nem de alguém revisando cada passo. Entre na lista de espera para garantir a condição de lançamento!
Passo a passo: montando a decisão de perguntar ou responder
Antes do código, o porquê
A lógica de domínio do Jev não vive em fine-tuning, a TypeSafe afirma que o modelo não é ajustado com dados de cliente: os mesmos pesos atendem todo mundo e as classes são definidas em linguagem natural no momento da chamada
Traduzindo: o seu trabalho é escrever bons critérios, não treinar nada
As primitivas de pergunta são três, e vale gravar a tabelinha:
| Primitiva | O que devolve | Limites |
|---|---|---|
| Noul | probabilidade de a resposta ser sim, entre 0 e 1 | sem campo de confiança separado |
| Choice | escolha entre opções, com probabilidades e confidence | até 255 opções, cada uma com critério descritivo |
| Score | nota por rubrica, com probabilidades e confidence | mínimo de 2 níveis, máximo de 10 |
Bora montar?
- Monte o state com a mensagem do usuário e um histórico curto
O state é o contexto contra o qual todas as perguntas são avaliadas
Pra decidir se falta informação, o bot precisa enxergar o que o usuário já disse antes, senão ele vai pedir de novo um dado que já foi entregue duas mensagens atrás
estado = f"""
Conversa de atendimento de e-commerce.

Histórico recente:
{historico_ultimas_mensagens}

Mensagem atual do usuário:
{mensagem}
"""
O erro comum deste passo: mandar só a última mensagem e depois reclamar que o bot é repetitivo
O outro erro é o oposto, jogar a conversa inteira lá dentro
O contexto do Jev é limitado: o orçamento de 64k cobre o estado somado a todas as perguntas, e o orçamento de 32k vale pro estado somado à pergunta mais longa
Histórico curto, sempre
- Desenhe o Choice de rota com um critério descritivo por opção
Essa é a pergunta principal: qual caminho essa mensagem toma?
O limite é de até 255 opções por Choice, mas não se empolga
Três ou quatro rotas resolvem a vida de um chatbot de atendimento, e cada opção extra é mais uma chance do modelo ficar em cima do muro
# client do SDK já inicializado, chave lida de TYPESAFE_API_KEY

rota = Choice(
    "Qual o próximo passo do atendimento para a mensagem atual?",
    options={
        "responder_direto": "A mensagem traz todos os dados necessários para responder agora",
        "pedir_dado_faltante": "O pedido é claro, mas falta um dado essencial (número do pedido, data, versão) para agir",
        "escalar_humano": "A mensagem envolve reclamação grave, cobrança indevida ou pedido fora do escopo do bot",
    },
)
O erro comum deste passo: opção com rótulo bonito e critério vazio
O nome da opção não ensina nada ao modelo, quem ensina é o critério
- Adicione um Noul estreito e checável
O cookbook oficial de cascata tem uma regra de desenho de verificador que vale ouro aqui: o sinal usado no portão precisa ser estreito e aterrado
Um sim/não checável sobre um campo específico contra a fonte, e não um vago "essa resposta está boa?"
tem_identificador = Noul(
    "A conversa contém um número de pedido no formato usado pela loja?"
)
A resposta de um Noul devolve a probabilidade de a resposta ser sim
E atenção: não existe campo de confiança separado nele, porque o próprio valor já é a certeza
0,5 significa indeciso, e ponta perto de 0 ou de 1 significa que o modelo está seguro
O erro comum deste passo: escrever "o usuário deu contexto suficiente?"
Isso é amplo, subjetivo e vai te devolver 0,5 eternamente
- Se fizer sentido, acrescente um Score de completude
Às vezes não é sim ou não, é "quanto falta"
O Score precisa de pelo menos dois níveis e a API aceita até 10
completude = Score(
    "Quão completo está o pedido do usuário para o atendimento agir?",
    levels={
        1: "Falta quase tudo, só há uma queixa genérica",
        2: "Há intenção clara, mas falta o identificador principal",
        3: "Há identificador, mas falta detalhe do problema",
        4: "Tudo que é necessário está presente",
    },
)
O erro comum deste passo: criar 10 níveis achando que granularidade fina é precisão
Níveis que você mesmo não consegue diferenciar em uma frase o modelo também não vai diferenciar
- Mande tudo na mesma chamada
Todas as perguntas de uma mesma requisição são avaliadas em paralelo e isoladas contra o mesmo estado
Então não tem motivo nenhum pra fazer três chamadas
resposta = client.system_one(
    state=estado,
    questions={
        "rota": rota,
        "tem_identificador": tem_identificador,
        "completude": completude,
    },
)
No SDK JavaScript a ideia é a mesma, com os helpers choice(), score() e noul() e a chamada client.systemOne({ state, questions }), lendo o resultado em response.answers
- Leia a saída e transforme cada opção em um caminho de código
Além de response.answers, o SDK Python expõe atalhos tipados: response.nouls, response.choices e response.scores
rota_escolhida = resposta.choices["rota"]

if rota_escolhida.value == "responder_direto":
    return responder_com_llm_caro(estado)

if rota_escolhida.value == "pedir_dado_faltante":
    return pergunta_pronta_do_template(resposta)

return abrir_ticket_humano(estado)
O erro comum deste passo: devolver a saída do Jev pro LLM e pedir pra ele "decidir o que fazer com isso"
Aí você pagou duas vezes e continuou com decisão imprevisível
A graça toda é que cada opção vira um if de verdade
Se você já usa esse tipo de decisão tipada em outras camadas, dá pra combinar com uma checagem de jailbreak antes do LLM responder na mesma requisição, já que perguntas rodam em paralelo
Como modelar as opções de saída para cada tipo de chatbot
Aqui mora o trabalho de verdade
O Choice é só a casca, o que faz ele funcionar é o critério de cada opção escrito como quem explica pra um colega novo no suporte
Suporte de e-commerce: o dado que trava tudo é o número do pedido
responder_politica: "A dúvida é sobre política de troca, prazo ou frete e não depende de um pedido específico"pedir_numero_pedido: "O usuário reclama de um pedido específico mas não informou o número dele em nenhuma mensagem"consultar_status: "O número do pedido já aparece na conversa e o usuário quer saber o andamento"
Agendamento: o dado que trava é a data ou a janela de horário
pedir_data: "O usuário quer marcar algo mas não indicou dia nem período"confirmar_slot: "Data e horário já estão claros e só falta confirmar"reagendar: "Existe um agendamento anterior mencionado na conversa e o usuário quer mudar"
Suporte técnico: o que trava é versão, sistema ou log
pedir_versao_ou_log: "O usuário relata um erro sem informar versão do app, sistema operacional ou mensagem de erro"erro_conhecido: "A mensagem de erro citada bate com um problema já catalogado"escalar_engenharia: "O relato indica falha de infraestrutura ou perda de dados"
Vendas: o que trava é entender se já dá pra qualificar
responder_duvida_produto: "Pergunta objetiva sobre funcionalidade, preço ou planos"pedir_contexto_uso: "Interesse genérico, sem tamanho de time, uso pretendido ou orçamento"encaminhar_comercial: "Já há sinal claro de intenção de compra e contexto suficiente"
Percebe o padrão? Cada opção descreve uma situação observável na conversa, não um sentimento
E cada uma precisa virar um branch determinístico no seu código, com template próprio de pergunta ou de resposta
Se a rota pedir_numero_pedido cai de volta num prompt solto tipo "pergunte o que falta", você trouxe a imprevisibilidade de volta pela porta dos fundos
Esse desenho de saída é exatamente o que separa automação dentro do software de chatbot genérico, e tem mais casos de uso de decisão dentro do produto que cabem no mesmo molde
Usando o confidence como portão antes de acionar o LLM caro
Decidir a rota é metade
A outra metade é saber quando não confiar na própria decisão
Respostas de Choice e de Score trazem um valor de confiança entre 0 e 1, derivado do formato da distribuição de probabilidades, além das probabilidades de cada opção ou nível
A documentação oficial tem dois padrões que se encaixam aqui como luva
O primeiro é o Intent routing: classificar a mensagem primeiro e rotear cada uma pro destino certo, seja código determinístico, LLM especialista ou humano, acionando os recursos caros só quando o pedido precisa
O segundo é o Confidence-gated routing: ações mais arriscadas exigem limiar de confiança mais alto, e os casos incertos são escalados pra uma pessoa ou pra um modelo de raciocínio mais caro
Na prática vira algo assim:
- Leia a confiança da rota escolhida
rota = resposta.choices["rota"]

if rota.confidence < LIMIAR_ROTA:
return escalar_para_llm_de_raciocinio(estado)- Use limiares diferentes por risco da ação
Responder uma dúvida de política é barato de errar
Cancelar um pedido não é
Então a mesma confiança que libera uma resposta informativa não deveria liberar uma ação destrutiva, os rm -rf da vida do atendimento 😛
- Interprete o Noul pelo valor, não por um confidence que não existe
tem_id = resposta.nouls["tem_identificador"]

if tem_id.value > 0.85:
    caminho_com_identificador()
elif tem_id.value < 0.15:
    pedir_identificador()
else:
    escalar_para_llm_de_raciocinio(estado)
O erro comum deste passo: procurar confidence no Noul
Não tem
O próprio valor já é a certeza, e 0,5 é o modelo dizendo "não dá pra saber com esse estado"
- Monte a cascata
O cookbook oficial de cascata mostra a ideia completa: um degrau barato resolve os casos fáceis e só os itens sinalizados pagam pelo modelo de raciocínio, usando um limiar de escalonamento configurável
É exatamente o desenho que você quer num chatbot de volume alto
Sobre qual número usar de limiar: a doc fala em gating por confiança mas não fixa um valor universal, então isso você calibra medindo no seu próprio tráfego
Não vou te vender número mágico que não existe
O que aprendi testando a mesma lógica de decisão com o Think do n8n
Seja honesto: antes de existir um modelo de decisão tipada, o jeito comum de dar "um passo de pensar" pro agente era a ferramenta de pensamento
E eu testei isso a fundo
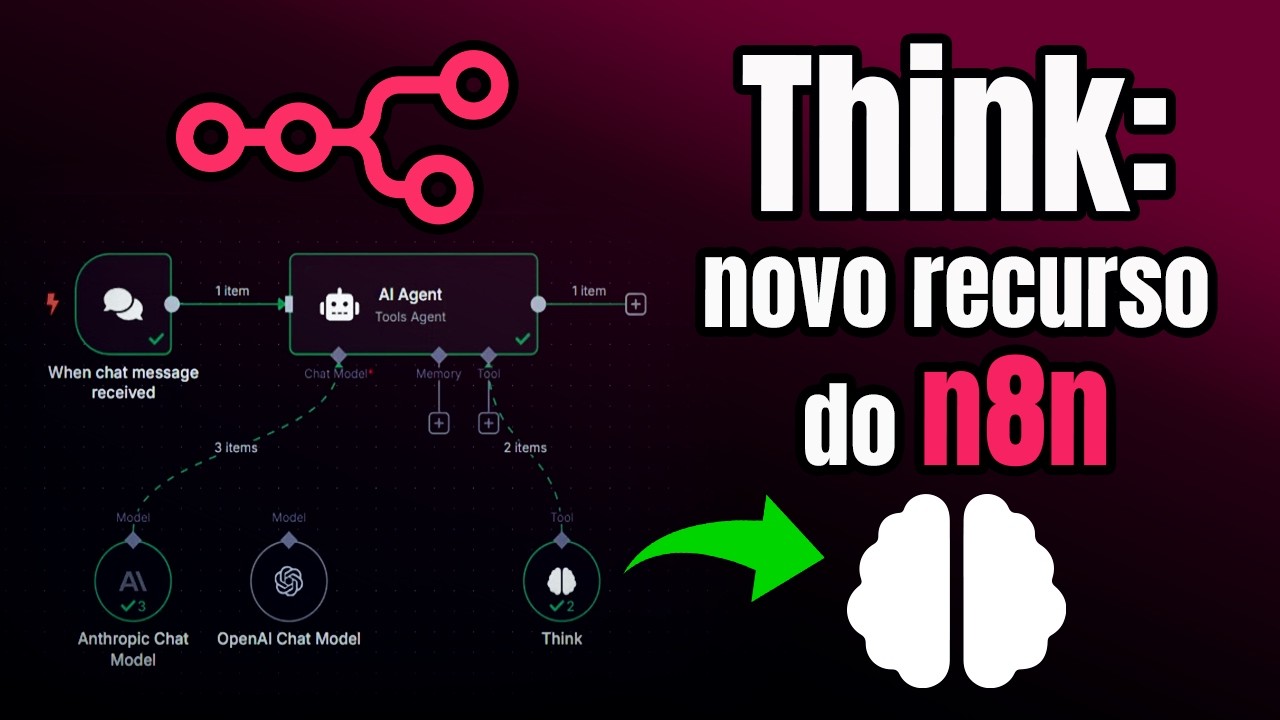
No vídeo abaixo eu monto um workflow no n8n com um trigger de chat ligado a um agente de IA, e destroço a ferramenta de pensamento com perguntas de dificuldade crescente pra ver quando ela é acionada
O agente ali tem três coisas configuráveis: o modelo de LLM, a memória de conversa e as tools
Primeiro teste, pergunta besta: quanto é 2+2
A ferramenta de pensamento não foi acionada
Beleza, faz sentido, não tem o que raciocinar
Aí preparei prompts propositalmente mais complexos: um problema de lógica sobre cores de camisetas e um problema matemático de um tanque vazando água
No problema de lógica com o modelo da Anthropic foram 3 chamadas ao modelo no total, sendo 2 delas à ferramenta de pensamento, e a resposta veio Alex de azul, Bruno de verde, Carlos de vermelho
No problema do tanque com o mesmo modelo foram 2 chamadas ao modelo e 1 à ferramenta de pensamento, com resultado de menos de 500 L após 12 horas
Aí troquei pro modelo da OpenAI no mesmo problema do tanque
A ferramenta de pensamento não foi acionada, e a resposta foi a mesma: menos de 500 L após 12 horas
E quando repeti a mesma pergunta trocando de modelo, em alguns casos as respostas vieram diferentes entre si, o que sugere variação de acerto dependendo do modelo
Dá pra ver o breakdown das ações do agente (consulta ao modelo, acionamento da ferramenta, nova consulta) e entender o caminho até a resposta
E aí aparece a conta: quanto mais a ferramenta de pensamento é acionada, mais vezes o agente consulta a API do modelo, e isso bate direto no custo
Minha recomendação lá continua valendo: teste modelos diferentes pra achar o equilíbrio entre precisão e custo
A ferramenta ainda aceita um parâmetro de descrição pra orientar como deve ser usada, mas como é um recurso novo, a maioria das pessoas mantém a configuração padrão
Agora o ponto que interessa pra este post
O acionamento fica a critério do LLM
Mesmo problema, modelo diferente, comportamento diferente
É uma decisão que você torce pra acontecer, não uma decisão que você controla
Um Choice do Jev devolve uma rota tipada sempre, com probabilidades e confidence, na mesma estrutura, toda vez
São coisas diferentes pra propósitos diferentes, mas se o que você precisa é de um portão previsível antes da geração, torcida não é arquitetura 😀
Economizando: agrupe todas as perguntas da decisão em uma chamada
Esse é o truque que muita gente descobre tarde
Todas as perguntas de uma mesma requisição rodam em paralelo e isoladas contra o mesmo state, e acrescentar perguntas quase não altera o tempo de resposta
O cookbook oficial de perguntas paralelas mostra o tamanho disso: agrupar 13 perguntas sobre um documento em uma única chamada saiu 12,2x mais barato e 10,0x mais rápido, sem mudança nas respostas
Então a decisão inteira do seu chatbot cabe numa requisição só:
resposta = client.system_one(
    state=estado,
    questions={
        "rota": rota,
        "tem_identificador": tem_identificador,
        "tem_data": Noul("A conversa informa uma data ou período desejado?"),
        "tem_descricao_problema": Noul("O usuário descreveu o que aconteceu, e não apenas que algo deu errado?"),
        "completude": completude,
    },
)

rota_escolhida = resposta.choices["rota"]
faltas = {k: v.value for k, v in resposta.nouls.items()}
Com isso você já sabe, de uma vez só: qual rota, o que exatamente está faltando e o quanto está faltando
E monta a pergunta de volta ao usuário citando só o campo ausente, sem aquele "poderia detalhar melhor?" que irrita todo mundo
O cuidado deste passo: orçamento de contexto
São 64k pro estado somado a todas as perguntas e 32k pro estado somado à pergunta mais longa
Se você empilhar perguntas gigantes com critérios enormes, o teto chega
Critério bom é específico, não comprido
Sobre velocidade: a latência ponta a ponta relatada pra consultas adequadas ao System One fica na faixa de 70 a 500 ms, em resposta de passada única e sem cadeia de raciocínio
A própria TypeSafe afirma que o modelo é muito mais rápido e barato que modelos de fronteira em tarefas do tipo System One, com números de até 193x mais rápido e 445x mais barato
Esse claim é da casa, então trate como claim, mas a ordem de grandeza combina com a ideia de rodar a decisão antes de cada mensagem sem medo
Problemas comuns quando o bot pergunta demais (ou de menos)
Sintoma: o bot pede um dado que o usuário já informou
Causa: o state só tem a mensagem atual, sem histórico
Solução: incluir as últimas mensagens no estado e adicionar um Noul do tipo "o número do pedido aparece em qualquer mensagem desta conversa?" em vez de "na mensagem atual"
Como prevenir: trate o state como a memória de curto prazo da decisão, não como a caixa de entrada
Sintoma: o bot responde sem contexto e erra feio
Causa: a rota responder_direto tem critério frouxo e vira o padrão pra qualquer coisa
Solução: reescrever o critério dessa opção listando o que precisa estar presente, e não o que ela significa
Como prevenir: casar a rota de resposta com um portão de confiança mais alto, porque errar respondendo custa mais que errar perguntando
Sintoma: o confidence vive baixo, quase tudo escala
Causa: opções que se sobrepõem
Se pedir_dado_faltante e escalar_humano descrevem situações parecidas, o modelo divide a probabilidade entre as duas e a confiança cai por construção, já que ela é derivada do formato da distribuição
Solução: fundir ou separar opções até cada uma virar um caso claramente distinto
Como prevenir: leia suas opções em voz alta e pergunte se um atendente humano saberia escolher só com aquele texto
Sintoma: a decisão oscila entre mensagens praticamente iguais
Causa: pergunta ampla demais
Aquela coisa vaga tipo "essa conversa está boa?"
Solução: aplicar a regra do cookbook de cascata, um sim/não checável sobre um campo específico contra a fonte
Como prevenir: toda pergunta do seu gate deveria ser respondível por uma pessoa olhando a conversa em 2 segundos
Sintoma: você quer "treinar o modelo no seu domínio" e não acha como
Causa: expectativa errada de fine-tuning
A TypeSafe afirma que não há ajuste por cliente: os mesmos pesos atendem todo mundo e a lógica de domínio vive nas instruções e critérios enviados na chamada
Solução: versionar seus critérios como se fossem código, porque é literalmente onde mora a regra de negócio
Como prevenir: guardar o texto dos critérios no repositório, com revisão, em vez de espalhar string solta no meio do handler
Conclusão
A ideia central é essa: separar decisão de geração
O LLM caro é ótimo pra escrever a resposta
Ele é um desperdício pra responder "falta o número do pedido, sim ou não?"
O Jev ocupa exatamente essa lacuna, devolvendo uma escolha tipada, com probabilidades e confidence, em vez de um texto que você tem que interpretar
Próximo passo, e faça no papel antes de abrir o editor: liste as rotas possíveis do seu chatbot, escreva o critério de cada uma como se estivesse treinando um atendente novo, e marque qual dado essencial trava cada rota
Só depois vira Choice, Noul e Score
E aí mede a coisa que importa de verdade: quantas conversas deixaram de chamar o LLM caro depois que o portão entrou
Se esse número não mexer, o problema está nos seus critérios, não no modelo 🙂
Testa aí e me conta como foi, até o próximo post!
Perguntas frequentes
Qual a diferença entre Noul, Choice e Score no Jev?
Noul devolve a probabilidade de a resposta ser sim, entre 0 e 1, sem campo de confiança separado. Choice escolhe entre até 255 opções, cada uma com critério descritivo, e traz confidence junto com a probabilidade de cada opção. Score dá uma nota por rubrica com no mínimo 2 e no máximo 10 níveis, também com confidence.
Quanto custa usar o Jev pra decisão de chatbot em produção?
O preço listado é de US$ 0,042 por 1 milhão de tokens de entrada, com tokens de saída gratuitos. Como as perguntas de uma mesma chamada rodam em paralelo contra o mesmo state, agrupar várias perguntas numa única requisição sai bem mais barato do que chamar o modelo várias vezes separadas.
Dá pra usar o Jev sem criar conta direto na TypeSafe?
Dá sim. O Jev também é acessível via Vercel AI Gateway, está listado no OpenRouter e disponível na Cloudflare, onde o modelo é chamado como typesafe/jev usando o mesmo schema de state e questions. Isso é útil justamente porque a TypeSafe pausou novos cadastros no console em 22 de setembro de 2026.
O Jev precisa de fine-tuning pra entender o domínio do meu chatbot?
Não. A TypeSafe afirma que o modelo não é ajustado com dados de cliente, os mesmos pesos atendem todo mundo. A lógica de domínio inteira vive nos critérios e nas instruções escritas em linguagem natural que você manda em cada chamada.
Quantas perguntas dá pra mandar numa única chamada do Jev?
O limite prático é o orçamento de contexto: 64k tokens cobrindo o estado somado a todas as perguntas, e 32k tokens cobrindo o estado somado à pergunta mais longa. Todas as perguntas de uma mesma requisição são avaliadas em paralelo e isoladas entre si contra o mesmo state, e adicionar mais perguntas quase não muda o tempo de resposta.
O Jev é rápido o suficiente pra decidir em tempo real se o bot pergunta ou responde?
Sim, esse é justamente o caso de uso pensado pra ele. A resposta é de passada única e sem cadeia de raciocínio, o que coloca a latência ponta a ponta relatada em outro patamar, bem diferente do streaming de segundos de um LLM de propósito geral.
Matheus Battisti
Formações
Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 45min
Blog | Mais populares

Como montar um workflow de automação combinando decisões do Jev em código
Aprenda a montar um workflow com Jev: decisões tipadas encadeadas em código, alta confiança agindo sozinha e casos incertos escalando para revisão.

Jev decide, LLM escreve: como dividir os papéis dentro de um agente de IA
Jev é o modelo que decide, não escreve: entenda como dividir papéis entre Jev e LLM dentro de um agente de IA e quando usar cada um.

Para quem o Jev serve (e para quem não serve)?
Jev serve pra roteamento, scoring e guardrails em IA, não pra texto ou código. Veja pra quem o Jev serve e quando evitar.