
Como usar o Hermes Agent gastando menos por tarefa
O custo do Hermes Agent por tarefa raramente sobe por um motivo só: é tarefa mal delimitada, contexto inflado e repetição somando no fim do mês. O caminho mais barato é medir antes de mexer (/usage, /insights, hermes insights), tirar as tarefas auxiliares do modelo caro em auxiliary.<task>.provider, calibrar a compressão de contexto, não quebrar o cache de prefixo trocando de modelo no meio da sessão e delegar pesquisa ampla a subagentes, que devolvem só o resumo. Nada disso exige assinatura: o Hermes Agent é open source sob licença MIT, mantido pela Nous Research
O gasto por execução não te avisa quando sobe
Ele sobe caladinho, dentro de uma sessão longa, num contexto que foi inflando, numa tarefa que você não delimitou direito e o agente resolveu explorar por conta própria
O Hermes Agent é open source sob licença MIT e é mantido pela Nous Research, com a versão estável mais recente na v0.20.1 (tag v2026.8.13)
E o recorte deste post é bem específico: reduzir o custo por tarefa SEM perder qualidade da resposta
Nada de cortar o modelo bom do chat principal e chorar depois porque a resposta ficou rasa 🙂
O que você precisa antes de começar
Pouca coisa, mas melhor deixar claro:
- Hermes Agent instalado na versão estável atual (v0.20.1, tag v2026.8.13)
- acesso a algum provedor de modelos
- familiaridade com
hermes config sete com os comandos de sessão (/usage,/compress,/new)
A assinatura é OPCIONAL, beleza? Você pode rodar com o provedor que já usa
Mas como o Nous Portal é a assinatura da Nous Research usada junto com o Hermes, vale deixar a tabela aqui pra você comparar:
| Plano | Preço | Crédito mensal | Teto de rollover |
|---|---|---|---|
| Free | US$ 0 | US$ 0 | não se aplica |
| Plus | US$ 20/mês | US$ 22 | US$ 10 |
| Super | US$ 100/mês | US$ 110 | US$ 50 |
| Ultra | US$ 200/mês | US$ 220 | US$ 100 |
O Free roda só modelos gratuitos e limites padrão
Os pagos incluem 10% de bônus em créditos, acesso a mais de 200 modelos e uso de ferramentas hospedadas
Passo a passo para gastar menos por tarefa no Hermes Agent
A ordem importa muito aqui: quem mexe na config antes de medir fica otimizando o lugar errado

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 45min
1. Meça antes de mexer:
O Hermes já te entrega o número, então usa
/usage
/insights
O /usage mostra o consumo com quebra por categoria (input x output), e essa quebra é a primeira pista: se o input está dominando, teu problema é contexto, não resposta longa
O /insights mostra o padrão de uso dos últimos 30 dias, e o hermes insights traz a analítica mais profunda
No painel tem a aba de Usage analytics, com cada modelo que rodou uma sessão, contagem de tokens, custo e badges de capacidade
E se você roda o Hermes em automação, o modo one-shot grava um relatório legível por máquina:
hermes -z "resumir os PRs abertos do repositório" --usage-file /tmp/usage.jsonO arquivo traz estimated_cost_usd, input_tokens, output_tokens, cache_read_tokens, cache_write_tokens, reasoning_tokens, total_tokens, api_calls, model, provider, session_id, service_tier e as flags de completed/failed
Detalhe massa: o relatório é escrito mesmo quando a execução falha
O erro comum deste passo: usar --usage-file fora do one-shot
A flag só tem efeito com -z/--oneshot, então em sessão interativa ela simplesmente não faz nada
2. Tire a tarefa auxiliar do modelo caro:
Esse aqui costuma ser o desperdício mais silencioso de todos
O Hermes usa modelos auxiliares pra tarefas paralelas ao chat principal: análise de imagem, sumarização de página web, análise de screenshot do navegador, geração de título de sessão e compressão de contexto
Só que o padrão é auxiliary.*.provider: "auto", que roteia tudo isso pro mesmo modelo que você escolheu em hermes model
Ou seja: você escolheu um modelo de raciocínio caro pro chat, e ele está gerando TÍTULO DE SESSÃO pra você
Dá pra forçar um modelo barato e rápido nesses slots, por tarefa:
hermes config set auxiliary.<task>.provider <provedor>
hermes config set auxiliary.<task>.model <modelo>
E dá pra atribuir um modelo aos 11 slots auxiliares de uma vez, o que é bem mais prático do que ir de um em um
O erro comum deste passo: achar que configurou e esquecer do fallback
Quando a rota auxiliar configurada falha, o modo auto segue uma cadeia: primeiro auxiliary.<task>.fallback_chain, depois os fallback_providers / fallback_model principais, e por último a cadeia interna de descoberta de auxiliares do Hermes
Se você não olhou pra essa cadeia, a tarefa auxiliar pode voltar pro modelo caro sem ninguém perceber
3. Calibre a compressão de contexto:
O Hermes comprime a conversa sozinho quando ela cresce
O compression.threshold vem em 0.50, ou seja, 50% do limite de contexto
Tem também o threshold_tokens opcional, um valor absoluto, e vale o MENOR entre a razão e o valor absoluto
E a compressão não joga fora tudo: ela preserva um trecho fixo e resume o miolo
target_ratio0.20: fração do limiar preservada como cauda recenteprotect_last_n20: mínimo de mensagens recentes intactasprotect_first_n3: mensagens de cabeça fixadas entre compactações
O limiar aceita override por modelo em compression.model_thresholds, aplicado por casamento da maior substring, com fallback pro limiar configurado
Existe ainda uma coisa SEPARADA disso tudo: uma rede de segurança secundária de higiene de sessão no gateway, que dispara em 85% da janela de contexto do modelo, independente do que você deixou no compression.threshold
Caso você use rota Codex OAuth com gpt-5.5, se liga nisso: aí é o SEU gatilho de compressão que sobe sozinho, o compression.threshold sai dos 0.50 padrão e vai pra 85% nessa rota
São dois mecanismos diferentes, beleza? Um é a rede do gateway, que continua lá do jeito dela, e o outro é o limiar da tua config sendo elevado automaticamente
Se você não quer esse comportamento:
hermes config set compression.codex_gpt55_autoraise falseO erro comum deste passo: apertar o limiar demais achando que é economia pura
Comprimir mais cedo significa comprimir mais vezes, e cada compressão é uma chamada de modelo também
4. Não quebre o cache de prefixo:
Esse é o ajuste que quase ninguém faz e que é praticamente de graça
Os provedores costumam cachear o prefixo da conversa (system prompt mais histórico)
Então system prompt estável, mesmos arquivos de contexto e mesma memória geram cache hits mais baratos nas mensagens seguintes da mesma sessão
E aqui vem a parte contraintuitiva: trocar de modelo no meio da sessão RESETA o cache de prompt
Em provedor com cache de prefixo (Anthropic, OpenAI), a troca repaga o custo total de input
Em sessão longa, costuma sair mais barato abrir uma sessão nova no outro modelo do que ficar alternando ida e volta
Pra facilitar, dá pra criar apelidos curtos e trocar com um comando:
/model <alias>O /model funciona no CLI e em qualquer plataforma de mensagem, e aceita tanto o formato canônico (com provider e base_url) quanto a string curta
O erro comum deste passo: usar o /model como se fosse um botão de zapear
É tentador, é rápido, e é justamente por isso que ele vira ralo de dinheiro em sessão comprida
5. Enxugue o contexto e separe as tarefas:
Muita sessão cara é só uma sessão que virou três assuntos diferentes
/compress
/new payments-refactor
O /compress resume o histórico na hora que VOCÊ quiser, sem esperar o limiar
O /new abre sessão nova e aceita nome, o que ajuda demais quando você tem várias frentes no mesmo projeto
Depois disso, olha o que entra sozinho na conversa
O Hermes injeta .hermes.md, AGENTS.md, CLAUDE.md, SOUL.md global e .cursorrules
O AGENTS.md do diretório de trabalho entra no system prompt logo no início da sessão
Já os de subdiretórios são descobertos progressivamente durante as chamadas de ferramenta, e entram no resultado da ferramenta em vez do system prompt
A memória persistente também: ela não tem ação de leitura, o conteúdo é injetado no system prompt no início da sessão
Ou seja, tudo que você deixou escrito lá está sendo pago em TODA sessão
O erro comum deste passo: transformar a memória em manual
A própria documentação separa os papéis: memória guarda fatos (ambiente, preferências, onde ficam os projetos) e skill guarda procedimento (fluxo de vários passos, receita reutilizável)
Memória é o "o quê", skill é o "como", e misturar os dois é duplicar contexto pago
6. Delegue a subagentes o que não precisa do histórico:
A ferramenta delegate_task cria agentes filhos com conversa nova e contexto isolado
O filho NÃO conhece o histórico do pai, ele recebe apenas os campos goal e context
E, na volta, só o resumo final entra no contexto do pai: as chamadas de ferramenta intermediárias não entram
É como mandar alguém ler 40 arquivos e te trazer meia página
Os limites padrão: 3 subagentes concorrentes (configurável) e delegation.max_iterations 50 por subagente
O erro comum deste passo: achar que o teto do pai segura tudo
O total de iterações somando pai e filhos PODE passar do teto do pai, então delegação sem objetivo claro multiplica gasto em vez de cortar
7. Feche as bordas:
Aqui são os ajustes menores que, juntos, aparecem na conta
- Skills seguem divulgação progressiva: o
skills_list()carrega uma lista compacta de todas as skills (cerca de 3 mil tokens) no início da sessão, oskill_view(name)carrega o SKILL.md completo só quando o agente decide que precisa, eskill_view(name, file_path)puxa um arquivo de referência específico sob demanda - Tool Search é uma camada opt-in que adia os schemas de ferramentas MCP e de plugins, trocando elas por três ferramentas ponte:
tool_search,tool_describeetool_call - Orçamento de iterações padrão de 500 turnos, e o
max_turnslimita quantos turnos de continuação uma goal pode gerar antes do Hermes pausar sozinho e pedir/goal resume - Mixture of Agents: o
reference_max_tokensvem SEM valor por padrão, ou seja, advisor sem cap escrevendo conselho quilométrico. Definir esse valor num preset limita a saída, e os slots de referência e agregação aceitamreasoning_effortcom none, minimal, low, medium, high, xhigh, max e ultra - Skill que delega ao Claude Code CLI: o teto de custo ali é
--max-budget-usd, uma flag daquele CLI e não dohermes, com mínimo de cerca de US$ 0,05 por conta da criação do cache do system prompt
Sobre o Tool Search, um aviso honesto: parte da economia volta em tempo de execução
Você troca um custo fixo por turno (os três schemas ponte mais a listagem do catálogo) e ao menos uma ida e volta extra em ferramenta fria pela economia nos schemas adiados
E não há benefício de cache nos schemas adiados, embora o resultado de um tool_describe entre no histórico e passe a ser cacheado nos turnos seguintes
Já o teto de iterações é o seu freio contra objetivo mal definido, que é o irmão gêmeo do gasto sem fim: vale combinar esse ajuste com o que dá pra fazer pra conter o estrago de um erro antes dele acontecer
Na prática: rodando modelo gratuito no Hermes Agent
Tem um caminho de economia que não é config nenhuma: usar modelo que não cobra
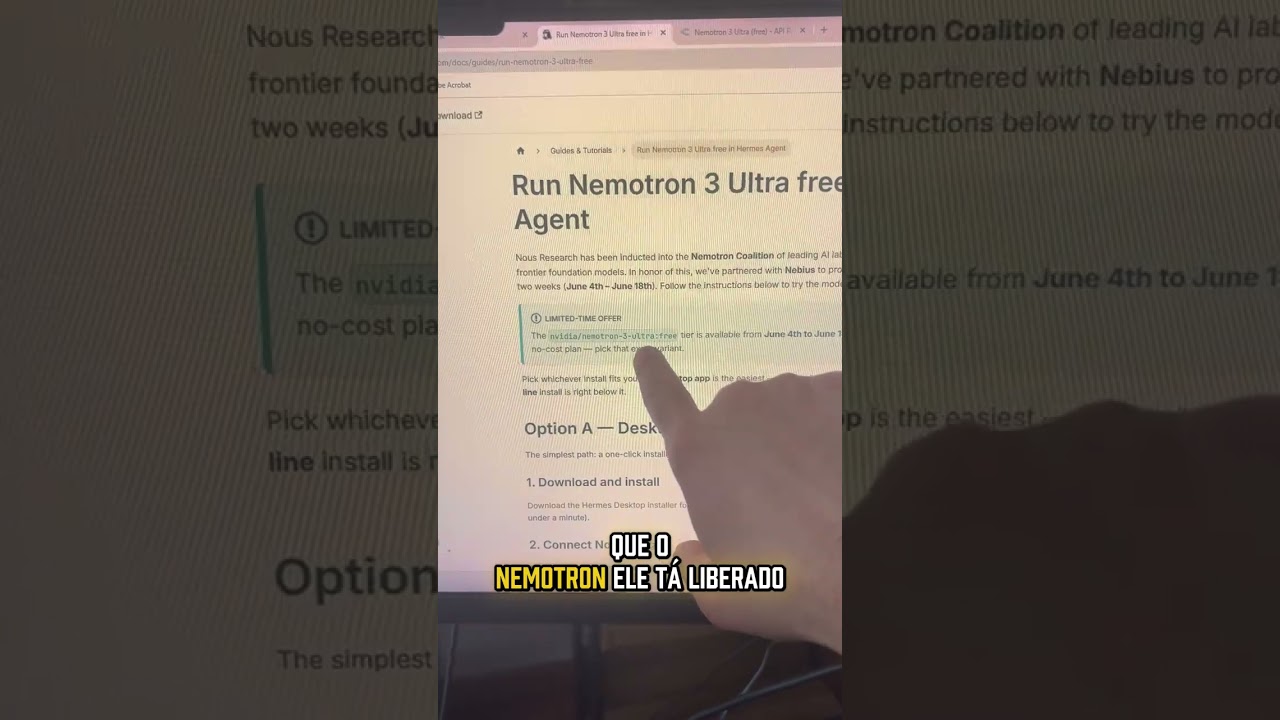
No vídeo abaixo eu mostro na tela o site oficial do Hermes com o aviso da liberação gratuita do modelo da Nvidia, e explico que o próprio site traz as instruções de setup da ferramenta
Depois de instalar o Hermes, o modelo gratuito aparece pra ser selecionado no painel do provedor, e é bem "next, next e finish" mesmo
No vídeo eu apresento o Hermes como concorrente do OpenCode, destacando auto aprendizado e segurança extrema como diferenciais, e enquadro a liberação como o que ela é: oportunidade de usar um modelo top de linha sem pagar nada
Pra quem achar a configuração complicada, eu indico lá um vídeo do próprio canal com o passo a passo do setup
Sendo transparente: eu não medi custo por tarefa nesse teste, o vídeo é sobre o acesso ao modelo gratuito
O que dá pra dizer com segurança é onde essa peça encaixa no post: modelo sem cobrança é candidato natural pros slots auxiliares do passo 2, justamente porque título de sessão e sumarização não são o lugar onde você quer pagar raciocínio caro
E modelo gratuito é uma coisa, usar o Hermes em trabalho de cliente é outra discussão, que passa pela licença e não pelo preço do token
Quando cada ajuste compensa (e quando não)
Nem todo ajuste vale pra todo tipo de tarefa, então bora separar por cenário
Sessão longa de refatoração: aqui mandam a compressão calibrada e o cache estável
É o cenário onde o input domina, então segurar o system prompt, os arquivos de contexto e a memória parados vale mais do que qualquer outra coisa
E é o cenário onde trocar de modelo no meio dói mais, porque repaga o custo total de input
Pesquisa ampla: delegação, sem dúvida
O filho lê o mundo com contexto isolado e te devolve só o resumo final, então o histórico do pai não engorda com 200 chamadas de ferramenta
Automação em one-shot: o --usage-file deixa de ser curiosidade e vira instrumento
Como o relatório sai mesmo quando a execução falha, você consegue enxergar quanto está custando o que nem terminou
Setup com muitas ferramentas MCP: Tool Search, ciente da contrapartida
Se você tem um catálogo grande e usa poucas ferramentas por sessão, adiar os schemas faz sentido
Se você tem três ferramentas e usa as três sempre, a ida e volta extra e o custo fixo por turno provavelmente comem a economia
Tarefa curta: não faz nada
Sério, o ajuste não paga o esforço
Se é uma pergunta e uma resposta, otimizar protect_first_n é passatempo, não economia 😀
Resumo e próximo passo
A ordem que eu recomendo é essa, e ela é chata de propósito:
- medir
- rotear as tarefas auxiliares pra fora do modelo caro
- calibrar contexto (compressão, arquivos injetados, memória, cache estável)
- delegar o que não precisa do histórico
Quem pula o passo 1 fica ajustando threshold no escuro e depois não sabe dizer se melhorou
O próximo passo concreto é bem simples: roda /usage e hermes insights por uma semana ANTES de mexer em qualquer coisa
Depois aplica os ajustes e roda de novo por mais uma semana
É o único jeito de saber se você economizou de verdade ou só mudou o lugar onde o token está sendo gasto…
até o próximo post!
Perguntas frequentes
O Hermes Agent é gratuito para usar?
O Hermes Agent em si é open source sob licença MIT, mantido pela Nous Research, então não tem custo de licença. O que pode gerar gasto é o provedor de modelo que você conecta a ele, e opcionalmente o Nous Portal, cujo plano Free já roda com US$ 0 e US$ 0 de crédito, usando só modelos gratuitos e limites padrão.
Preciso assinar o Nous Portal para usar o Hermes Agent?
Não, a assinatura é opcional e dá pra rodar o Hermes com o provedor de modelo que você já usa. O Nous Portal é a assinatura da Nous Research pensada pra usar junto com o Hermes, com planos Plus (US$ 20/mês, US$ 22 de crédito), Super (US$ 100/mês, US$ 110 de crédito) e Ultra (US$ 200/mês, US$ 220 de crédito), todos com 10% de bônus em créditos e acesso a mais de 200 modelos.
Por que o Hermes Agent usa o modelo caro até para gerar título de sessão?
Porque o padrão de configuração das tarefas auxiliares é auxiliary.*.provider em ‘auto’, que roteia análise de imagem, sumarização de página, screenshot, título de sessão e compressão de contexto pro mesmo modelo escolhido em hermes model. Se esse modelo é caro, todas essas tarefas paralelas saem caras junto, e é por isso que vale forçar um modelo mais barato nesses slots.
O que acontece se o modelo auxiliar configurado no Hermes Agent falhar?
O modo auto segue uma cadeia de fallback: primeiro auxiliary.<task>.fallback_chain, depois os fallback_providers ou fallback_model do modelo principal, e só por último a cadeia interna de descoberta de auxiliares do Hermes. Vale checar essa cadeia depois de configurar um modelo barato, porque sem isso a tarefa pode voltar pro modelo caro sem avisar.
Trocar de modelo no meio da conversa no Hermes Agent aumenta o custo?
Sim, em provedores com cache de prefixo, como Anthropic e OpenAI, trocar de modelo no meio da sessão reseta esse cache e repaga o custo total de input. Em sessões longas, costuma sair mais barato abrir uma sessão nova no outro modelo do que ficar alternando de um lado pro outro.
Como o Hermes Agent decide quando comprimir a conversa para economizar tokens?
Por padrão o compression.threshold é 0.50, ou seja, a compressão dispara ao atingir 50% do limite de contexto, e se você definir threshold_tokens, vale o menor valor entre a razão e o valor absoluto. Na rota Codex OAuth com gpt-5.5, esse gatilho de compressão sobe sozinho para 85%, e dá pra desativar isso com hermes config set compression.codex_gpt55_autoraise false. Separado disso existe uma rede de segurança no gateway, que dispara em 85% da janela de contexto do modelo independente da sua configuração.
Matheus Battisti

Formações

Formação Vibe Coding
Do Prompt ao Produto: Crie Software Real com IA
- 474 aulas
- 20 projetos
- 39h 27min




Blog | Mais populares
Hermes Agent é gratuito para usar em trabalho de cliente?
Hermes Agent é licenciado em MIT: uso comercial liberado sem taxa. Veja o que isso cobre, o que fica de fora e as regras para trabalho de cliente.
Como testar o Hermes Agent em ambiente controlado antes de dar acesso ao que importa?
Aprenda a testar o Hermes Agent em ambiente controlado: perfil isolado, container descartável, aprovação manual e skills sob revisão antes do acesso real.
Hermes Agent e Claude Code: onde cada um entra no fluxo de quem programa?
Hermes Agent e Claude Code fazem coisas diferentes: veja onde cada um entra no fluxo de quem programa e como a skill claude-code liga os dois.
