RAG no n8n para chatbots: aplicações práticas e benefícios reais
Descubra como implementar e alavancar o RAG no n8n para criar chatbots inteligentes e workflows avançados de busca e enriquecimento de conteúdo. Veja aplicações práticas, benefícios e dicas valiosas para transformar seu atendimento digital!

O uso de RAG (Retrieval-Augmented Generation) vem crescendo entre entusiastas e profissionais que desejam desenvolver chatbots cada vez mais eficientes e contextualizados. Integrar RAG ao n8n abre um leque de possibilidades: desde respostas precisas baseadas em grandes bases de dados, até automações avançadas de busca e enriquecimento de conteúdo para empresas, provedores de atendimento e startups digitais.
Neste artigo, você descobrirá o que é o RAG, como configurá-lo no n8n de forma simples (ideal para quem está começando), exemplos de aplicações práticas em chatbots e workflows, além de vantagens, cuidados e dicas essenciais para um uso eficiente dessa poderosa combinação. Vamos juntos explorar como o RAG no n8n pode revolucionar seu atendimento, elevar o valor das suas automações e facilitar processos de busca e interação com IA.
O que é RAG e por que usá-lo com n8n para chatbots?
O termo RAG, sigla para Retrieval-Augmented Generation, refere-se a uma abordagem híbrida onde mecanismos de busca são combinados com modelos de geração automática de texto (como grandes modelos de linguagem). Em vez de o chatbot apenas “inventar” respostas, ele recupera informações relevantes de bancos de dados, documentos, FAQs ou bases de conhecimento e utiliza essa informação para gerar respostas contextuais e precisas.
Por que usar o RAG especificamente com o n8n? O n8n é uma plataforma de automação visual poderosa e acessível, permitindo integrar várias fontes de dados e APIs sem exigir programação. Quando você une o RAG ao n8n:
- O chatbot consegue buscar e consolidar dados em tempo real, gerando respostas que vão além do básico.
- Dá para conectar o bot a documentos internos, históricos de tickets, catálogos de produtos e muito mais.
- O fluxo de trabalho pode ser personalizado para tratar diferentes situações (por exemplo: buscas, dúvidas frequentes, suporte técnico), sempre com riqueza de informações e autonomia.
Em resumo, a junção de RAG + n8n cria soluções para quem deseja dar respostas realmente inteligentes sem depender do clássico “apenas pergunte ao ChatGPT”. O usuário percebe valor imediato, e o time de atendimento ganha escalabilidade e eficiência.
Quer dominar RAG no n8n do zero ao profissional? Veja a melhor formação!
Se você gostou do potencial do RAG com n8n, vale muito a pena conhecer a Formação Agentes de IA da Hora de Codar. O treinamento é super prático e já ajudou mais de 8.100 pessoas a criarem agentes inteligentes, automatizando de projetos simples a soluções completas para empresas. Não precisa saber programar e o acesso é vitalício, com muitos bônus e projetos completos pra pôr a mão na massa. Se quiser um passo a passo direto ao ponto para dominar tanto os fundamentos quanto cases avançados com RAG, esse é um ótimo caminho!
Dê uma olhada: Formação Agentes de IA n8n – Hora de Codar

Formação Agentes de IA
Domine a criação de Agentes de IA e Venda para Empresas
- 402 aulas
- 32 projetos
- 38h 19min
Configurando workflows de RAG no n8n: do básico ao avançado
A configuração de workflows utilizando RAG no n8n pode parecer complexa em um primeiro momento, mas é totalmente possível mesmo para quem está começando. O primeiro passo é entender que existem dois módulos principais em um fluxo RAG:
-
Módulo de Recuperação: extrai informações de bases externas ou bancos vetoriais (como Pinecone ou Supabase). No n8n, você pode utilizar nodes específicos para API de banco vetorial, Google Drive, Docs, Notion, ou mesmo banco de dados SQL/NoSQL.
-
Módulo de Geração: utiliza modelos de linguagem (como OpenAI GPT ou Cohere) para sintetizar a resposta baseada nos dados recuperados.
Exemplo básico de workflow RAG:
- O usuário faz uma pergunta no chatbot.
- O fluxo n8n aciona um node de busca de informações relevantes em seu banco de dados (pode ser um arquivo, base vetorial ou planilha).
- As informações são repassadas ao modelo de IA, que gera uma resposta personalizada.
- O chatbot retorna a resposta enriquecida ao usuário.
Com prática, é possível avançar!
- Automatizar buscas multibases (ex. Docs + FAQs + APIs externas).
- Adicionar filtros de contexto, boosters de relevância e reranking automático das respostas antes do retorno ao usuário.
- Usar triggers para enviar alertas ou logs para sistemas de gestão sempre que uma dúvida não for resolvida.
Dica: O segredo está em encaixar boas fontes de informação e criar fluxos que possam evoluir facilmente quando suas bases ou necessidades crescerem.
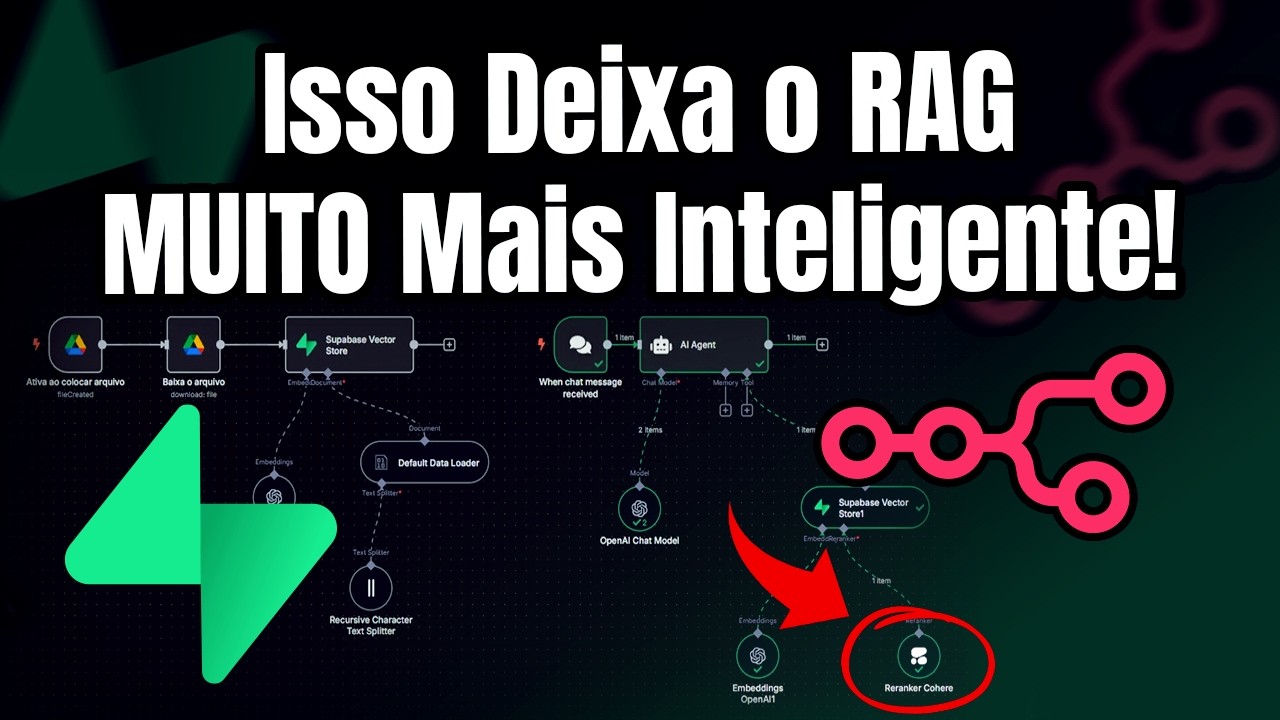
ASSIM O AGENTE RAG NUNCA ERRA! Agente de IA RAG n8n com Reranker
Se você quer ir além na construção do seu agente RAG com n8n e está buscando exemplos práticos de workflows que realmente entregam resultados, não deixe de assistir ao vídeo “ASSIM O AGENTE RAG NUNCA ERRA! Agente de IA RAG n8n com Reranker”. Lá, você vai aprender na prática como aplicar técnicas que deixam seu bot super inteligente, incluindo uso de reranker para melhorar a precisão das respostas. Confira agora para turbinar seus fluxos!
Aplicações práticas: chatbots inteligentes e respostas contextuais
A principal aplicação prática do RAG no n8n está em chatbots mais inteligentes para atendimento ao cliente, suporte técnico e assistentes internos. Com RAG, o bot não se prende apenas ao seu treinamento original: ele “consulta” informações atualizadas, documentos internos, manuais e bases de conhecimento, formulando respostas muito mais completas e precisas.
Cenários onde RAG no n8n brilha:
- FAQ dinâmico: O bot busca respostas em documentos e conjuntos de dados constantemente atualizados.
- Suporte técnico: O agente de IA consulta logs, históricos de tickets e manuais para solucionar demandas complexas.
- E-commerce: O chatbot consegue acessar catálogos de produtos, estoque ou políticas comerciais e responder dúvidas em tempo real.
Exemplo real: Imagine um fluxo de atendimento onde, ao receber a dúvida de um cliente, o n8n faz buscas em artigos técnicos e planilhas de atendimento. O RAG pega os trechos relevantes e entrega para o modelo IA formular a resposta. O usuário percebe que o atendimento é preciso, rápido e sem rodeios!
Além disso, o RAG permite:
- Agentes multi-fonte para times internos (RH, vendas, TI).
- Respostas que citam fontes, links e trechos originais, garantindo transparência.
- Atendimento proativo: bots que sugerem conteúdo baseado no perfil de interação do usuário.
Para quem quer elevar o nível do chatbot, integrar RAG no n8n é um divisor de águas.
RAG para enriquecimento de conteúdo e automação de buscas
O RAG brilha não só no atendimento ao cliente, mas também no enriquecimento de conteúdo e automação de processos de busca dentro de empresas. Imagine criar workflows que vão além do chatbot, automatizando tarefas como:
- Curadoria de documentos: O n8n pode buscar informações em PDFs, relatórios internos ou bancos de dados, sintetizando resumos ou insights sempre atualizados.
- Pesquisa interna automatizada: Times podem enviar dúvidas por chat e receber respostas baseadas na documentação corporativa ou dados de projetos, sem precisar procurar manualmente.
- Enriquecimento de conteúdo: Fluxos que recebem textos, eventos ou dados e adicionam contexto ou informações complementares vindas de múltiplas fontes.
Esses workflows tornam equipes mais produtivas, diminuem a sobrecarga operacional e liberam as pessoas para tarefas realmente estratégicas. Na prática, você pode ter desde um sistema que sugere conteúdos para treinamentos a uma busca automática por documentos necessários para um processo.
Destaque para automação de buscas: Ao conectar o n8n com integradores de bancos vetoriais e APIs externas, suas buscas podem se tornar altamente relevantes, precisas e automáticas, gerando valor real para o negócio.
Hospedando seu n8n: conheça a VPS ideal e segura para rodar projetos com RAG
Se você está pensando em rodar projetos de RAG com n8n em produção ou mesmo testar automações sem limites, a VPS da Hostinger facilita muito o processo. Além de planos acessíveis (inclusive para quem está começando), a configuração é muito fácil e rápida – praticamente tudo pronto para iniciar sem dor de cabeça. O legal é que dá pra escalar quando precisar e você tem total controle sobre o ambiente.
Vale dar uma olhada: Veja a VPS perfeita para n8n na Hostinger (use o cupom HORADECODAR para garantir desconto especial!)

Principais benefícios, desafios e boas práticas no uso do RAG no n8n
Os principais benefícios do uso de RAG no n8n são claros:
- Respostas muito mais precisas, que realmente resolvem o problema do usuário ou equipe.
- Automação de processos de busca e triagem de informação, permitindo ganhos de produtividade.
- Alto potencial de personalização e evolução dos fluxos (como integração de múltiplas fontes e estratégias de rerank).
- Facilidade para não programadores construírem soluções avançadas de atendimento e busca.
Desafios comuns incluem:
- Garantir que as fontes de dados estejam sempre atualizadas e organizadas.
- Cuidar da segurança da informação, já que o chatbot pode acessar documentos sensíveis.
- Ajustar os fluxos para não sobrecarregar o modelo de IA com dados demais (o famoso “prompt engineering” bem pensado).
Boas práticas:
- Sempre teste fluxos com exemplos reais para ajustar as respostas.
- Utilize logs e monitoramento no n8n para identificar perguntas mal respondidas e atualizar as bases.
- Prefira fluxos modulares e documentados, facilitando manutenção e evolução.
A evolução do RAG com o n8n é constante, e a chave é sempre estar atento a pain points dos usuários. Pequenas melhorias em fontes de informação ou ajustes no workflow podem tornar sua automação referência no mercado.
O que é RAG e como pode ser aplicado no n8n para chatbots?
RAG (Retrieval-Augmented Generation) é uma tecnologia que combina busca de informações em bases de dados ou documentos com geração de respostas inteligentes a partir desses dados. No n8n, o RAG pode ser aplicado para tornar chatbots capazes de buscar informações atualizadas e contextuais, oferecendo respostas mais precisas e completas aos usuários.
Como o RAG aprimora a busca de informações em chatbots no n8n?
A integração de RAG no n8n permite que chatbots consultem bancos de dados externos e tragam informações relevantes diretamente para a conversa, enriquecendo o atendimento. Isso significa que, ao invés de respostas genéricas, o chatbot utiliza a busca em tempo real para fornecer dados precisos, personalizados e contextualizados de acordo com as necessidades do usuário.
Quais são os principais benefícios do uso do RAG no n8n para enriquecimento de conteúdo?
O uso do RAG no n8n assegura que chatbots possam acessar múltiplas fontes, agregar novas informações e entregar respostas detalhadas, atualizadas e confiáveis. Isso traz vantagens como automação avançada, melhoria na experiência do usuário e redução de tempo na busca e verificação de informações importantes.
Conclusão: RAG no n8n é sinônimo de chatbots inteligentes e automação eficiente
A integração do RAG no n8n para chatbots inaugura uma nova era de automações inteligentes e respostas realmente úteis, tanto para clientes quanto para equipes. O RAG no n8n permite fluxos personalizados, respostas contextuais, buscas profundas e enriquecimento de conteúdo automatizado. Se você quiser dar o próximo passo – seja em projetos pessoais, atendimento ao cliente ou dentro da sua empresa – vale explorar ainda mais essa combinação poderosa. Aproveite as dicas, teste exemplos do artigo e explore formações e VPS que facilitam muito o processo. Sua automação pode (e deve!) ser referência em inteligência!
Por que o seu RAG responde errado (e quase nunca é culpa do modelo):
Se liga nisso, porque é o tropeço número um de quem monta o primeiro fluxo
A resposta vem torta e a reação natural é trocar o modelo de linguagem por um mais forte
Só que, na maioria das vezes, o problema não está na geração, está na RECUPERAÇÃO
O modelo só consegue responder com o que chegou até ele
Se o trecho certo do seu documento não foi encontrado na busca, nenhum modelo do mundo adivinha
Como diagnosticar em dois minutos:
Antes de olhar a resposta final, olhe o que a etapa de busca devolveu
Os trechos recuperados tinham mesmo a informação da pergunta?
Se tinham e a resposta ignorou, aí sim é problema de instrução ou de contexto entupido de dado irrelevante
Se não tinham, o problema está na base, no jeito que você fatiou os documentos ou na forma como a consulta é montada
Tome cuidado com um clássico: a versão velha do documento continua na base convivendo com a nova
O bot não sabe qual das duas é a verdade, ele responde a que a busca achou primeiro
Já me ferrei com isso, e o pior é que parece alucinação quando na real é bagunça de base 😀
Preparando a base: o passo que quase todo mundo pula
Tem gente que joga a pasta inteira de PDF no banco vetorial e espera mágica
Aí o agente responde qualquer coisa e a culpa sobra pro n8n haha
Fatiar o documento é uma decisão, não um detalhe:
O texto precisa ser quebrado em pedaços antes de virar vetor
Pedaço grande demais traz muito assunto misturado e a busca perde a pontaria
Pedaço pequeno demais corta a ideia no meio e o trecho chega sem sentido pro modelo
A analogia que ajuda: pense no índice de um livro
Você quer que cada entrada aponte pra um assunto fechado, não pra meio capítulo nem pra uma linha solta
Metadado é o que salva o filtro depois:
Guarde junto de cada trecho de onde ele veio: qual documento, qual seção, de quando é
Isso permite dois ganhos grandes: filtrar a busca só no que interessa e devolver a fonte junto da resposta
Sem metadado, o dia que a base crescer você não consegue nem descobrir de onde saiu aquela resposta esquisita
Base viva pede rotina de atualização:
Documento mudou, o trecho antigo tem que sair da base, não só entrar o novo
Se os dois ficam lá, seu chatbot fica com duas verdades e escolhe sozinho, beleza?
Como saber se o seu RAG está bom: monte um teste antes de colocar em produção
O post inteiro fala em resposta precisa, mas precisa em relação a quê?
Sem uma régua, você fica ajustando fluxo no feeling e nunca sabe se melhorou ou piorou
Monte a sua lista de perguntas reais:
Pegue perguntas que os clientes ou o time REALMENTE fazem, não perguntas bonitinhas que você inventou
Pra cada uma, escreva do lado qual é a resposta certa e em qual documento ela está
Essa listinha é o seu teste, e ela vale mais que qualquer benchmark de internet
Rode a mesma lista a cada mudança:
Mudou o tamanho do fatiamento, trocou o modelo, mexeu na instrução?
Roda a lista de novo e compara
Duas coisas pra observar separado: a busca trouxe o trecho certo, e a resposta usou o trecho certo
São problemas diferentes e o conserto é diferente também
Guarde as perguntas que o bot não resolveu:
Essa é a mina de ouro
Pergunta sem resposta boa quase sempre significa buraco na base, não burrice do modelo
Cada buraco tapado é uma resposta a menos caindo no colo do atendimento humano
O que mudou no jeito de montar RAG desde que esse artigo saiu
O fluxo que expliquei ali em cima (pergunta, busca, resposta) continua valendo e é o melhor lugar pra começar
Mas o jeito de montar amadureceu, e vale você saber pra onde a coisa foi
De fluxo fixo pra agente que DECIDE buscar:
No desenho clássico, toda pergunta dispara a busca, sempre
O problema é que "bom dia" também dispara a busca e volta trecho de manual sem necessidade
A ideia mais atual é tratar a base de conhecimento como uma ferramenta do agente
Assim ele decide quando consultar, e pode consultar mais de uma vez até juntar o que precisa
Buscar amplo e depois reordenar:
Uma etapa só de busca costuma ser suficiente no começo e insuficiente quando a base cresce
O caminho é recuperar mais trechos do que você vai usar e depois reordenar por relevância, mandando pro modelo só o topo
É exatamente a ideia por trás do reranker que aparece no vídeo lá em cima
Resposta sem fonte virou dívida:
Antes, entregar a resposta pronta bastava
Hoje, entregar a resposta com o trecho e o documento de origem é o que faz a pessoa confiar no bot
E, de quebra, é o que te deixa auditar quando a resposta vier errada
Se o seu fluxo hoje é o linear e funciona, não precisa jogar fora
Evolua por partes, uma melhoria de cada vez, medindo com aquela lista de perguntas 😉
RAG sempre vale a pena? Nem sempre:
Aqui vai o contraponto honesto, porque nem todo problema pede banco vetorial
Se a sua base é pequena, estável e cabe tranquilamente dentro da instrução do agente, montar toda a estrutura de RAG só adiciona peça pra dar manutenção
RAG começa a compensar quando aparecem estes sinais:
O conteúdo muda com frequência e você não quer editar prompt toda semana
São muitos documentos e o assunto da pergunta é imprevisível
Você precisa mostrar de onde veio a resposta
A base é grande demais pra mandar inteira em toda pergunta
Se nenhum desses bate no seu caso, comece simples
Dá pra migrar pro RAG depois, e você vai migrar com a lista de perguntas real na mão, que é MUITO melhor do que adivinhar no começo
Leia também
Matheus Battisti

Formações

Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 45min




Blog | Mais populares

Guia completo do Grok 4: Tudo sobre funcionalidades, versões e preços
Descubra neste guia completo do Grok 4 tudo o que você precisa saber para escolher, contratar e aproveitar o máximo dessa IA inovadora! Confira funcionalidades, […]

Como criar slides no NotebookLM e aposentar o PowerPoint
Aprenda a criar apresentações incríveis com o NotebookLM: slides e infográficos automáticos em poucos minutos – e aposente o PowerPoint de vez! Criar apresentações visuais […]

Planos: n8n preço para 2026 | Qual vale a pena?
O n8n possui um modelo de preço e planos flexível, baseado em execuções mensais de workflows, independentemente da complexidade. O plano Starter custa cerca de […]