
Como usar o Text Classifier no n8n para rotear antes do LLM escrever a resposta
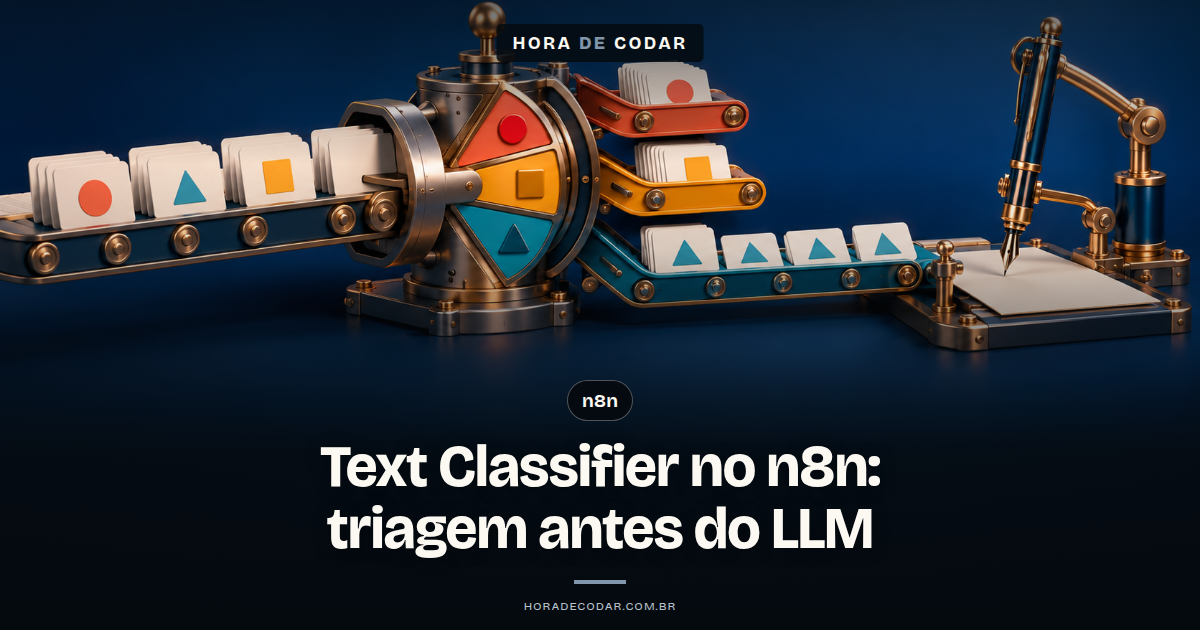
Fala aí, beleza? Se tu quer que o n8n faça triagem das mensagens antes de responder, o caminho é o Text Classifier: ele decide a categoria de cada item e abre um ramo de saída por categoria, e um Basic LLM Chain em cada ramo só escreve a resposta final 🙂
Por que separar? Porque a escolha fica explícita e roteável no canvas, dá pra ver por onde cada mensagem passou, e o modelo de chat fica só com a parte de redigir
Se liga num detalhe: o Text Classifier também usa um modelo de IA, já que ele recebe um sub-nó de Chat Model
Então a divisão aqui é de PAPÉIS (um decide, outro escreve), não de "IA vs. sem IA"
É a mesma lógica do Jev (um decide, o LLM escreve), e aqui a ideia é levar isso pra dentro de um workflow de automação
E não vou te prometer economia de token, custo ou latência, porque isso não foi medido, beleza?
O que você precisa antes de montar o fluxo
Tu precisa de três coisas pra montar a triagem, nada de PC da Nasa haha
- Um workflow com um gatilho que entregue texto: a própria documentação usa o exemplo do chat trigger, em que a mensagem chega no campo
chatInput - Uma credencial de modelo de chat: ela é configurada no sub-nó de Chat Model, e a documentação cita o OpenAI Chat Model e o Anthropic Chat Model como exemplo
- A lista das categorias de triagem: cada uma com um nome e uma descrição curta do que ela significa
Se tu quiser usar a pontuação de confiança (lá no passo 7), ela chegou no n8n 2.45
O resto do fluxo funciona com os nós descritos na documentação do Text Classifier
Formação Agentes de IA
Domine a criação de Agentes de IA e Venda para Empresas
- 402 aulas
- 32 projetos
- 38h 19min
Passo a passo: Text Classifier decide, Basic LLM Chain escreve
O exemplo é uma triagem de atendimento com três categorias didáticas: Financeiro, Suporte técnico e Urgente
A ideia é: chegou mensagem, o classificador escolhe o ramo, e cada ramo tem a sua chain com o tom certo
Bora ver na prática?
- Adicione o Text Classifier e conecte o sub-nó de Chat Model
O Text Classifier passa cada item de entrada pra um modelo, que escolhe a categoria com base na lista que você definiu
Por isso ele tem a porta Chat Model: é ali que entra o sub-nó (OpenAI Chat Model, Anthropic Chat Model e por aí vai), e é nesse sub-nó que fica a credencial
Erro comum deste passo: procurar a credencial no nó principal do Text Classifier
Ela não está lá, está no sub-nó de chat model 😉
- Configure o Input Prompt
O Input Prompt define qual texto vai ser classificado, e normalmente é uma expressão apontando pra um campo do item de entrada
Como a entrada vem do chat trigger, a expressão fica assim:
{{ $json.chatInput }}Erro comum deste passo: deixar o valor padrão, que referencia o campo text
Se a mensagem chega em chatInput, o classificador vai olhar pro campo errado
- Crie as Categories com nome e descrição
Cada categoria tem um nome e uma descrição, e cada uma vira um ramo de saída do nó
No nosso exemplo:
- Financeiro: dúvidas sobre cobrança, pagamento, nota fiscal e reembolso
- Suporte técnico: problemas de acesso, erro no sistema, configuração
- Urgente: serviço parado, risco de perder dado ou pedido explícito de prioridade
A descrição é o que explica pro modelo o que a categoria significa, e isso pesa MUITO quando o sentido não é óbvio
Erro comum deste passo: descrição vaga tipo "coisas urgentes"
Urgente pra quem? Escreve o critério, não só o rótulo
- Defina When No Clear Match como Output on Extra, ‘Other’ Branch

VPS Hostinger para seu sistema
10% OFF extraVPS com SSD NVMe e backups semanais. O cupom MATHEUSHORADECODAR é aplicado automaticamente pelo link.
Ver planos com 10% OFF →Essa opção diz o que acontece quando nenhuma categoria casa de forma clara
Com Output on Extra, ‘Other’ Branch, o nó cria um ramo separado chamado ‘Other’, e tu decide o que fazer com essas mensagens (mandar pra um humano, por exemplo)
Erro comum deste passo: manter o padrão, que é Discard Item
Nele o item ambíguo é simplesmente descartado, e a mensagem some do fluxo sem aviso nenhum… Tome cuidado!
- Decida sobre Allow Multiple Classes To Be True
Desligada, o classificador devolve uma única classe por item
Ligada, o modelo pode escolher várias, e o item sai por TODOS os ramos que casarem
Pra triagem de atendimento, em que cada mensagem deve ter um destino só, deixa desligada
Se ligar, uma mensagem que pareça Financeiro e Urgente ao mesmo tempo pode passar pelas duas chains e gerar duas respostas pro mesmo cliente
- Em cada ramo, adicione um Basic LLM Chain pra redigir
Aqui entra quem escreve
O Basic LLM Chain serve pra conversar com um LLM sem componentes adicionais, e ele também recebe um sub-nó de chat model
No Prompt, escolha Define below e monte a expressão com o texto original da mensagem
Antes de escrever a expressão, abre o painel de entrada do nó e confere em qual campo a mensagem chegou depois do classificador
Em modelos de chat, dá pra incluir uma mensagem de sistema no campo Message, e é ali que fica o tom daquele ramo
Um exemplo didático pro ramo Financeiro:
Você responde clientes sobre cobrança e pagamento.
Seja direto e cordial, explique o próximo passo que o cliente deve seguir
e não prometa reembolso nem prazo que não esteja confirmado.
O ramo Urgente ganha outra mensagem de sistema, o de Suporte técnico outra, e assim cada chain só pensa em escrever, porque a decisão já foi tomada lá atrás
Erro comum deste passo: esperar que a chain lembre o que o cliente disse antes
Os nós de chain do n8n não têm memória, então não referenciam mensagens anteriores da conversa
- Opcional: ligue Include Confidence Scores
No n8n 2.45 o Text Classifier ganhou essa opção, que vem desligada por padrão
Quando ligada, cada item roteado recebe um objeto classification com a categoria, a confiança e um mapa scores comparando as categorias
O exemplo de saída que aparece na descrição da mudança é este:
"classification": {
  "category": "Billing",
  "confidence": 0.92,
  "scores": {
    "Billing": 0.92,
    "Urgent": 0.61
  }
}
Esses números são do exemplo da documentação, não de um teste deste post
Isso é muiiito útil pra enxergar quando o modelo escolheu uma categoria "no limite"
- Opcional: ajuste o System Prompt Template e ative Enable Auto-Fixing

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.O System Prompt Template deixa você mudar o prompt de sistema da classificação, usando o placeholder {categories} pra injetar a lista de categorias
Já o Enable Auto-Fixing serve pra quando a saída do modelo sai do formato esperado: o nó manda os erros de parsing do schema pro LLM e pede a correção
Checagem final:
Manda uma mensagem de cada tipo pelo chat: uma de cobrança, uma de erro no sistema, uma de serviço parado
Confere na execução por qual ramo cada item saiu
Por fim, manda uma mensagem ambígua (tipo "oi, tudo bem?") e vê se ela caiu no ramo ‘Other’ em vez de sumir
Se caiu, a triagem está no lugar 😀
Quando trocar o Text Classifier por saída estruturada e Switch
O Text Classifier serve quando o objetivo é escolher UMA categoria (ou algumas) a partir do texto
Agora, se a decisão depende de campos extraídos, tipo valor, número do pedido ou tipo de plano, o caminho é outro: extrair os dados primeiro e rotear depois com regra
Pra extrair, o n8n tem o Information Extractor, que também é um root node de IA
Pra rotear, entra o nó Switch, que tem dois modos:
- Rules: uma regra de comparação por saída, adicionadas com Add Routing Rule
- Expression: tu define Number of Outputs e um Output Index, que é uma expressão que precisa retornar um número
E a opção Fallback Output define pra onde vão os itens que não casam com nenhuma regra, é o equivalente do ramo ‘Other’ do classificador
E o Structured Output Parser? Dá pra pensar nele como roteador, mas com cautela
A documentação do Structured Output Parser diz que ele foi feito pra estruturar a saída final, não saídas intermediárias passadas pra outras etapas de IA, então não é a escolha natural pra uma decisão no meio do fluxo
Onde ele encaixa bem é no fim: se a resposta da chain precisa ter formato fixo, tu liga Require Specific Output Format no Basic LLM Chain e conecta um parser (Auto-fixing Output Parser, Item List Output Parser ou Structured Output Parser)
No Structured Output Parser, o schema pode vir de Generate from JSON Example (que torna todos os campos obrigatórios) ou de Define using JSON Schema, que não suporta $ref
Tem também o Sentiment Analysis, outro root node de IA que pode servir de ponto de decisão quando o critério é o sentimento da mensagem
O padrão na origem: o Jev
Esse vídeo mostra o Jev, de onde vem essa ideia de dividir os papéis: um componente decide, o LLM escreve
É o mesmo raciocínio que o Text Classifier e o Basic LLM Chain aplicam aqui no n8n, só que dentro de um agente
Próximo passo: medir a triagem antes de mexer na redação
Antes de reescrever os prompts das chains, mede onde a classificação erra
Liga o Include Confidence Scores (se tu estiver no n8n 2.45 ou superior) ou usa o ramo ‘Other’ como termômetro, e anota quais mensagens caíram no ramo errado ou ficaram sem categoria
Aí ajusta primeiro as descrições das categorias, que é onde o modelo entende o critério, e só depois mexe no tom das respostas
Se o problema for decisão, nenhum prompt de redação vai salvar, né?
E se quiser ver o padrão dentro de um agente, dá o play no vídeo do Jev ali em cima
Até o próximo post! =)
Perguntas frequentes
Enable Auto-Fixing do Text Classifier é a mesma coisa que o Auto-fixing Output Parser do Basic LLM Chain?
Não, são opções diferentes com nome parecido. O Enable Auto-Fixing vive dentro do próprio Text Classifier e corrige a saída do modelo mandando os erros de parsing de volta pro LLM. Já o Auto-fixing Output Parser é um dos parsers que você conecta no Basic LLM Chain quando liga Require Specific Output Format.
Quer aprender mais sobre inteligência artificial e programação na prática? Conheça o canal Hora de Codar no YouTube e acompanhe os próximos vídeos.
Matheus Battisti

Formações
Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min




Blog | Mais populares
Guia completo do Grok 4: Tudo sobre funcionalidades, versões e preços
Descubra neste guia completo do Grok 4 tudo o que você precisa saber para escolher, contratar e aproveitar o máximo dessa IA inovadora! Confira funcionalidades, […]
Como criar slides no NotebookLM: fontes, prompts e revisão
Para criar slides no NotebookLM, adicione suas fontes e escolha Slide Deck no painel Studio. Defina público, idioma, tamanho e objetivo da apresentação. Revise fatos […]
Planos: n8n preço para 2026 | Qual vale a pena?
O n8n oferece uma Community Edition para hospedar por conta própria e planos pagos. A edição comunitária não elimina gastos com servidor, backups e manutenção. […]
