
Quando o dump do PostgreSQL não basta: como fazer recuperação pontual (PITR) com WAL na VPS
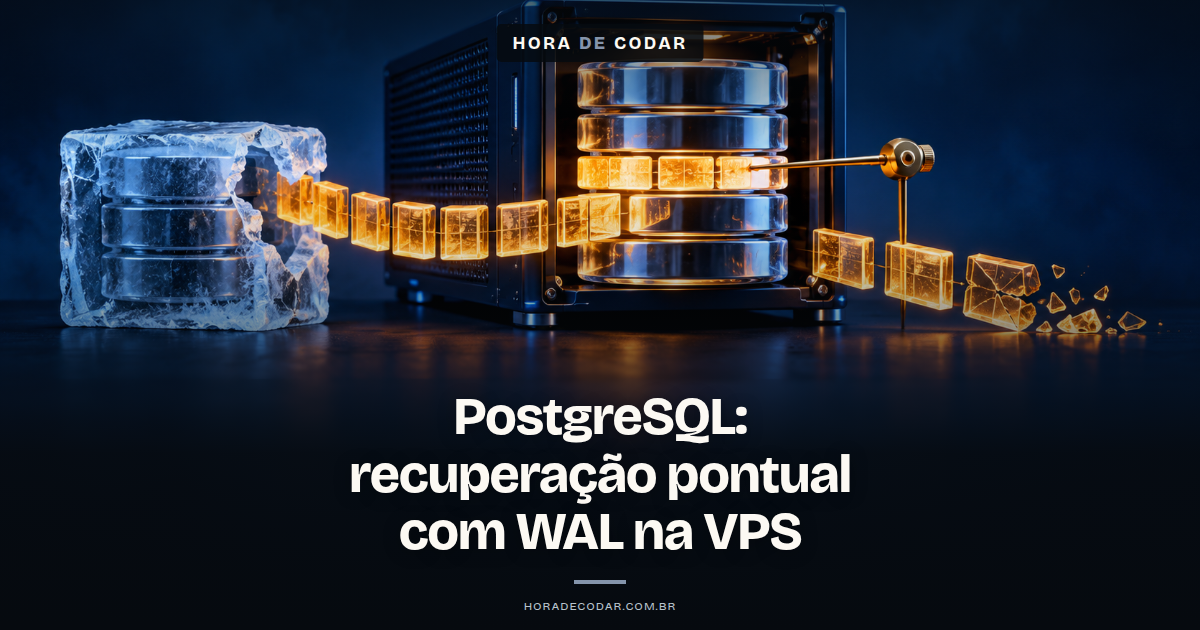
Fala aí, beleza? Se a tua aplicação roda com PostgreSQL numa VPS e o plano de backup é um dump agendado, vale entender o que acontece com tudo que foi gravado entre um dump e outro 🙂
 Hospedagem VPS
Seu projeto já pede um servidor próprio?
Tenha acesso root e SSD NVMe, com 10% OFF extra pelo link da Hora de Codar.
Ver a oferta de VPS Parceria Hora de CodarO foco aqui é o banco: PostgreSQL numa versão coberta pela documentação atual (18, 17, 16, 15 ou 14), numa VPS com acesso root, usando arquivamento de WAL pra voltar até um horário específico
Não é sobre proteger o servidor inteiro, é sobre a camada que fica dentro do banco
Dump, backup da VPS e PITR: o que cada um protege (RPO e RTO)
Cada método cobre um momento diferente
E nenhum backup do tipo "foto" cobre o intervalo entre uma foto e outra
Antes de comparar, dois termos que vão guiar a decisão:
- RPO: quanto dado você aceita perder. Se o último backup é de ontem à noite, tudo que entrou hoje está em risco
- RTO: quanto tempo leva pra aplicação voltar a funcionar depois do problema
Pensa assim: o RPO olha pra trás (até onde eu volto sem buraco?) e o RTO olha pra frente (quanto tempo fico fora do ar?)
O RTO é a mesma preocupação de quem pensa em deploy sem derrubar a aplicação: pro usuário, o que importa é que o sistema saiu do ar e quanto tempo demorou pra voltar
Agora, o que cada opção entrega:
- pg_dump: segundo a documentação do PostgreSQL sobre dumps, ele gera um dump internamente consistente, representando o banco no instante em que começou a rodar, sem bloquear leitores nem escritores: a exceção são operações que exigem lock exclusivo, como a maioria das formas de ALTER TABLE. O que mudou depois desse instante fica de fora do arquivo
- Backups automáticos da VPS Hostinger: semanais, incluídos por padrão, com o diário disponível como upgrade pago. Ficam guardados separados do servidor e cada novo backup substitui o mais antigo do mesmo tipo. Ficam retidos até quatro backups no total (dois diários e dois semanais)
- Snapshot da VPS Hostinger: manual e sob demanda. Só existe um por vez, expira em 1 dia e é apagado se você reinstalar o sistema operacional ou restaurar um backup
- Arquivamento contínuo com WAL: combina um base backup com os arquivos WAL arquivados e permite restaurar até o estado mais atual ou até um ponto no tempo
| Método | O que volta | Até que momento | Ponto de atenção |
|---|---|---|---|
| pg_dump | O banco do dump | Instante em que o pg_dump começou | Tudo que mudou depois fica fora |
| Backup automático da VPS (Hostinger) | O servidor | Data do último backup semanal (ou diário, se contratado) | Até 4 retidos (2 diários + 2 semanais); o novo substitui o mais antigo do mesmo tipo |
| Snapshot da VPS (Hostinger) | O servidor | Momento em que você criou | 1 por vez, expira em 1 dia |
| Arquivamento contínuo (PITR) | O cluster inteiro | Qualquer ponto coberto pelo WAL arquivado | Exige WAL contínuo e bastante armazenamento |
Se liga: dump e backup da VPS são fotos
O PITR é o filme que liga uma foto à outra
Quando o dump do PostgreSQL não basta
O dump deixa de bastar quando o buraco entre um dump e outro custa caro demais
Alguns cenários bem concretos:
- DELETE ou UPDATE errado no meio do dia: alguém roda um comando sem WHERE às 15h e o último dump é da madrugada. Com o dump, você volta pra madrugada e perde a tarde inteira. Com o PostgreSQL PITR, dá pra reaplicar o WAL até um horário logo antes do comando
- Aplicação com escrita constante: pedidos, cadastros, mensagens, logs de negócio. Se você publicou uma aplicação na VPS, por exemplo uma aplicação Astro com Docker, e ela grava dados o dia todo, perder o período desde o último dump pode ser inaceitável
Mas tem limite, e ele precisa entrar na decisão
O arquivamento contínuo só restaura o cluster inteiro, não uma tabela ou um banco isolado
Que cluster? É o conjunto de bancos que vive no mesmo diretório de dados de uma instalação do PostgreSQL
Ou seja, se você tem três bancos ali e quer voltar só um deles no tempo, o PITR sozinho não resolve isso
Além disso, a documentação avisa que essa técnica exige bastante armazenamento pro base backup e pro tráfego de WAL
O dump continua útil pra migração e pra copiar um banco específico de um lugar pro outro
Não é um contra o outro, são ferramentas pra problemas diferentes 😀
O que você precisa antes de configurar o PITR na VPS
Infraestrutura para o seu código
Mais controle no próximo deploy.
Configure sua aplicação em uma VPS Hostinger com acesso root. Escolha os recursos conforme o que seu projeto precisa.
- SSD NVMe
- AMD EPYC
- Backups semanais
Você precisa de controle total do servidor, de uma versão suportada do PostgreSQL e de espaço pra guardar o WAL
Indo por partes:
- VPS com acesso root: sem isso não dá pra editar o
postgresql.confnem definir oarchive_command - PostgreSQL numa versão suportada: a documentação atual cobre as versões 18, 17, 16, 15 e 14. Em todas elas a recuperação usa o
recovery.signale parâmetros direto nopostgresql.conf - Espaço pros segmentos WAL e pro base backup: cada segmento costuma ter 16MB (o tamanho pode ser alterado no initdb). De preferência, guarde isso fora do disco onde o banco roda, pra uma falha no disco não levar banco e backup juntos
- Saber onde fica o diretório de dados: o WAL mora em
pg_wal/dentro dele, e é lá que orecovery.signalvai ser criado na hora de recuperar
Pra esse projeto, a recomendação do Hora de Codar é a VPS da Hostinger (este artigo contém links de afiliado da Hostinger)
O motivo é técnico: ela entrega acesso root completo, então você instala e configura o PostgreSQL do seu jeito, incluindo archive_command e archive_timeout
Os planos usam processadores AMD EPYC e armazenamento SSD NVMe, e ainda trazem backups automáticos semanais inclusos por padrão do servidor, que entram como camada extra lá na frente
Como configurar o arquivamento de WAL e a recuperação pontual
A configuração tem duas metades: ligar o arquivamento agora e saber como recuperar depois
A referência oficial pra tudo isso é a página de arquivamento contínuo e PITR do PostgreSQL, deixa ela aberta do lado
- Habilitar o arquivamento no
postgresql.conf
São três peças: wal_level em replica (ou superior), archive_mode ligado e um archive_command (ou uma archive_library)
No archive_command, o %p vira o caminho do arquivo a arquivar (relativo ao diretório de dados) e o %f vira só o nome do arquivo
Exemplo didático, com o comando no formato de placeholder porque ele depende de onde você vai guardar os arquivos:
# postgresql.conf (exemplo didático, adapte ao seu destino)
wal_level = replica
archive_mode = on
archive_command = '<comando que copia %p para o seu destino com o nome %f e só retorna 0 se der certo>'
O erro comum deste passo: um archive_command que devolve 0 mesmo quando a cópia falhou
Quando recebe zero, o PostgreSQL considera o arquivo arquivado e pode remover ou reciclar o segmento
Resultado: a sequência de WAL quebra e você só descobre no dia em que precisar restaurar. Tome cuidado!
O comando tem que retornar zero SÓ em caso de sucesso real. Com qualquer outro status, o PostgreSQL tenta de novo periodicamente, que é exatamente o que você quer
- Definir o
archive_timeout
Por que isso importa? O archive_command só é chamado pra segmentos WAL completos
Em horário de pouco movimento, um segmento pode demorar muiiito pra encher, e enquanto isso o commit já aconteceu mas ainda não está seguro no arquivo
O archive_timeout força a troca de segmento depois do tempo definido, limitando quanto o arquivo fica atrás do tempo real (ou seja, a sua janela de perda de dados)
# postgresql.conf (exemplo didático)
archive_timeout = <cerca de 1 minuto>
A documentação considera razoável algo em torno de um minuto
O erro comum deste passo: colocar um valor curtíssimo achando que fica mais seguro

Crie sistemas com IA para vender
Prompts, modelos e checklists para criar e publicar seu sistema com IA e preparar a oferta para o primeiro cliente.
Quero o e-book gratuito Receba o livro e os bônus no seu e-mail.Cada segmento fechado antes da hora tem o mesmo tamanho de um segmento cheio, então um timeout muito curto incha o armazenamento rapidinho
- Testar o arquivamento ANTES do base backup
Pra recuperar, você precisa de uma sequência contínua de WAL arquivado que vá pelo menos até o início do base backup
Por isso a ordem é: configura o arquivamento, confere que os arquivos estão chegando no destino e só depois parte pro base backup
O erro comum deste passo: fazer o base backup primeiro e ligar o arquivamento depois
Aí fica um buraco de WAL desde o início do backup, e o backup não serve pra recuperação pontual
- Fazer o base backup em nível de sistema de arquivos
O base backup é a cópia física do cluster, o ponto de partida em cima do qual o WAL vai ser reaplicado
Existem formas diferentes de fazer essa cópia e cada uma tem os cuidados dela, então siga o procedimento da documentação oficial de backup pra sua versão em vez de copiar comando solto de fórum
- Recuperar até um ponto no tempo
Na hora do aperto, o fluxo é: restaurar o base backup, apontar de onde vem o WAL arquivado e dizer até quando reaplicar
Nas versões atualmente suportadas, isso fica no próprio postgresql.conf:
# postgresql.conf no ambiente de recuperação (exemplo didático)
restore_command = '<comando que traz os segmentos do seu arquivo de WAL de volta>'
recovery_target_time = '<data e hora logo antes do erro>'
E no diretório de dados você cria um arquivo vazio chamado recovery.signal
Com isso, o PostgreSQL restaura a partir do base backup e reaplica os registros WAL até o horário definido em recovery_target_time. Ao terminar a recuperação, o servidor remove o recovery.signal automaticamente
O erro comum deste passo: seguir tutorial desatualizado que manda criar um arquivo recovery.conf
Nas versões suportadas hoje (18, 17, 16, 15 e 14), a documentação oficial define recovery.signal + parâmetros no postgresql.conf como o caminho atual
Se o tutorial que você achou fala de recovery.conf, desconfia da data dele haha
Como validar que o seu PITR realmente recupera
Backup que nunca foi restaurado é só uma esperança com nome bonito
A validação tem três checagens:
- Os segmentos estão chegando? Acompanhe o destino do arquivo e confirme que novos arquivos WAL aparecem conforme o tempo passa, inclusive em horário de pouco tráfego (é aí que o
archive_timeoutmostra serviço) - A sequência é contínua? Confira que não existe buraco no WAL arquivado desde o início do base backup. Se faltar um segmento no meio, a recuperação não passa dele
- A restauração funciona de verdade? Faça um ensaio completo em outro ambiente: restaure o base backup, defina um
recovery_target_timenum horário que você conhece e confira se os dados batem com aquele momento
Esse ensaio entrega um bônus massa: ele mostra o RTO real do seu cenário
Você sai sabendo quanto tempo leva pra restaurar, em vez de chutar no meio de um incidente
O erro comum aqui: considerar o backup pronto só porque os arquivos estão lá, sem nunca ter feito uma restauração
Como combinar PITR com os backups e snapshots da VPS Hostinger
O jeito mais seguro é pensar em camadas, cada uma resolvendo um tipo de problema
- Backups automáticos da VPS: semanais, incluídos por padrão, com o diário como upgrade pago. Servem pra recuperar o servidor inteiro se algo der muito errado (um
rm -rfda vida, por exemplo xD) - Snapshot manual: útil antes de uma mudança arriscada no servidor, tipo atualizar o sistema ou mexer pesado na configuração
- PITR: recupera o cluster inteiro até o ponto no tempo que você escolher (lembrando: não dá pra voltar só um banco isolado)
Backups e snapshots ficam no painel da Hostinger, em VPS > Manage > Backups & Monitoring > Snapshots & Backups
Agora, se liga nos alertas:
O snapshot expira em 1 dia e é apagado se você restaurar um backup ou reinstalar o sistema operacional
E os backups da VPS seguem o ritmo semanal (ou diário, no upgrade), então continuam sendo fotos com intervalo entre elas
Por isso nenhum dos dois substitui o arquivo de WAL. E guarde esse arquivo fora do disco do banco, como falamos nos pré-requisitos
Se você ainda vai montar esse ambiente, os planos de VPS da Hostinger já trazem o backup semanal automático como primeira camada, e o acesso root deixa você montar o PITR por cima
Próximo passo: definir seu RPO e ensaiar a primeira restauração
Começa pela pergunta de negócio, não pela técnica: quanto dado essa aplicação pode perder sem virar problema?
Com essa resposta, você ajusta o archive_timeout pra caber na janela que aceita
Depois é seguir a ordem: liga o arquivamento, confirma que os segmentos chegam no destino, faz o base backup e já marca na agenda o primeiro ensaio de restauração em outro ambiente
Se ainda falta o servidor, dá pra conferir a VPS para este projeto e começar com o root e o backup semanal já disponíveis
E aí, já passou por um DELETE sem WHERE na vida? Todo mundo passa uma vez kkk
Até o próximo post!
Quer aprender mais sobre inteligência artificial e programação na prática? Conheça o canal Hora de Codar no YouTube e acompanhe os próximos vídeos.
Matheus Battisti

Formações
Formação Claude Code
Domine Claude Code do absoluto zero até o avançado
- 120 aulas
- 4 projetos
- 9h 48min





Blog | Mais populares
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação
Checklist de segurança n8n VPS pública: guia essencial para proteger sua instalação A popularidade da automação de processos com o n8n está em alta, principalmente […]
Checklist de segurança n8n VPS 2026: proteja sua automação
Confira o checklist de segurança n8n VPS 2026 e mantenha sua automação protegida. Veja práticas essenciais e atualizadas para seu servidor. Manter seu ambiente de […]
Quanto custa uma VPS? Preço atualizado 2026
Quando se fala em quanto custa uma VPS, é preciso contextualizar o tema a partir de um provedor específico, porque o preço só faz sentido […]
